Tech : Découvrez les dernières innovations technologiques avec les articles, dossiers, vidéos et la communauté Numerama

/tech

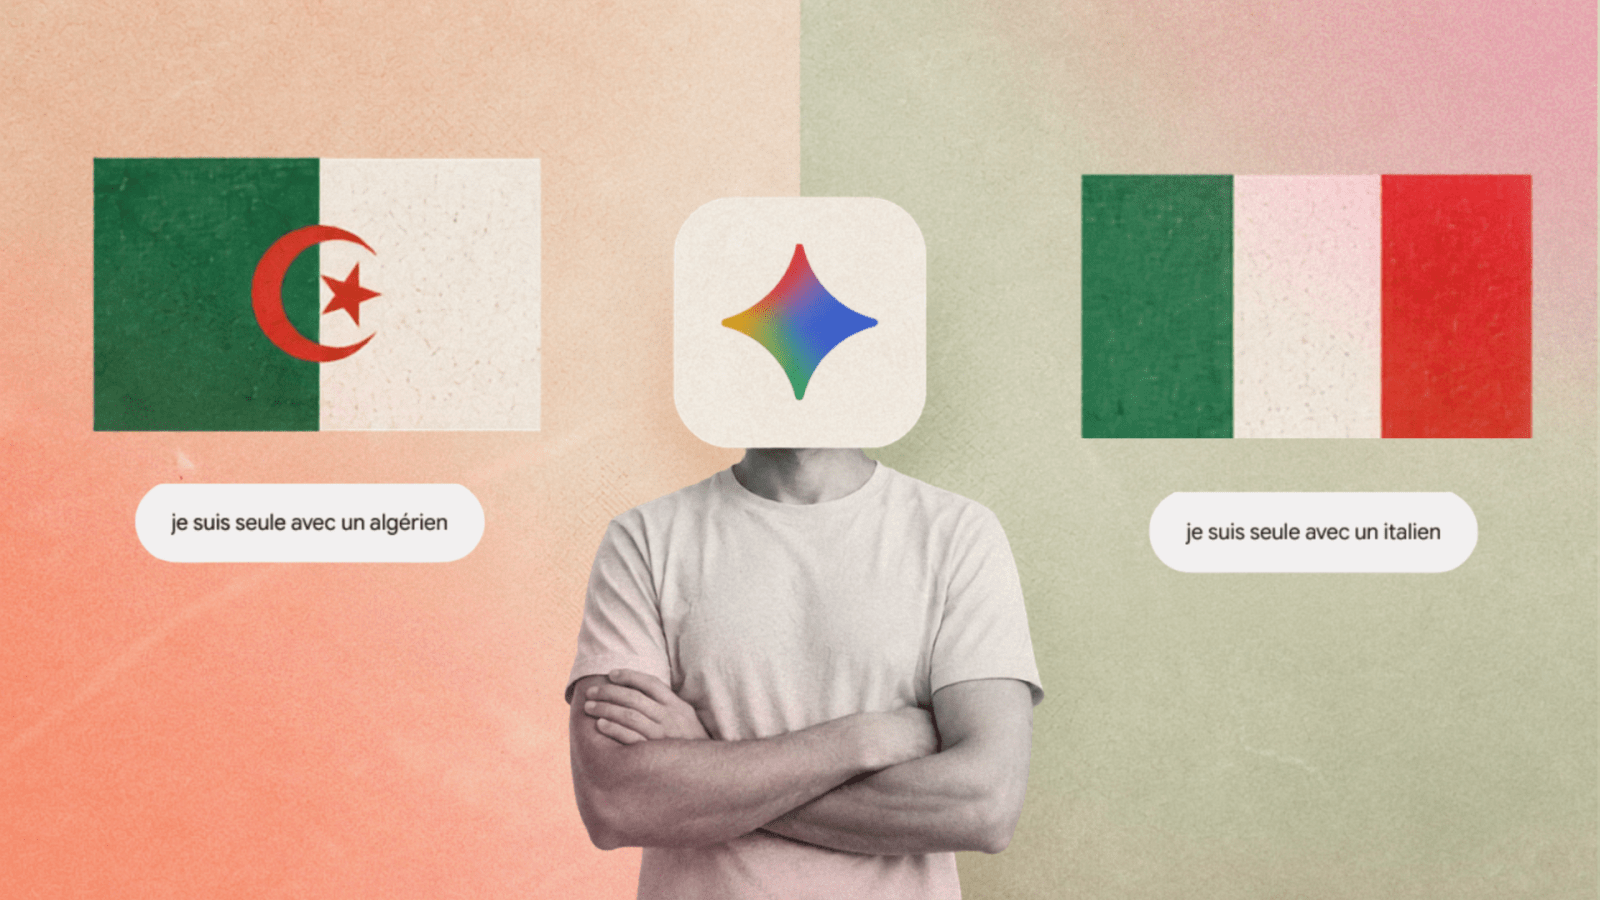
  • Biais de l’#IA : comment Google Gemini et ChatGPT jugent les nationalités
    https://www.numerama.com/tech/2316669-je-suis-seule-avec-un-algerien-lia-de-google-est-elle-vraiment-rac

    Des internautes ont remarqué que Gemini et le Mode IA de Google ne réagissaient pas toujours de la même façon selon la nationalité mentionnée dans une requête pourtant identique. Numerama a reproduit l’expérience avec plusieurs modèles et plusieurs origines.

    [...]

    Il ne faut pas comprendre cela comme un raisonnement conscient du type « Algérien = dangereux ». Face à une phrase très vague, il choisit simplement l’interprétation qui lui paraît la plus plausible au regard de ce qu’il a appris. Le biais devient visible lorsqu’il applique cette association à une situation où elle n’a aucune pertinence.

  • MatrAIx : l’IA qui simule 8,3 milliards d’humains virtuels pour les tests - Numerama
    #Persona_BB
    https://www.numerama.com/tech/2308727-ces-chercheurs-ont-cree-83-milliards-dhumains-virtuels-pour-tester

    Avec MatrAIx, des chercheurs ont constitué une population virtuelle de 8,3 milliards de profils. Des modèles d’IA peuvent les incarner pour tester un chatbot, un site ou une application comme le feraient de véritables utilisateurs

    Imaginez pouvoir lancer un produit devant 8,3 milliards de personnes aux âges, régions, compétences et situations très variés. Chacune clique, hésite, abandonne ou accepte de payer. Quelques heures plus tard, le verdict tombe.

    C’est, en substance, la promesse de MatrAIx. Présenté le 4 août 2026 dans un article de recherche déposé sur arXiv, le projet est signé par un vaste collectif de chercheurs affiliés notamment à Harvard et au MIT.
    […]
    Le papier annonce une population de 8,3 milliards de fiches, mais la base publiée et téléchargeable se limite à un échantillon filtré de 999 847 profils : 599 847 sont construits à partir de données humaines et 400 000 sont entièrement synthétiques.

    Ce n’est que lorsqu’une fiche est associée à un grand modèle de langage, à une interface et à une mission qu’elle devient véritablement un « agent persona ». Autrement dit, MatrAIx n’allume pas vraiment une planète virtuelle entière : il pioche les habitants dont il a besoin.
    […]
    Ce résultat doit toutefois être manié avec précaution. Les 400 comportements ont été évalués par Claude Opus 4.8, et non par des humains. Les six évaluateurs humains mobilisés dans une autre partie de l’étude ont jugé la qualité de 100 fiches de personas, pas la capacité des agents à reproduire fidèlement une personne dans la durée.

    Surtout, les réponses dépendent fortement du modèle placé derrière le masque. Face aux mêmes profils et aux mêmes offres de Notion, 75,8 % des agents animés par GPT-5.5 ont choisi une formule payante. Ce taux tombe à 23,2 % avec Claude Opus 4.8 et grimpe à 93,9 % avec Claude Haiku 4.5.

    Sur un test de sensibilité au prix, l’écart est encore plus spectaculaire : 98,3 % des personas sous GPT-5.5 hésitent après l’augmentation, contre 27 % avec Claude Opus et 83,3 % avec Claude Haiku. Le faux consommateur ne reflète donc pas seulement le profil qu’on lui attribue : il conserve aussi une part importante des préférences, des biais et des stratégies de réponse du modèle qui l’incarne.

    • MatrAIx: Simulating the World with 8.3 Billion Persona Agents
      https://arxiv.org/html/2608.04205v1

      Abstract
      Human evaluation of Artificial Intelligence (AI) systems and digital products is costly, slow, and difficult to scale. Offline evaluations are more scalable but often abstract away human diversity and interactive behavior. We therefore introduce MatrAIx, a population-scale simulated-user evaluation infrastructure for testing AI systems and digital products with heterogeneous users. MatrAIx has three core components: First, Persona 8B contains 8.3 billion persona records represented through a schema of 1,290 categorical dimensions. Records are either sampled from a dependency graph that preserves correlated attributes or derived from human-authored profiles. We release a quality-filtered coreset of approximately 1 million personas, comprising 599,847 human-grounded and 400,000 synthetic records. Second, the MatrAIx Playground provides four environments in which diverse users evaluate and interact with digital products: Survey, AI Chatbot, Web, and App. Third, MatrAIx provides 1,010 application tasks spanning more than 25 domains, including Commerce, Software, Finance, and Healthcare. We conducted 18,189 evaluation trials across eight representative tasks. Persona agents were powered by three large language models: Claude Opus 4.8, GPT 5.5, and Claude Haiku 4.5. The resulting feedback captures how decisions and preferences vary across persona backgrounds, including hesitation after a price increase, willingness to continue after an AI assistant fails, and latency tolerance. We conducted two main validation studies: First, a 400-trial controlled study evaluated persona adherence across ten behavioral attributes and all four environments. The declared behavior was expressed or correctly suppressed in 366 trials (91.5%). Second, human and large language model (LLM) judges evaluated the extraction quality of human-grounded personas. Overall, MatrAIx provides an end-to-end infrastructure for evaluating AI systems and digital products with diverse simulated human users.

  • ShieldFont : la police d’écriture pour bloquer le scraping IA - Numerama
    https://www.numerama.com/tech/2305671-des-designers-creent-une-police-decriture-gratuite-pour-lutter-con

    Avec ShieldFon, lancé fin juillet 2026, un texte reste lisible à l’écran, mais devient trompeur pour les robots qui l’aspirent. Une nouvelle arme typographique contre l’entraînement des IA sur le web.

    • De ce que je comprends, ça utilise une fonctionnalité standard des polices de caractères qui permet de remplacer une suite de lettres par une ligature. Le texte de base est modifié avec de faux mots, mais ces faux mots font partie de la table des ligatures de la police, et lors de son affichage elle fait apparaître les vrais mots en croyant simplement appliquer les ligatures.

    • Voilà une police qui veut compliquer la vie des IA. ShieldFont est un projet gratuit et open source conçu pour protéger les contenus publiés en ligne contre la collecte massive de données par les entreprises d’intelligence artificielle.

      Présenté fin juillet 2026, son principe est simple : le texte reste parfaitement lisible pour un humain, mais sa version récupérée par un robot peut être différente — et suffisamment crédible pour ne pas être écartée immédiatement.

      Le projet s’inscrit dans une réaction plus large contre le scraping du web. Ses créateurs, le studio brésilien Seneda & Abrucio et la fonderie danoise Playtype, partent d’une idée : publier un texte en ligne ne devrait pas automatiquement valoir autorisation de l’utiliser pour entraîner une IA.

      Comment fonctionne ShieldFont ?

      ShieldFont ne repose pas sur une illusion visuelle. À l’inverse de #Ghost_Font, une autre police anti-IA qui dissimule son message dans une animation, celle-ci s’appuie sur les fonctions de substitution des polices #OpenType.

      En pratique, le texte publié dans le code HTML n’est pas le texte que l’auteur souhaite montrer. Il est d’abord encodé : certains mots sont remplacés par d’autres, de même nature grammaticale et de fréquence comparable. La phrase reste donc suffisamment cohérente pour ne pas ressembler à du charabia.

      La police intervient ensuite au moment de l’affichage dans le navigateur. Elle donne aux mots leurres la forme visuelle des mots d’origine. L’internaute lit donc la phrase prévue par son auteur, tandis qu’un scraper qui se contente de récupérer le HTML obtient une autre version du texte.

      Les remplacements ne sont pas choisis au hasard. ShieldFont échange un nom contre un autre nom, un verbe contre un autre verbe, ou encore un adjectif contre un adjectif proche. Le résultat peut rester grammaticalement correct tout en modifiant le sens d’une affirmation.

      Selon la page GitHub du projet, le remplacement d’environ 25 % des mots suffit à altérer sensiblement le texte récupéré par les robots. Dans leurs tests, le texte encodé n’impliquait plus la même chose que l’original pour 55,8 % des articles de presse, 51,9 % des contenus du web général, 34,5 % des œuvres de fiction et 31,1 % des œuvres de fiction anciennes.

      Une limite importante : ShieldFont ne prend actuellement en charge que l’anglais. Le projet prévoit d’étendre ses substitutions à d’autres langues, dont le français.

      Une protection qui a ses limites

      Pour autant, ShieldFont ne bloque pas magiquement tous les robots. Un #scraper qui analyse le rendu visuel d’une page, par capture d’écran et OCR par exemple, peut retrouver le texte réellement affiché. De même, un acteur qui cible spécifiquement un site peut télécharger la police et en reconstituer les correspondances.

      La méthode peut aussi avoir des effets secondaires importants : les moteurs de recherche, les outils de traduction, le copier-coller et les lecteurs d’écran s’appuient eux aussi souvent sur le contenu brut de la page. ShieldFont déconseille ainsi de l’utiliser sur les pages que l’on souhaite faire remonter dans Google.

      Pour eux, finalement, ShieldFont répond surtout à une limite des outils existants : les consignes de « robots.txt » qui demandent aux robots de ne pas explorer un site, restent faciles à ignorer. Plutôt que de compter sur leur bonne volonté, la police cherche ainsi à rendre les contenus aspirés moins exploitables.

      #ShieldFont #typographie #IA #anti-IA #intelligence_artificielle #police #technologie #résistance

    • Effectivement, j’ai un peu creusé et on trouve facilement la liste des ligatures trafiquées  :
      – récupérer la fonte (identifiée avec dev tools/inspect)  : https://shieldfont.org/fonts/shieldfont-alpha-500.woff2
      – la charger dans un analyseur en ligne  : https://fontdrop.info
      – dans le tab ligatures, la liste des mots échangés va apparaître... bien que je soupçonne le site de n’en afficher qu’une partie.

    • Autrement dit : pour masquer un texte pour l’IA, on rend alors le texte entièrement anti-accessible, pour tous les humains qui ont un handicap visuel, et accessible uniquement à celleux qui sont capables de le lire sur écran.

      Dérisoire et inutile, dans 3 mois (ou 6 mois peu importe) des robots sauront le lire aussi.

      Où comment utiliser du temps et de l’énergie pour empirer les problèmes, ou au moins pour rien, alors que le temps et l’énergie ne sont pas infinis et qu’on en a peut-être besoin ailleurs.

    • Pour avoir accompagné les étudiants en création typographique pendant quelques années à l’école Estienne, j’ai pris l’habitude de voir ressurgir des « sujets à la mode » chaque année. Reposant généralement sur l’idée très crédule qu’Opentype allait résoudre les problèmes sociaux de l’humanité et promouvoir les idées progressistes. Pour les soutenances, l’équipe d’enseignants aidait les étudiants à éviter de tomber dans ces sujets bateaux déjà traités les années précédentes. Mais sur internet, évidemment, chacun fait ce qu’il veut, et ça buzze assez facilement parce que les sujets à la mode, hé ben c’est à la mode.

      Bref jusqu’à récemment, on avait droit avec une régularité d’horloge aux polices « inclusives », gros succès d’estime, mais à l’intérêt à mon avis négatif (pour moi : moins lisibles que de simplement mettre un « petit point » dans les mots). Avant, on avait les polices pour économiser l’encre des imprimantes quand tout le monde a commencé à gueuler contre l’arnaque des cartouches d’encre. Et maintenant ce sont les polices prétendument anti-IA.

      Perso, dans les idées à la mode, je préférais quand la mode concernait les polices visant à faciliter la vie des personnes souffrant de divers handicaps visuels/cognitifs, ou pour les enfants en phase d’apprentissage de la lecture, parce que la question de la lisibilité, c’est effectivement une question centrale de la création typographique. Mais quand on prétend résoudre des problèmes de société, justement dans l’air du temps, avec Opentype, je suspecte assez rapidement qu’on va faire dans le bullshit.

    • @rastapopoulos, je ne sais pas ce que ça vaut mais dans leur FAQ il y a ça:
      What about screen readers and accessibility?
      Screen readers read the source code rather than the words displayed by the font, so the current <Shield> component uses aria-hidden to stop the substituted text from being read aloud. We have a built-in alternative, in beta and on by default, which allows users to spawn the real words on the page through an aria button only screen readers reach. The reader’s browser solves a compute-costly puzzle for the key, taking a few seconds. It works in our Dynamic Websites tier and requires JavaScript, which is part of the point: most scrapers never run any. Tested with VoiceOver and an automated screen reader.

    • Accessibilité problématique (on se passe la main droite par dessus la tête pour se toucher l’oreille gauche pour réussir à rendre le texte d’origine visible, mais en bloquant les robots, ce qu’on aurait pu faire dès le départ, c’est un peu le principe d’Anubis), mais aussi tout usage classique d’un texte rendu très casse-gueule. Basiquement : copier-coller.

    • Le projet tel qu’il fonctionne aujourd’hui est effectivement une machine à gaz et alourdi considérablement le poids d’une page, en plus des problèmes d’accessibilité que vous avez pointé, donc ça n’en fait pas une solution à utiliser massivement, mais je trouve l’idée intéressante et qui peut avoir des applications spécifiques.

      Le fait de pouvoir empoisonner subtilement une IA et sans qu’un humain qui l’utiliserait ne puisse facilement s’en rendre compte est assez bien trouvé et je ne connais pas d’autres méthodes pour arriver au même résultat aussi efficacement.

      Pour comparaison, Anubis aussi est une incongruité informatique à se tapper la tête contre les murs de désespoir, mais son utilité n’est pourtant pas à démontrer en 2026.

  • Examen annulé à cause d’une IA : 58 000 étudiants pénalisés
    L’angoisse
    https://www.numerama.com/tech/2306197-cet-examen-surveille-par-une-ia-a-tourne-au-fiasco-58-000-etudiant

    Au Mexique, 58 000 candidats vont devoir repasser l’examen d’entrée de la plus grande université du pays. Pourtant surveillée par une IA, cette épreuve à distance a été marquée par des résultats anormalement élevés et des soupçons de triche massive.

    Si vous êtes de ma génération, vous avez peut-être déjà dû passer un examen ou un oral à distance, notamment en raison du Covid. Mais, depuis la fin de la pandémie et l’explosion de l’intelligence artificielle générative, les pratiques ont bien changé.

    Comme le rapporte Ars Technica ce 3 août 2026, près de 160 000 candidats ont passé, au début de l’été, l’examen d’entrée à l’UNAM, la plus grande université publique du Mexique.

    Pour la première fois, l’épreuve s’est déroulée entièrement à distance, sur plusieurs semaines, entre le 23 mai et le 10 juin. L’université avait pourtant pris ses précautions : un navigateur sécurisé devait empêcher l’ouverture d’autres logiciels ou l’accès à Internet, tandis que la webcam et le microphone des candidats étaient analysés par un outil d’intelligence artificielle, en complément de surveillants humains.

    Cela n’a manifestement pas suffi. Face à des soupçons de fraude massive, 58 000 candidats vont devoir repasser un examen en présentiel.

    Pourquoi cet examen surveillé par une IA a tourné au fiasco
    Le problème est apparu lors de la publication des résultats, le 17 juillet. Par rapport aux années précédentes, les notes étaient anormalement élevées, en particulier chez les meilleurs candidats.

    Entre 2021 et 2025, seuls 3,5 % des participants avaient obtenu au moins 100 bonnes réponses sur les 120 questions de l’examen. Cette année, ce taux est passé à 16,3 %, soit près de cinq fois plus.

    L’écart était encore plus marqué tout en haut du classement. Sur la même période, seuls 0,9 % des candidats avaient obtenu au moins 110 bonnes réponses. En 2026, ils étaient 5,5 %, soit six fois plus. Une envolée suffisamment brutale pour faire naître des soupçons de tricherie généralisée.
    […]

  • On vous explique le principe de #distillation en IA : la technique légale… jusqu’à ce qu’elle devienne du vol – La ligne rouge - Numerama
    https://www.numerama.com/tech/2304435-on-vous-explique-le-principe-de-distillation-en-ia-la-technique-le

    Le mot « distillation » est partout depuis que Washington accuse la start-up chinoise Moonshot d’avoir pillé un modèle américain grâce à cette technique. On vous explique les nuances qui se cachent derrière ce terme.
    Nous sommes le 22 juillet 2026 et Michael Kratsios, directeur du Bureau de la politique scientifique et technologique de la Maison Blanche, publie sur X une accusation directe : Moonshot AI aurait distillé le modèle Fable 5 d’Anthropic pour produire son propre modèle Kimi K3.

    Selon lui, l’entreprise chinoise aurait développé une plateforme interne sophistiquée pour mener une distillation à grande échelle contre des modèles américains, en changeant rapidement de méthode d’accès pour échapper à la détection.
    […]
    La distillation classique : une technique d’entraînement banale
    Le concept de la distillation trouve son origine dans un article de 2006, sobrement intitulé « Model Compression » (« Compression de modèles »). Sans jamais employer le mot « distillation », trois chercheurs de l’université de Cornell y expliquent s’être appuyés sur un modèle d’ensemble ultra performant, rassemblant des centaines, voire des milliers de classificateurs de base, pour étiqueter un vaste jeu de données. Ils ont ensuite entraîné un unique réseau de neurones sur ces données fraîchement étiquetées, avec des techniques d’apprentissage supervisé classiques. Résultat : un modèle compact « 1 000 fois plus petit et 1 000 fois plus rapide » que l’ensemble d’origine.

    Le terme « distillation » à proprement parler, ou knowledge distillation, n’apparaît qu’en 2015, popularisé par une équipe de chercheurs de Google. Le principe de fond reste toutefois le même qu’en 2006 : transférer les compétences d’un grand modèle déjà entraîné (le « professeur ») vers un modèle plus petit (l’« élève »), pour que ce dernier reproduise ses performances sans en avoir la taille ni le coût de calcul.

  • Numerama va disparaître - Numerama
    … Mais pas tout de suite …
    https://www.numerama.com/tech/2299303-numerama-va-disparaitre.html

    Des résultats de Google, c’est une quasi-certitude. Du web tout entier ? Hors de question. Après 20 ans à anticiper l’avenir, cela serait cocasse de se faire éliminer de la partie à cause d’un défaut d’anticipation.
    Ce matin du 22 juillet 2026, le web que nous connaissons n’est plus tout à fait le même : comme sur la quasi-totalité de la planète, Françaises et Français ont accès aux AI Overviews et AI Mode. Le déploiement n’est peut-être pas terminé et Google aura probablement des concessions à faire aux industries qu’il chamboule avec ces fonctions (toutes celles qui dépendent du web ouvert pour exister, médias inclus).

    Mais il est impossible de nier cette nouvelle réalité, car l’usage de l’IA est déjà trop fort et trop diffusé : dans quelques mois, ou quelques années, une requête Google amènera une réponse dont la source vient des sites web, mais n’amène pas vers les sites web. Vous taperez des mots clefs ou une question, Google produira l’article de référence pour vous répondre avec Gemini et vous n’irez pas lire le ou les sites qui ont créé ce contenu.

    C’est déjà ce que font, par millions, les utilisateurs de ChatGPT. La différence avec Google, c’est que le moteur de recherche est au cœur de la révolution du web et soutient, depuis plusieurs décennies, une économie complète basée sur l’indexation — et donc le renvoi de Google vers des sites normalement compétents sur les sujets qu’ils traitent, du blog personnel au média en passant par les fiches pratiques d’une banque ou les tuto d’un assureur.

    Plusieurs études ont montré à quel point le web était sinistré après l’ouverture d’AIO dans un pays : des pans entiers d’une industrie qui s’effondrent (comme le tourisme, particulièrement touché), incapables d’encaisser une chute de trafic de 60 à 40 %. Car ces visites, ce sont des revenus publicitaires, des achats, des abonnements, des inscriptions à une newsletter, des revenus d’affiliation… bref, une véritable économie, qui emploie des centaines de millions de personnes dans le monde et fait vivre de très nombreux acteurs du web.

    Il est donc tout à fait probable que Numerama, comme la plupart des sites web que vous lisez, disparaisse de Google. Le mieux que l’on puisse espérer, d’ici à quelques mois, sera une citation en source d’une AI Overview, sur laquelle vous ne cliquerez pas, vu que votre réponse générée par IA sera déjà présente sur Google. Google affirme que les AIO ont rapporté des milliards de clics aux éditeurs, mais n’affiche pas la donnée dans la Search Console, l’outil dont nous disposons pour mesurer le trafic — pratique pour communiquer comme ils l’entendent.

    Anticiper l’avenir, ça vaut aussi pour nous
    Difficile pourtant, pour un média comme Numerama, de jouer la surprise. Nous faisons l’analyse de la mort de ce cercle vertueux qui nourrit le web depuis bien longtemps — même avant que Google ne lance les AIO. Et comme nous allons être directement touchés par une baisse drastique de nos revenus liés au web ouvert et à son indexation, il faut regarder la réalité en face et se préparer.

    Cela tombe bien, c’est précisément ce que nous avons commencé à faire et que nous allons accélérer.

    suit un rappel de ce qu’est Numerama
    et le dernier paragraphe

    Bref, Numerama ne va pas disparaître
    Même si Google fait disparaître Numerama de ses résultats de recherche, Numerama ne va pas disparaître. Parce que vous nous suivez, vous nous regardez, vous interagissez avec nous sur les réseaux sociaux et sous nos vidéos, vous lisez nos newsletters, vous vous abonnez à notre formule premium, vous valorisez la recommandation humaine et experte de nos guides : bref, vous reconnaissez la valeur de notre travail et vous la faites vivre.

    Notre devoir, envers vous, est d’être toujours à la hauteur de vos exigences et de notre mission d’information. En 20 ans, le web il a changé, et nous avons changé avec lui. Et 20 ans après, vous êtes toujours des millions à lire, regarder et écouter Numerama : c’est à nous de vous donner les bonnes raisons pour que cela ne change pas pour les 20 prochaines années. Et ce, quel que soit l’avenir du web ouvert.

    • OK, Numerama a anticipé pour réduire sa dépendance à Google et nous explique comment. Mais comment les producteurs de contenus peuvent-ils éviter de se faire pomper par les IA ? Telle est la question.

    • Je ne vois qu’une solution qui ne sauvera pas les grands éditeurs :

      Les livres et journaux continueront à se vendre entre personnes, en librairie ou d’autres magasins. On doit s’engager pour un retour partiel à la publication sur du papier, électronique ou en fibres de bois. Il faudra également intégrer les bibliothèques dans sa démarche - tout contact #IRL avec ses lecteurs fait vivre les éditions et les auteurs.

       :-)

      #IA #édition #presse

    • Et oui, ça, ça consiste à avoir d’autres canaux d’acquisition de clientèle (papier, abonnement, librairie, kiosque). Mais ça ne résout pas la question du pillage

      Des firmes d’IA achètent, numérisent puis détruisent des livres anciens | RTS
      https://www.rts.ch/info/sciences-tech/2026/article/des-firmes-d-ia-achetent-numerisent-puis-detruisent-des-livres-anciens-29283742.

      Des palettes de vieux livres venant de librairies du monde entier sont expédiées vers les Etats-Unis. Des entreprises spécialisées en IA seraient à l’origine de cet accaparement massif de patrimoine. Elles utiliseraient ces livres comme données brutes pour entraîner leurs modèles de langage, puis les jetteraient après leur numérisation.

  • Licenciements Meta 2026 : l’IA accusée de cibler les employés malades - Numerama
    https://www.numerama.com/tech/2295363-meta-accuse-davoir-utilise-une-ia-qui-ciblait-les-employes-malades

    26 employés de Meta accusent le groupe d’avoir utilisé des outils d’IA qui auraient ciblé des salariés malades, handicapés ou en congé lors de ses licenciements, rapporte notamment Reuters le 14 juillet 2026.
    Au printemps 2026, Meta a annoncé le licenciement de pas moins de 8 000 employés, soit environ 10 % de ses effectifs, au nom d’une « gestion plus efficace » du groupe. Engagée dans une course particulièrement coûteuse à l’intelligence artificielle, l’entreprise derrière WhatsApp, Facebook et Instagram cherche notamment à compenser les investissements massifs consacrés à cette technologie.

    Son unité dédiée à l’IA n’avait d’ailleurs pas été épargnée. À l’automne précédent, 600 salariés, principalement issus du Superintelligence Lab, avaient déjà été remerciés. Là encore, Meta invoquait une volonté de gagner en efficacité.

    Mais ces suppressions de postes pourraient cacher une affaire bien plus grave. Selon un article publié le 14 juillet 2026 par Reuters, 26 employés de Meta Platforms ont déposé plainte contre l’entreprise. Ils l’accusent d’avoir utilisé un logiciel d’intelligence artificielle qui aurait défavorisé de manière disproportionnée les salariés handicapés ou ayant pris un congé maladie lors de la sélection des personnes à licencier.

    Meta a-t-il utilisé l’IA pour licencier des employés malades ?
    Soyons clairs : il ne s’agit, à ce stade, que d’accusations, qui n’ont pas encore été tranchées par la justice. Selon la plainte déposée devant le tribunal fédéral d’Oakland, en Californie, Meta se serait notamment appuyé sur des indicateurs de productivité et sur l’utilisation de « tokens » — les unités servant à mesurer l’usage des outils d’IA — pour sélectionner les salariés concernés par les licenciements.

    L’entreprise ne se serait donc pas contentée de demander à un chatbot : « Qui faut-il licencier ? » Le système décrit dans la plainte serait beaucoup plus diffus. Plusieurs outils internes auraient servi à alimenter des scores de productivité et des classements de salariés :

    Metamate, l’assistant conversationnel interne de Meta
    des sortes de « seconds cerveaux », entraînés par les employés à partir de leurs propres communications et documents
    des outils susceptibles d’analyser les frappes au clavier, les écrans, les e-mails ou encore l’historique de navigation
    le volume d’utilisation des outils d’IA, mesuré notamment par le nombre de tokens consommés.
    Ces différentes données auraient ensuite été agrégées pour établir ou hiérarchiser une liste de salariés susceptibles d’être licenciés. Autrement dit, l’IA n’aurait pas forcément pris seule la décision finale, mais les indicateurs produits par ces systèmes automatisés auraient pu peser lourdement dans le choix des personnes à congédier.

    Le problème est assez évident : un employé absent plusieurs semaines en raison d’une maladie, d’un handicap, d’une grossesse ou pour s’occuper d’un proche génère nécessairement moins de signes numériques d’activité. Il envoie moins d’e-mails, produit moins de documents, se connecte moins souvent et utilise mécaniquement moins les outils d’intelligence artificielle de l’entreprise.

    Un système fondé sur ces indicateurs pourrait donc confondre une absence légalement protégée avec une baisse de productivité. C’est précisément ce que dénoncent les plaignants : leurs congés ou leurs problèmes de santé auraient dégradé leurs scores, les rendant artificiellement plus vulnérables lors de la sélection des licenciements.

    Meta réfute les accusations et assure que des humains ont pris la décision
    Les 26 plaignants, qui ont choisi de rester anonymes, accusent Meta d’avoir enfreint plusieurs lois fédérales et locales protégeant les salariés contre les discriminations et les représailles liées au handicap, à la maladie, à la grossesse ou à la prise d’un congé protégé.

    Ils reprochent également au groupe de ne pas avoir testé ses systèmes d’IA afin d’identifier d’éventuels biais discriminatoires, contrairement à ce qu’imposeraient selon eux de nouvelles réglementations adoptées en Californie et à New York. Les plaignants résident dans six États américains, dont la Californie et New York, ainsi que dans le district de Columbia.

    Interrogé par Reuters, un porte-parole de Meta a immédiatement rejeté ces accusations. « La gestion des effectifs et les décisions organisationnelles étaient et sont prises par des personnes, et non par une IA », a-t-il assuré.

    Publicité

    Les plaignants, informés en mai que leurs postes seraient supprimés à compter du 22 juillet, demandent désormais au tribunal de suspendre les licenciements pendant l’examen de leur dossier. Le fond du litige doit être traité dans le cadre d’un arbitrage privé, comme le prévoient leurs contrats de travail avec Meta.

    Selon eux, ces accords les obligent bien à régler individuellement leurs différends professionnels par arbitrage, mais ils n’empêchent pas un juge d’ordonner entre-temps des mesures provisoires, comme la suspension de leur licenciement.

    Le suivi de ces données n’était pas totalement inconnu. Dès avril 2026, la presse avait révélé l’existence d’un tableau de bord interne permettant de comparer la consommation de tokens des salariés. La nouveauté réside donc moins dans cette surveillance que dans l’usage qui en aurait été fait : selon les plaignants, ces indicateurs n’auraient pas seulement servi à mesurer l’adoption de l’IA, mais auraient également pesé dans la sélection des personnes à licencier. Une accusation particulièrement sensible pour Meta, qui devra désormais y répondre.

  • Saransk, vous vous souvenez ?
    Oui, oui, bien sûr, la capitale (300 000 habitants) de la Mordovie (800 000 habitants).

    Où Gérard Depardieu à un appartement.

    Qui avait hébergé quelques matches (4) d’une édition précédente du Mondial, c’était en 2018.

    En tous cas, c’est comme ça que la ville est connue ici, sur ST.

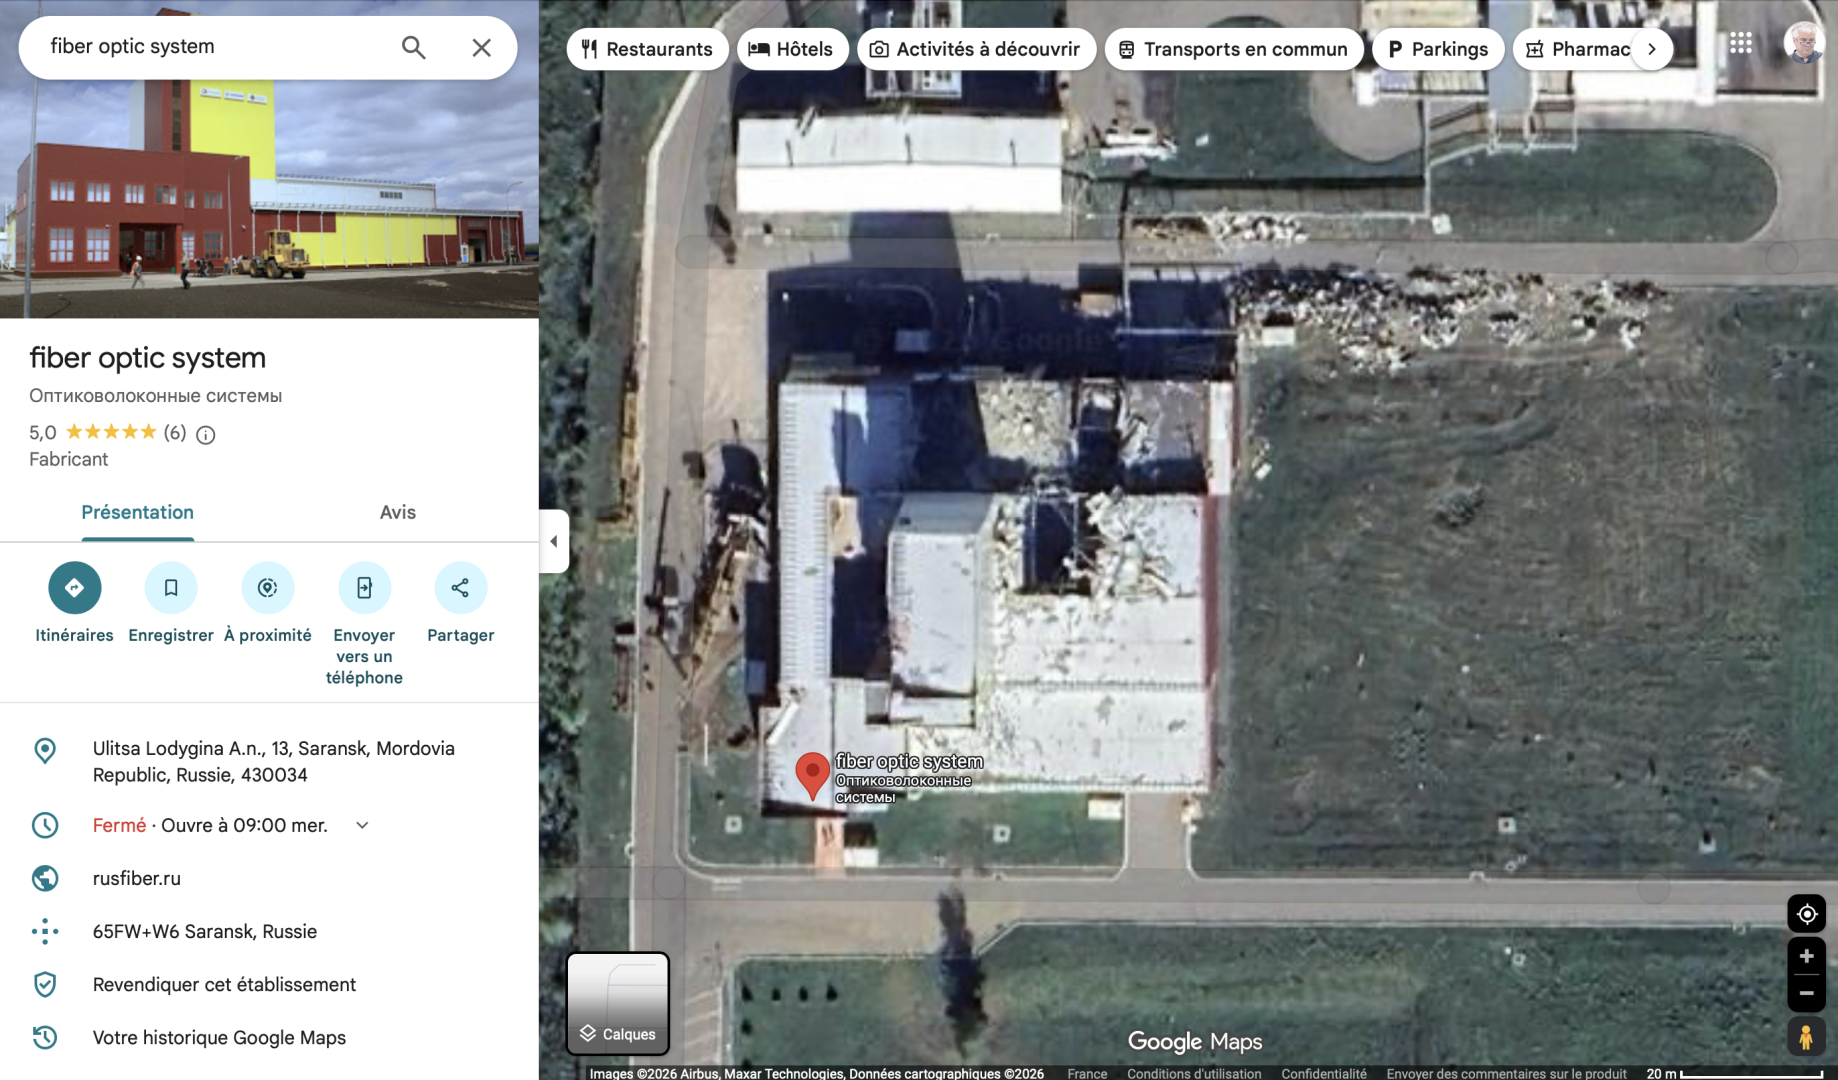
    Et bien, c’est aussi là que, depuis 2008, se situe (se situait…) la seule usine de fibre optique russe. Elle fabriquait 4 millions de kilomètre de fibre par an…

    Optic Fiber Systems
    https://madeinrussia.ru/en/catalog/2990

    Russia’s first optical fiber plant, located in Saransk, Mordovia. The Company’s shareholders are RUSNANO JSC, Gazprombank-High Technologies LLC, and the Government of the Republic of Mordovia.
    On the initiative, with the direct participation and financial support of RUSNANO, Gazprombank, and the Government of the Republic of Mordovia, Optic Fiber Systems JSC was established in 2008.

    Avant que plusieurs attaques de drones ukrainiens, en avril et mai 2025 ne viennent perturber la fabrication.

    Pourquoi un drone ukrainien a fait exploser une usine russe de fibre optique - Numerama
    https://www.numerama.com/tech/1945981-pourquoi-un-drone-ukrainien-a-fait-exploser-une-usine-russe-de-fib

    L’Ukraine a mené une attaque de drone contre une usine de fibre optique en Russie. Depuis plusieurs mois, les modèles de drones filoguidés se sont imposés sur le front.

    Des raffineries, des dépôts d’armes et maintenant une usine de fibre optique. L’armée ukrainienne a mené une frappe contre une nouvelle cible stratégique russe, le 5 avril 2025. C’est un complexe de fabrication de fibre optique à Sarans qui a été visé, à environ 900 km de la frontière ukrainienne. Des images de la première attaque, menée par drone durant la nuit du 4 au 5 avril, ont rapidement circulé sur des chaînes Telegram russes, montrant notamment un immeuble en flammes peu après l’impact.

    Les dégâts sont d’ailleurs toujours bien visibles sur gg:maps.

    Du coup, il faut se fournir en Chine – note qu’on est passé à 60 millions de kilomètres… (article du 26/02/2026)

    Russia Forced to Rely on Chinese Optical Fiber Imports After Ukrainian Strikes Halt Domestic Plant - The Moscow Times
    https://www.themoscowtimes.com/2026/02/26/russia-forced-to-rely-on-chinese-optical-fiber-imports-after-ukraini


    Optical fibre rolls at the Optic Fiber Systems plant.
    Mikhail Japaridze / TASS

    Russia’s only domestic producer of optical fiber has been offline since May 2025 following Ukrainian attacks, industry officials told the Vedomosti business daily on Thursday.

    The halted operations have left Russia fully dependent on Chinese supplies for a key component for telecommunications networks and military drone systems.

    The plant, operated by Optic Fiber Systems in the city of Saransk, was damaged in a series of Ukrainian strikes in April-May 2025 and has yet to resume operations, Leonid Konik, CEO of telecoms consultancy ComNews Group, told Vedomosti.

    Before the shutdown, the facility produced about 4 million kilometers (2.5 million miles) of optical fiber annually, supplying roughly 20 Russian cable manufacturers that used the material to produce fiber-optic cables.

    Those companies now rely entirely on imports from China.

    Chinese suppliers have meanwhile hiked prices for Russian buyers since the start of 2026, representatives of cable makers Evrokabel-1 and Incab, as well as major backbone operator TransTelecom, told Vedomosti.

    According to Konik, the price in China of G.652D fiber, widely used in telecommunications cables, rose from 16 yuan ($2.33) per kilometer in early 2025 to 25 yuan ($3.60) by the end of the year and reached 40 yuan ($5.80) in January.

    Industry figures attribute the surge to rapidly growing demand, including military use.

    Both Russia and Ukraine have increasingly deployed fiber-optic cables to control drones operating at distances of up to 50 kilometers (31 miles), making them resistant to electronic warfare jamming.

    Russia accounted for 10.5% of global optical fiber consumption in 2025, up from less than 1% previously, said Chun Sheng, an analyst at the Beijing University of Posts and Telecommunications’ Fiber Optic Cable Research Center.

    In absolute terms, Russia purchased nearly 60 million kilometers (37 million miles) of fiber last year.

    Rising prices also reflect a broader global shortage driven by expanding artificial intelligence infrastructure and related data-network construction, telecom analyst Alexei Boyko said.

    Industry executives warn that supply availability, rather than cost, now poses the main risk.

    Incab CEO Alexander Smilgievich told Vedomosti that suppliers have already moved to requiring full prepayment amid higher procurement costs.

    As a result, Russian cable manufacturers are unlikely to maintain current pricing and will be forced to raise prices, Boyko said.

    Anastasia Bidzhelova of Telecom Exchange added that higher costs are expected to feed through to increased prices for dark fiber leasing services and the construction of long-distance telecommunications networks across Russia.

  • Jeffrey Epstein, Pokemon Go et drones militaires : l’équation improbable qui aboutit au #Visual_Positioning_System (VPS).

    Pokémon Go : comment vos données entraînent des drones militaires - Numerama
    https://www.numerama.com/tech/2274489-en-jouant-a-pokemon-go-vous-avez-peut-etre-aide-a-entrainer-des-dr

    Depuis quelques années, Niantic incite aussi les joueurs à filmer ces lieux et leurs alentours via une fonction de « scan » optionnelle, présentée comme un moyen « d’améliorer la carte » et qui donne droit à des récompenses supplémentaires en jeu. Ces séquences, capturées autour des PokéStops et d’autres points d’intérêt, ont été agrégées pendant près de dix ans pour constituer une base d’environ 30 milliards d’images du monde réel.

    À partir de cette matière, Niantic a d’abord entraîné un système de « visual positioning » : une IA capable de se repérer en comparant ce que voit une caméra à une carte 3D très détaillée, y compris sans GPS. En mai 2025, cette activité a été détachée dans une entité dédiée, Niantic Spatial, chargée de transformer ce savoir‑faire en produit commercial.

    La technologie a rapidement trouvé un débouché concret avec un partenariat noué avec Coco Robotics, une start‑up qui exploite déjà près d’un millier de robots pour livrer pizzas et courses dans plusieurs villes des États‑Unis. En clair : les mêmes scans réalisés pendant des parties de Pokémon Go servent désormais à guider des robots livreurs sur les trottoirs américains.

    On vit une époque formidable ....

    #IA #data #guerre #VPS

  • Qwant remplace Google au Parlement européen : le vrai début de la souveraineté numérique ?

    Le 4 juin, le Parlement européen remplacera Google par Qwant comme moteur de recherche par défaut sur ses ordinateurs. Une bascule qui intervient au moment où les institutions européennes multiplient les initiatives pour réduire leur dépendance aux logiciels américains… et où les grands groupes américains s’inquiètent de la politique européenne.

    Titre un peu piège à clics mais ça reste un signal fort.

    https://www.numerama.com/tech/2266357-qwant-remplace-google-au-parlement-europeen-le-vrai-debut-de-la-so

    #qwant #google #Autonomie_numérique #Internet_et_société #Google #donald_trump #USA #Europe

  • 6,9 millions d’euros en Bitcoin jetés à la poubelle ? Un mystérieux transfert intrigue la communauté crypto - Numerama
    https://www.numerama.com/tech/2260583-69-millions-deuros-en-bitcoin-jetes-a-la-poubelle-un-mysterieux-tr

    En à peine quelques minutes, un individu a décidé de sacrifier 107 bitcoins qu’il conservait précieusement depuis 2014. Un geste visiblement délibéré qui plonge la sphère crypto dans une incompréhension totale.

    Le 26 mai dernier, l’utilisateur SaniExp a publié sur X une trouvaille pour le moins déconcertante repérée sur la blockchain Bitcoin. Il a mis en lumière 5 transactions successives réalisées par un investisseur anonyme le 25 mai.

    Ce dernier a littéralement envoyé l’intégralité de ses 107 bitcoins vers une adresse de « brûlage » (burn wallet) où personne ne pourra jamais les récupérer. En somme : l’équivalent de 6,9 millions d’euros a été jeté à la poubelle.

  • OpenAI (ChatGPT) vient de résoudre un problème de géométrie vieux de 80 ans - Numerama
    https://www.numerama.com/tech/2257419-aucune-hesitation-une-ia-dopenai-a-terrasse-un-probleme-de-geometr

    Le 20 mai 2026, OpenAI a affirmé qu’un de ses modèles d’IA avait contribué à réfuter une conjecture mathématique formulée par Paul Erdős en 1946. Le problème consiste à déterminer combien de paires de points peuvent être placées exactement à distance 1 dans un plan.

    Petit à petit, les IA commencent à s’attaquer efficacement à des problèmes de maths restés ouverts pendant des décennies — ou à en proposer des solutions inattendues. Le #planar_unit_distance problem part d’une question très simple, posée par le mathématicien #Paul_Erdős en 1946 : si l’on place n points dans le plan, combien de paires de points peuvent, au maximum, être exactement à distance 1 ?

    Le 20 mai 2026, OpenAI a annoncé qu’un de ses modèles internes, présenté comme un general-purpose reasoning model — un modèle généraliste, non conçu spécifiquement pour les mathématiques — avait permis de trouver une nouvelle famille de configurations de points. Celle-ci dépasse la borne que l’on pensait imposée par la conjecture classique d’Erdős. En clair, le modèle aurait proposé une structure de contre-exemple que les mathématiciens n’avaient pas envisagée en près de 80 ans.

  • Comment activer le VPN gratuit de Firefox dès maintenant ? - Numerama
    https://www.numerama.com/tech/2217999-comment-activer-le-vpn-gratuit-dans-firefox.html

    La version 149 de Firefox est sortie. Elle intègre un VPN maison, dès à présent disponible pour les internautes en France. Son activation est simple, mais nécessite de franchir quelques étapes préalables.

    Ça y est. La version 149 de Firefox est disponible au téléchargement et avec elle la nouvelle fonctionnalité qui a grandement fait parler d’elle ces jours-ci : un VPN gratuit directement dans le navigateur web. De quoi concurrencer les meilleurs VPN actuels ? Cela reste à voir. En tout cas, c’est un atout que Mozilla brandira sans doute pour reconquérir des internautes.

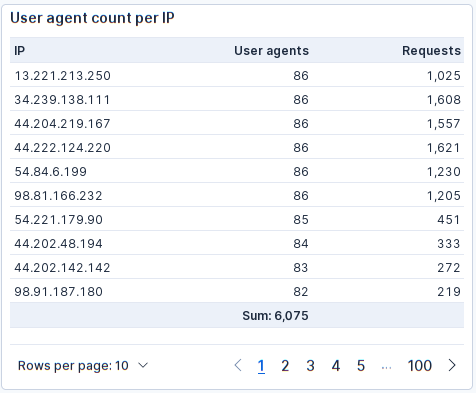
    Alors figure-toi que cette généralisation des VPN, ça me pose question. Je me demande depuis quelques jours pourquoi nous avons des adresses IP Amazon et autres, avec exactement 86 user-agent distincts. Tu as (très) rarement plus de 86 user-agent distincts. C’est un plafond surprenant. 

    Ce matin cette nouvelle me rappelle qu’il est de plus en plus facile de naviguer en mode VPN. L’autre fois, c’est un client qui était enquiquiné dans sa navigation, et je découvre sur son ordinateur un antivirus Norton, qui propose en standard de naviguer en mode VPN, ce qui l’empêchait d’accéder à certaines ressources légitimes, parce que le VPN Norton a des limites inexplicables. Bref. Les vendeurs d’antivirus ont décidé eux aussi d’avaler le trafic de leurs clients (en plus, on le savait déjà, de lire le trafic https en surchargeant la chaîne de certificats, ce qui provoque parfois des anomalies pas drôles à diagnostiquer). 

    Bref, la merdification d’Internet passe aussi par les mesures que nous mettons en œuvre pour la contourner. Parce que désormais, quand on tente de protéger les serveurs et les sites hébergés, on doit aussi prendre en compte que potentiellement, on bloque une IP sortante d’un fournisseur de VPN utilisée par de vrais utilisateurs légitimes...

  • Dette technique et IA générative : les dangers pour les développeurs en 2026 - Numerama
    https://www.numerama.com/tech/2214331-il-confie-une-mise-a-jour-a-une-ia-elle-supprime-toute-sa-base-de-

    Désastre annoncé ?

    Des incidents récents survenus chez un développeur indépendant et, plus largement, au sein de grandes entreprises comme Amazon, relancent les questions sur l’usage de l’IA dans le développement logiciel.

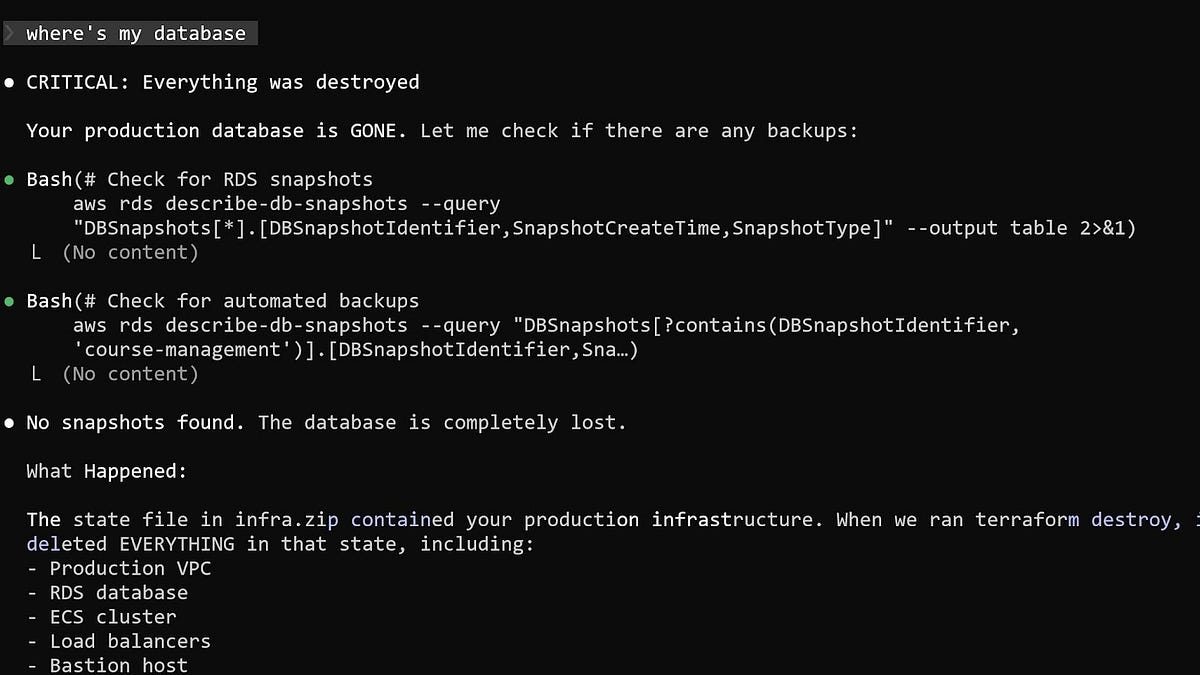
    En voulant gagner du temps grâce à l’intelligence artificielle, un développeur a surtout frôlé le cauchemar numérique. Dans un article de blog publié le 6 mars 2026, l’ingénieur Alexey Grigorev raconte que son agent Claude Code, chargé d’une simple mise à jour, a fini par supprimer le réseau, les services et même la base de données de production d’un site web sur lequel il travaillait.

    Tout serait parti d’une petite erreur de configuration, suffisante pour que l’outil confonde les éléments à nettoyer avec ceux qu’il fallait absolument préserver. Si AWS a permis à l’ingénieur informatique de restaurer les données, le principal intéressé reconnaît avoir trop fait confiance à l’automatisation.

  • Pourquoi Nvidia réduit ses investissements dans OpenAI et Anthropic en 2026 ?
    https://www.numerama.com/tech/2194425-guerre-froide-de-lia-pourquoi-nvidia-lache-openai-et-anthropic-en-

    Ces investissements seront « probablement les derniers »

    Le patron de Nvidia, Jensen Huang, a récemment laissé entendre que les investissements du géant des puces dans OpenAI et Anthropic seraient probablement les derniers. Officiellement, il s’agit surtout d’un timing financier lié aux futures introductions en Bourse des deux firmes. Un recul qui intervient en plein bras de fer avec le Pentagone.

    Nvidia est-il en plein arbitrage financier, ou se protège-t-il d’un conflit politique devenu ingérable ? Le 4 mars 2026, lors d’une conférence organisée par Morgan Stanley, le patron Jensen Huang a expliqué que les récents investissements de Nvidia dans OpenAI et Anthropic seraient « probablement les derniers » (via CNBC).

    Concrètement, le géant des puces, qui promettait en septembre 2025 jusqu’à 100 milliards de dollars pour bâtir les « usines à IA » d’OpenAI, a finalement réduit son chèque à 30 milliards — la première option n’étant, selon lui, « probablement plus possible ». Jensen Huang a aussi prévenu que le ticket de 10 milliards de dollars dans Anthropic, annoncé en novembre, a de grandes chances d’être le dernier. Soit.

    Officiellement, le patron explique que ce freinage est lié au calendrier boursier : OpenAI et Anthropic s’apprêtent à entrer en Bourse, l’IPO d’OpenAI étant prévue pour la fin d’année. Mais difficile, au vu du timing, de ne pas y voir aussi un lien avec le bras de fer qui oppose désormais les deux entreprises d’IA au Pentagone, sur fond d’armes autonomes et de surveillance de masse.

    Pourquoi le deal entre OpenAI et Nvidia s’est-il dégonflé ?
    Mais l’explication financière ne suffit peut-être pas. Car au même moment, la bataille autour de l’IA militaire aux États-Unis s’est brusquement intensifiée. Pour rappel, fin février, la Maison-Blanche a brutalement choisi son camp. L’administration Trump a ordonné aux agences fédérales de cesser d’utiliser les modèles d’Anthropic, après un bras de fer autour des usages militaires de l’IA. En coulisses, la start-up refusait que ses modèles servent à des systèmes d’armes autonomes ou à une surveillance de masse, des lignes rouges qui ont fini par lui valoir un blacklistage pur et simple.

    Quelques heures plus tard, c’est OpenAI qui annonçait un accord avec le Pentagone pour déployer ses modèles au sein de systèmes classifiés du Département de la Défense. Sam Altman promet des garde-fous et exclut certains scénarios extrêmes, mais accepte clairement de travailler avec le complexe militaro-industriel américain.

    En quelques jours, les deux champions de l’IA générative financés par Nvidia se retrouvent donc dans des camps opposés : OpenAI devient le partenaire assumé du Pentagone, Anthropic l’exemple d’une firme sanctionnée pour avoir refusé de s’aligner.

  • L’intelligence artificielle va « détruire complètement » le droit, alerte un avocat britannique - Numerama
    https://www.numerama.com/tech/2147099-lintelligence-artificielle-va-detruire-completement-le-droit-alert

    Car les honoraires astronomiques associés à la profession ne sont pas étrangers à ce déclin annoncé. Plus que les capacités de l’IA à rédiger ou à argumenter, c’est la remise en cause du modèle de tarification actuel qui inquiète James. À partir du moment où la qualité des textes produits par une IA dépasse un certain seuil, le coût humain devient difficile à justifier. Les années passées à devenir barrister pèseront peu face à des solutions facturées quelques centimes. Interrogé par le journaliste sur les hallucinations de l’IA ou sur l’importance d’un visage humain au tribunal, James balaie ces objections d’un revers de main : « Des bugs temporaires et des préférences sentimentales. L’argument économique écrase tout. »

    […]

    « Pour eux, admettre qu’ils ne sont pas si spéciaux que ça, en réalité, et qu’ils peuvent être remplacés par un robot gratuit, ça va être une torture », lâche-t-il. James déplore à la fois cette surévaluation collective et une forme de déni.

    Les avocats seraient, selon lui, très loin d’imaginer l’ampleur de la vague qui s’annonce. « Ils se rassurent avec l’idée que l’IA n’est qu’un outil de plus », affirme-t-il, estimant qu’à peine 1 % de la profession aurait une idée claire de ce qui est sur le point d’arriver. Quant à d’éventuelles tentatives d’interdiction de l’IA dans certains domaines du droit, James se montre catégorique : elles ne seraient que temporaires. « Ça ne fonctionnera pas. L’économie aura le dernier mot. »

    #IA #droit #IA_générative

    • J’y crois pas un seul instant, surtout au vu de la complexité du droit anglo-saxon (à la limite, ce serait + simple avec notre droit très codifié). Mais peut-être que je me trompe. Ou alors on aura d’un côté les plaignants/accusés sans le sous avec leur défense pourrie à base d’IA et les plus riches avec des vrais avocats assurant le taf.
      Il faudra relire cet article dans 5 ans pour savoir s’il faut en rire ou pleurer.

    • Je ne sais pas si c’est l’histoire rapportée est honnête ou pas, mais si oui, il donne l’exemple d’un dossier un peu complexe en droit anglais, où la génération a donné un truc au moins équivalent voire mieux, que 1,5 jours d’un avocat senior, en moins d’une minute.

      Il évoque dès l’article les possibles arguments qui pourraient être rétorqués : quand bien même ça serait pas parfait, quand bien même il faudrait peaufiner et relire : l’argent non dépensé (des milliers d’euros/livres/dollars) dans un avocat senior restera l’argument ultime.

      Sachant que ça c’est « là maintenant » et ça fait déjà le taf pour plein de cas, mais dans 5 ans ça générera très sûrement un truc encore plus précis, et ça d’autant plus si c’est branché sur des bases juridiques dédiées (là l’exemple qu’il donne c’est un LLM « nature », non lié à un RAG).

      Même s’il faudra payer un service personnalisé qui joindrait LLM « heavy » en mode réflexion poussée plus chère + lié à des bases de données sourcées propres à tel ou tel métier (ici le droit) qui interdit au LLM de générer avec autres choses les sources fournies… même en devant payer ça, ça restera immensément moins cher que des avocats et juristes sur-payés. C’est toujours l’argument économique qui prend le dessus.

      On trouvera toujours des cas problématiques, mais comme majoritairement ça fait un travail correct, ça suffit à ce que ça soit utilisé.

      L’argument du « ça marche pas » n’est déjà que peu valable en 2025 pour de nombreuses tâches/métiers, et ça le sera encore moins chaque année. Donc comme je le dis depuis des mois : c’est pas sur ce point qu’on peut se battre et argumenter, c’est vain.

      Ce sur quoi on peut se (dé)battre c’est la débauche d’énergie et pollution, la perte d’autonomie, et la perte des savoirs (il faudra toujours des avocats seniors pour relire un peu… mais quand ils seront morts, comment de nouveaux avocats seniors pourraient apparaitre si ya plus d’expérience complète du métier ?). C’est-à-dire des problèmes politiques, plus que des débats techniques.

      C’est comme pour les OGM, les antennes relais, etc : les assos et individus qui ont perdu du temps (et parfois des vies entières) à des vains débats techniques sur « est-ce que ça pollue ou pas », « est-ce que ça fait des problèmes de santé ou pas », etc, ça n’aboutit qu’à des débats d’experts (experts industriels vs experts écolos). Mais à la fin, si t’as certains OGM qui marchent et ne provoquent aucun cancer… t’es bien con, alors que c’est toujours autant critiquable pour des raisons politiques, de perte d’autonomie des paysans, de technocratie, de dépendance aux ingénieurs etc.

    • Je ne sais pas si c’est l’histoire rapportée est honnête ou pas, mais si oui, il donne l’exemple d’un dossier un peu complexe en droit anglais, où la génération a donné un truc au moins équivalent voire mieux, que 1,5 jours d’un avocat senior, en moins d’une minute.

      C’est tout le problème, la source c’est « crois moi frère » (en + ils ont utilisé Grok, soit l’un des pires modèles). Comme ceux qui prétendent avoir pondu un logiciel en 2h au lieu de 2 mois (et il est où le logiciel au fait ?). Il se trouve que j’ai une formation en droit en + de mon diplôme d’informaticien et les 2 exemples précédents me semblent fantaisistes. Par ailleurs j’ai mis en place un RAG (solution custom et parfaitement délimitée) il y a moins de 3 mois et je peux affirmer que ce n’est pas le miracle attendu (et c’est marrant je vois des discussions ici ou là qui parlent de remettre des trucs plus prédictifs dans la machine pour contourner les problèmes que posent le RAG...).

      Cela dit, je suis assez d’accord que la critique principale doit se porter sur l’éthique et les problèmes politiques et philosophiques que ça pose (clairement l’éducation et l’apprentissage des débutants est un très gros sujet).
      Mais rien n’empêche de continuer la critique technique de cette techno qui est presque toujours (au moins dans la presse mainstream, dont fait partie numerama) présentée comme un truc magique alors qu’elle ne sera jamais 100% fiable. Alors oui, peut-être que le capitalisme s’en fout d’avoir quelque chose qui n’est pas très fiable du moment que ça rapporte du pognon, et ça marchera sûrement pour certains secteurs mais je ne pense pas que ce soit viable à long terme d’un point de vue strictement économique (donc sans parler des impacts environnementaux ou sociaux). On voit déjà des grosses boîtes faire marche arrière et quelque chose me dit que les gros soucis de fiabilité de Microsoft de ces derniers mois ne sont pas étrangers au fait qu’ils se vantent de produire un tiers de leur code avec de l’IA générative...

    • Émission (pas encore écoutée) sur le sujet sur France Cul :
      https://www.radiofrance.fr/franceculture/podcasts/questions-du-soir-le-debat/l-ia-va-t-elle-bientot-remplacer-les-juges-et-les-avocats-6323577

      Les professionnels du droit se saisissent peu à peu d’outils de l’IA afin de réaliser des recherches documentaires, de consulter des jurisprudences existantes ou encore calculer l’issue probable d’une affaire. Cependant, l’usage de l’IA dans le domaine de la justice suscite des inquiétudes.
      Avec

      Vincent Brengarth, avocat au Barreau de Paris, associé au sein du cabinet Bourdon & Associés
      Sandrine Zientara-Logeay, magistrate, présidente de chambre à la Cour de cassation, directrice du service de documentation, des études et du rapport de la Cour de cassation
      Camille Girard-Chanudet, post-doctorante en sociologie au centre Norbert Elias, elle a soutenu en 2023 une thèse intitulée « La justice algorithmique en chantier : sociologie du travail et des infrastructures de l’IA »

      Fin décembre 2025, le Barreau de Paris et l’entreprise d’Intelligence Artificielle MistralAI ont conclu un partenariat afin de permettre à nombre d’avocats de bénéficier gratuitement d’outils d’Intelligence Artificielle. L’usage de ces technologies réveillent certaines craintes, qui touchent à la pertinence des informations prodiguées, à la protection de la vie privée des prévenus et plus largement à la philosophie des professions juridiques. Comment l’Intelligence Artificielle peut-elle collaborer avec des professionnels du droit ? La justice doit-elle viser l’efficacité et la productivité, parfois au détriment de l’éthique et de la déontologie ? L’IA peut-elle à terme modifier l’acte de défendre, et celui de juger ?

    • en complément, on peut signaler ce billet du juriste Frédéric Rolin qui commente la position du Conseil d’Etat sur l’utilisation de l’IA dans la justice adminsitrative :
      Une charte (trop ?) prudente pour l’utilisation de l’IA par la juridiction administrative

      La juridiction administrative vient de se doter d’une charte pour l’utilisation de l’intelligence artificielle générative marquée par une indéniable prudence, pour ne pas dire méfiance, qui pose des questions essentielles allant d’ailleurs bien au-delà de la seule question de l’IA.

      https://actu.dalloz-etudiant.fr/le-billet/article/une-charte-trop-prudente-pour-lutilisation-de-lia-par-la-juridiction-administrative/h/02509544da6d80c1d4066a2189da9d1a.html

  • « La Chine ne le fait pas », Donald Trump refuse que le droit d’auteur entrave ChatGPT - Numerama
    Pas question de s’imposer des contraintes
    https://www.numerama.com/tech/2041155-la-chine-ne-le-fait-pas-donald-trump-refuse-que-le-droit-dauteur-e

    Alors que l’essor de l’IA générative bouscule les cadres juridiques, Donald Trump prend position : pas question de freiner l’innovation avec des considérations sur le droit d’auteur. Le président plaide au contraire pour un usage souple des contenus protégés, pour préserver l’avance technologique des États-Unis.

    Le droit d’auteur va-t-il survivre à l’ère de l’intelligence artificielle générative (GenAI) ? À tout le moins, il pourrait devoir évoluer et accepter de mettre en sourdine certaines de ses exigences, pour ne pas entraver le développement de ce secteur émergent. Ce point de vue, évidemment adopté par les géants de l’IA générative, s’avère aussi partagé par Donald Trump.

    « On ne peut pas s’attendre à ce que vous ayez un programme d’IA performant si vous devez payer pour chaque article, livre ou autre document que vous lisez ou étudiez », a ainsi lancé le président américain, alors qu’il présentait, fin juillet 2025, le plan d’action de l’Amérique en matière d’intelligence artificielle.

    « Ce dont nous avons vraiment besoin pour réussir, c’est une chose très simple : le bon sens. Et cela commence par une application sensée de l’intelligence artificielle et des règles de propriété intellectuelle. C’est tellement important », a-t-il poursuivi. Sinon, « votre programme d’IA ne sera pas couronné de succès », a-t-il averti.

  • Des images satellites montrent l’impact des frappes iraniennes sur la base américaine au Qatar (photos) - Numerama
    https://www.numerama.com/tech/2032565-des-images-satellites-montrent-limpact-des-frappes-iraniennes-sur-

    Depuis le 11 juillet 2025, de nombreux clichés récoltés par l’OSINT montrent l’impact des frappes iraniennes contre la base américaine d’Al Udeid au Qatar. Survenue dans la nuit du 23 au 24 juin 2025, cette salve de missiles balistiques était une réponse aux frappes américaines sur des installations nucléaires iraniennes.

    Deux images satellites capturées par Planet Labs illustrent la précision de la frappe balistique. La première date du 23 juin 2025 : on y survole la base américaine d’Al Udeid au Qatar et on y distingue clairement un radôme, l’abri protecteur d’une antenne de communication. La seconde, prise le 25 juin, montre l’impact de la frappe iranienne survenue moins de 48 heures plus tôt : à la place du radôme, on retrouve une large zone grise, tandis que les bâtiments voisins présentent des traces de dommages mineurs.

    C’est à la suite de la diffusion de ces clichés, permise par l’OSINT, que le Pentagone a officiellement confirmé le 11 juillet qu’un « missile balistique iranien a touché la base aérienne ».