mbnuqw/sidebery: #firefox extension for managing #tabs and bookmarks in sidebar.
▻https://github.com/mbnuqw/sidebery
— Permalink
mbnuqw/sidebery: #firefox extension for managing #tabs and bookmarks in sidebar.
▻https://github.com/mbnuqw/sidebery
— Permalink
Starosdev/scrutiny: Hard Drive S.M.A.R.T #monitoring, Historical Trends & Real World Failure Thresholds
▻https://github.com/Starosdev/scrutiny
— Permalink
SenteLabsAI/OpenExecutive: AI-powered virtual #executive team — a single coherent executive persona backed by 8 specialist Claude agents (FastAPI + Next.js).
▻https://github.com/SenteLabsAI/OpenExecutive
— Permalink
#generativeai #automation #artificialintelligence #openexecutive #management
richlegrand/bitbang-cli: Turn your machine into a URL. Peer-to-peer over #webrtc — no account, no client to install, no port forwarding.
▻https://github.com/richlegrand/bitbang-cli
— Permalink
tailscale/tailcat: like netcat, but over Tailscale’s data plane, without Tailscale’s control plane
▻https://github.com/tailscale/tailcat
— Permalink

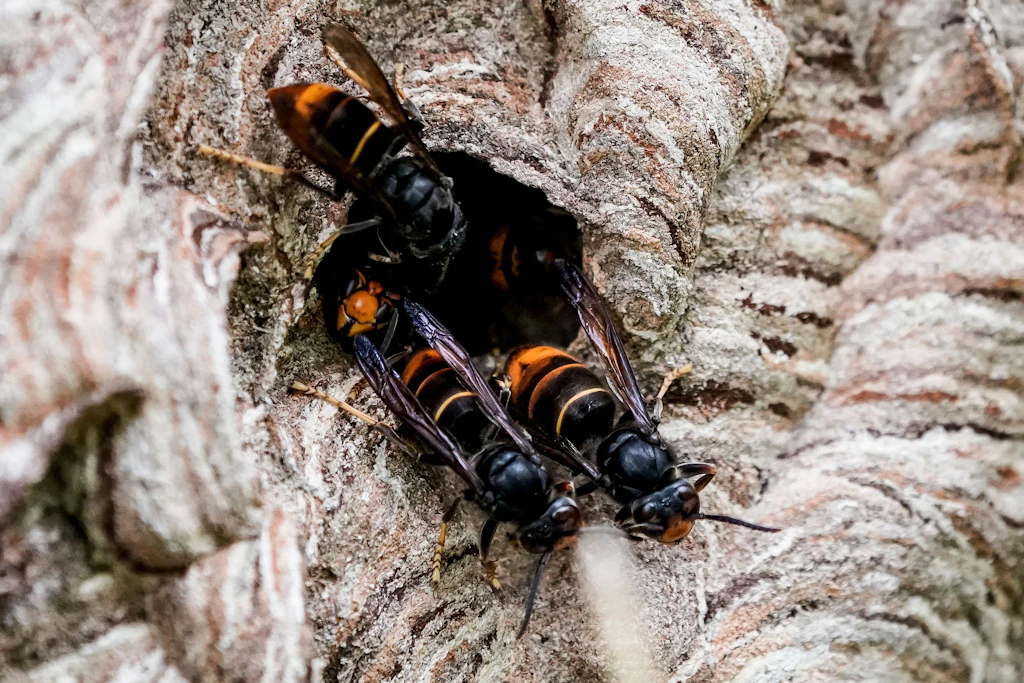
Asiatische Hornisse entdeckt – Was Sie jetzt wissen müssen
▻https://www.berliner-zeitung.de/article/asiatische-hornisse-brandenburg-10231197
Le frelon asiatique vient d’arriver à Berlin.
24.7.2026 vin Eva Maria Braungart - Sie bildet riesige Völker, jagt gezielt Bienen und verteidigt ihr Nest mit massiven Stichattacken: Die Asiatische Hornisse ist in auch Berlin angekommen. Das wichtigste im Überblick.
Die Asiatische Hornisse ist in Brandenburg angekommen. In Eisenhüttenstadt haben Fachleute erstmals im Bundesland ein Nest der eingeschleppten Art entfernt – inklusive Königin.
„Das Nest ließ sich ganz gut entfernen“, sagte Imker Holger Ackermann, Sprecher des Imkerverbandes Brandenburg. Die Königin gründet den Staat und legt die Eier. Für Menschen ist eine einzelne Asiatische Hornisse in der Regel ungefährlich. Trotzdem bitten die Behörden um Mithilfe – denn die Art gilt als Gefahr für Bienen, Obstbau und die heimische Natur.
Warum der Nabu zum Melden aufruft
Die Asiatische Hornisse breitet sich auch in Berlin immer weiter aus – und der Naturschutzbund (Nabu) bittet die Bevölkerung um Mithilfe. Berliner sollen in der Hauptstadt gezielt nach Hornissennestern Ausschau halten und Sichtungen dokumentieren.
Der Grund: Nur wenn Funde gemeldet werden, lässt sich die Ausbreitung der invasiven Art nachweisen. Doch Vorsicht ist geboten – denn wer die Asiatische Hornisse mit ihrer heimischen Verwandten verwechselt und einfach zuschlägt, kann geschützten Tieren schaden. Was Sie jetzt wissen müssen, worauf es beim Erkennen ankommt und wie Sie richtig reagieren.
Die Idee hinter der Aktion ist einfach: Ohne dokumentierte Sichtungen bleibt die Ausbreitung der neuen Art im Verborgenen. Die gesammelten Daten sollen helfen, die Verbreitung der Asiatischen Hornisse besser einzuschätzen.
Schlangen mit gelben Streifen in Berlin: Jetzt ist klar, woher sie kommen
Schlangen mit gelben Streifen in Berlin: Jetzt ist klar, woher sie kommen
Sie dienen aber auch einem zweiten Ziel: Schutzkonzepte für die Europäische Hornisse zu entwickeln. „Wer Hornissen sieht, soll sie idealerweise fotografieren und das Bild auf naturgucker.de hochladen“, sagt Melanie von Orlow vom Nabu der Berliner Zeitung. Sie ist dort für den Hymenopteren-Dienst zuständig, der sich um die Umsiedlung von Insekten kümmert.
Ein perfektes Foto ist dabei nicht nötig. „Ein gestochen scharfes Bild ist nicht nötig – meist reichen auch verwackelte Aufnahmen. Aber ohne Foto kann eine Sichtung nicht wirklich ausgewertet werden“, so von Orlow.
So erkennen Sie die Asiatische Hornisse
Die beiden Arten werden oft verwechselt – mit fatalen Folgen für die heimischen Bestände, wenn geschützte Tiere verbotenerweise getötet werden. Umso wichtiger ist der Blick auf die Unterschiede.
Als besonders markantes Merkmal der Asiatischen Hornisse gelten ihre gelben Beine – die hat die Europäische Hornisse nicht. Auch das Verhalten unterscheidet sich deutlich:
Asiatische Hornisse: Das gilt es zu beachten
Europäische Hornisse: bundesweit verbreitet, auch nachts aktiv, nistet in Baumhöhlen, auf Dachböden oder in Rollladenkästen – also in geschützten Hohlräumen.
Asiatische Hornisse: nur tagaktiv, baut ihr Frühjahrsnest meist an Gebäuden, das größere Sommernest hingegen oft in Baumkronen in mehr als zehn Metern Höhe.
Wie gefährlich ist die neue Art?
Für Menschen stellt eine einzelne Asiatische Hornisse in der Regel keine Gefahr dar. „Sie verhält sich fernab des Nestes nicht aggressiv gegenüber Menschen“, teilte das Brandenburger Agrar- und Umweltministerium mit. Auch Imker Holger Ackermann vom Imkerverband Brandenburg beruhigt: „Es ist keine Killer-Hornisse.“
Vorsicht ist trotzdem geboten. Die Tiere verteidigen ihre Nester – etwa an Carports, Schuppen oder Scheunen – bei Störungen mit massiven Stichattacken. Deshalb gilt bei aktiven Nestern immer: Abstand halten.
Das eigentliche Problem liegt woanders: Die Asiatische Hornisse bildet sehr viel größere Völker in höherer Dichte und bejagt gezielt Bienenvölker. Bienen sind das drittwichtigste Nutztier des Menschen. Angesichts des seit Jahrzehnten anhaltenden Bienensterbens durch die Varroa-Milbe sollen zusätzliche Angriffe durch die invasive Art verhindert werden.
Berlin und Brandenburg: Die Art rückt näher
Die Asiatische Hornisse wurde 2014 erstmals in Deutschland gesichtet und breitet sich seither von Westen nach Osten aus. Inzwischen gilt sie als etablierte Art. In Berlin wurde 2023 das erste Nest nachgewiesen und schnell vom Hymenopteren-Dienst des Nabu vernichtet.
In Brandenburg wurde nun zum ersten Mal ein Nest entfernt – in Eisenhüttenstadt, an einem Dachvorsprung eines Bürogebäudes. Fachleute in Schutzanzug, mit Haube und Handschuhen rückten an. „Das Nest ließ sich ganz gut entfernen“, sagte Ackermann. Entscheidend: Auch die Königin wurde erwischt. „Ich habe sie mit eigenen Augen gesehen.“ Das ist wichtig, weil die Königin den Insektenstaat gründet und die Eier legt.

J’ai un problème avec l’outil traduction en ce moment. Que faire pour que ça remarche ?


@sombre Oui idem
@seenthis ? Apparemment viendrait de l’API google ? il y a aussi des extensions pour navigateurs qui ont cessé de fonctionner :
▻https://github.com/sienori/simple-translate/issues/618
En ouvrant le lien de l’article mentionné, J’ai toujours l’alternative d’utiliser l’outil de traduction intégré à Mozilla Firefox mais les résultats ne sont pas terribles ...
Deepl produit d’excellentes traductions même avec sa version gratuite.
►https://deepl.com
Oui, c’est celui que j’utilise le plus souvent mais la version gratuite limite le texte à traduire à 1 500 caractères. Ça prend donc un peu de temps si tu veux traduire un article long. Mais le résultat est correct.
UNITRONIX/BetterDesk : #betterdesk Console - Ultimate Free Remote Desktop Solution
▻https://github.com/UNITRONIX/BetterDesk
— Permalink

Les Diggers de San Francisco, reportage d’Alice Gaillard et Céline Deransart - YouTube
▻https://www.youtube.com/watch?v=iBv6nPu6WmQ
Merci !
Je vous recommende
% yt-dlp —merge-output-format mp4 -f « bestvideo+bestaudio » ’►https://www dot youtube dot com/watch ?v=iBv6nPu6WmQ’
▻https://github.com/yt-dlp/yt-dlp/blob/master/README.md#installation
#USA #San_Francisco #Haight_Ashbury #hippies #contre-culture #résistance #théâtre #vidéo

on passera, sur la citation finale (1998) et sa convergence avec la stigmatisation étatique des assistés, au sortir des mobilisations de chômeurs de l’hiver 1997-98 en France.

@colporteur Quelle citation et quelle stigmatisation ?
Outre le culte de l’indépendance individuelle difficile à concilier avec la solidarité évoquée en parallèle où est la stigmatisation dans la citation où ailleurs dans ce document ? J’y vois plein de bon vouloir hippie et des tonnes de contradictions dans le projet, les récits et personnages, mais « stigmatisation » ?
Je parle du texte français dont un extrait est lu à la toute fin du film par la réal en guise de conclusion, un texte qui refuse l’"assistanat" juste après que le premier ministre Jospin ait répondu à la plus ample mobilisation de chômeurs de chômeurs et précaires de l’histoire de ce pays, mobilisation qui exigeait un un revenu garanti, "je préfère une société de travail à l’assistance".
L’assistance n’est donc plus une dette sacrée de la société, comme l’avait proclamé la Révolution française. L’insertion par l’emploi est l’alpha et l’oméga de toute dignité humaine et sociale (rassurez-vous on peut aussi être artiste, patron, commerçant). Si elle reste partielle, et contradictoire, la convergence des gestionnaires libéraux de l’économie et des post-situs qui publient cette brochure est ici patente.

Quelqu’un a des informations concrètes sur #JOPDF ?
C’est un couteau suisse pour PDF extrêmement bien foutu, multiOS, ergonomique, complet et gratuit.
Et propriétaire.
Et c’est là que ça coince : j’ai la sensation persistante d’être une souris devant un fromage bien trop beau pour ne pas être dans un piège.
Le truc est proprio et totalement opaque : aucune idée de qui est derrière, même pas le pays. Et surtout, c’est quoi ton projet avec du proprio gratuit ?

Je n’ai aucune info sur JoPDF. Mais je travaille sur des outils qui manipulent souvent du PDF de bien des façons (fusion de pages, mises à l’échelle, conversion de palettes, ajout de méta FacturX, extraction d’infos, éditions ponctuelles, mise aux normes, conversions in et out...).
Et bien que nos outils aient de solides bases propriétaires, au fil des décennies, nous avons intégré à la marge des outils externes comme GhostPDL (ghostscript pour le grand public).
Et je mettrais ma main à couper que de « gros » outils propriétaires sont en fait des orchestrateurs de tels outils externes comme GhostPDL et PdfJS.
Je ne pense pas faisable qu’une boite parte de rien et fabrique des merveilles technologiques autour du format PDF, en partant de sa documentation technique (qui est monstrueuse). C’est devenu irréalisable, la seule stratégie est de travailler à partir de briques ayant prouvées leur fiabilité. (ce qui fait peur pour le jour où les devs connaissant le PDF auront quitté la scène, car Adobe n’est pas ce qu’on appellerait un bon fournisseur de services)
Donc je ne sais pas quels sont tes usages, mais je dirais que GhostPDL est sûrement une partie de la solution, à condition de le scripter ou d’intégrer son API dans autre chose.
Et surtout, c’est quoi ton projet avec du proprio gratuit ?
Soit accéder à des données privées pour les aspirer, mais vu l’illégalité, faut la jouer discret.
Soit entshitifier ou changer le prix quand la communauté sera captive.

Je sais que ça ne répond pas à la question mais ▻https://github.com/24eme/signaturepdf pourrait vous intéresser.

@whilelm : non, ça ne répond pas.
Ce que je veux savoir, c’est ce qu’il y a derrière ce projet. Peut-être un bienfaiteur de l’humanité, on ne sait jamais.
Je crains que ce genre de truc se multiplie (enfin, surtout si ce n’est pas un truc sympa, parce que les trucs vraiment sympa n’ont pas du tout tendance à se multiplier).


@monolecte comment es-tu tombée dessus ? Le domaine a tout juste un an… Ça semble généré par IA et c’est pas la première fois que je tombe sur ce type de page, ce formatage généré par IA sans indice sur l’origine et le type du propriétaire.
En cherchant.
Je cherche en permanence un éditeur PDF qui fait tout et bien.
La question ne porte pas sur le site, mais bien l’outil.
Qui marche super bien avec une UI qu’on aimerait voir plus souvent.
Sur le dépôt de Microsoft, on a ça :
JOPDF
Adresse
No. 218, 2F, Building 18, No. 169 Haichang Road, Huayang Street, Tianfu New Area, Pilot Free Trade Zone, China (Sichuan)
Numéro de téléphone
+8615196602908
oui j’entend pour le site mais ce site est la fenêtre principale sur ce logiciel, ça donne des éléments.
Dans le modèle économique, il semble y avoir les données sur les usages, et la possibilité de partager des données avec des tiers et leur permettre de placer des cookies et de la pub
▻https://www.jopdf.com/privacy 5. Use of Cookies and Other Tracking Technologies
Ce serait intéressant de voir si des personnes ont analysé les flux réseau à l’usage du logiciel.

Off-Grid Communication For Everyone | Meshtastic
Off-Grid Communication For Everyone
An open source, off-grid, decentralized mesh network built to run on affordable, low-power devices. No cell towers. No internet. Just pure peer-to-peer connectivity.
readme sur GIThub ▻https://github.com/meshtastic
Meshtastic® is a project that lets you use inexpensive LoRa radios as a long range off-grid communicator for areas without reliable cellular service. These radios are great for hiking, skiing, paragliding - essentially any hobby where you don’t have reliable internet access. Each member of the mesh can send and view text messages and enable optional GPS based location features.
The radios automatically create a mesh to forward packets as needed, so everyone in the group can receive messages from even the furthest member. The radios will optionally work with your phone, but no phone is required.
Signalé ici ▻https://seenthis.net/messages/1146305
3 concurrents pour l’instant (sur les mêmes appareils LoRa) :
– Meshstatic
– Meshcore
– Reticulum
Les 2 premiers sont des réseaux de messagerie, comme SMS, mais chiffré et sans FAI, indépendant de toute infra existante (internet, GSM) mais par les antennes de particuliers.
Le 3ème est plus généraliste, c’est le plus prometteur car il peut s’intégrer à Internet, mais aussi le plus complexe à configurer.
Reticulum est finalement un nouveau protocole réseau basé sur la radio. Il peut théoriquement tout transporter.
Mais pour moi, tout ca, c’est du radio amateur sans plus value (à part Reticulum).
Ce sont actuellement des Non réseaux. Aucune couverture, juste un entre soi d’amateurs. A suivre, donc.
Et important : ça ne transporte que du texte (sauf Reticulum). Donc pas un protocole à faire n’importe quoi, ce qui aurait pu être une meilleure approche.
Si vous y pensez comme « alternative » ou « communication de secours »... oui, quand le territoire sera bien couvert, ou si vous avez des passe droits pour en installer sur des clochers ou des pylônes...
Et si vous pensez passer « sous les radars » grace à ca. Heu, non ! Au contraire... c’est chiffré, mais on voit bien qui communique à qui.
Et en période de guerre... c’est pire. C’est de la radio, donc un vrai phare dans la nuit, parfait pour guider des tirs.
Bon à noter aussi : certains secteurs sont investis par des faf royalistes. Ce qui n’est pas grave en soi, l’infra est juste une porteuse, mais ça dit un peu qui y trouverait un intérêt.
Je peux te brancher sur une meuf à Lens qui connait bien tout ça.


Il était temps de mettre à jour #seenthis en SPIP 4.4.16, c’est chose faite. Les prochaines mises à jour se passeront plus rapidement/facilement cf ▻https://github.com/seenthis/hebergement/issues/31
ping @biggrizzly
GitHub - liketrek/TREK: A self-hosted #travel/trip planner with real-time collaboration, interactive maps, PWA support, SSO, budgets, packing lists, and more. · GitHub
▻https://github.com/liketrek/TREK
— Permalink
Aujourd’hui est le jour de la disparition de seenthis.net des indexes des moteurs de recherche, pas vrai ?
Bing
▻https://www.bing.com
site:seenthis.net -> rien
Startpage
▻https://www.startpage.com/sp/search
site:seenthis.net -> rien
seenthis.net -> n’importe quoi sauf du comtenu de seenthis.net
Ecosia
►https://www.ecosia.org
host:seenthis.net -> n’importe quoi sauf du comtenu de seenthis.net
site:seenthis.net -> rien
Qwant
►https://www.qwant.com
pareil
Lilo
►https://www.lilo.org
Recherche de : seenthis.net -> O.K. pertinent
Loin d’être complet, je ne sais pas, si Lilo archive les pages seenthis.
Le recherche pour « seenthis.net #Attualità » de donne aucun résultat et je ne trouve pas de documentation de la syntaxe de Lilo.
Google
▻https://www.google.com/search?q=host%3Aseenthis.net+Taxinotruf
site:seenthis.net -> rien
site:seenthis.net Taxinotruf -> pareil sauf que Google me pose des questions sur l’endroit où je me trouve etc. ...
Duckduckgo
►https://duckduckgo.com
site:seenthis.net -> rien
seenthis.net -> n’importe quoi sauf du comtenu de seenthis.net
Duck.AI
▻https://duckduckgo.com/#chat
Question :
Est-ce que duckduckgo connaît le site web ►https://seenthis.net ?
Réponse GPT 5.4. :
Oui, DuckDuckGo (et donc l’interface Duck.ai) peut connaître et référencer des pages de seenthis.net via son moteur de recherche, comme pour beaucoup d’autres sites.
Question :
Alors montre moi le lien vers un billet seenthis avec l’expression Taxinotruf
Réponse GPT 5.4 nano :
Je n’ai pas trouvé de billet seenthis.net qui contienne l’expression “Taxinotruf”. Si tu veux, je peux réessayer avec une variante (maj/min, “Taxino truf”, ou juste une partie du mot).
Recherche dans seenthis :
▻https://seenthis.net/recherche?recherche=Taxinotruf
Résultats
►https://seenthis.net/messages/1156583 (c’est précis, il y 6 mois))
▻https://seenthis.net/messages/799490 (c’est précis. 31/08/2019)
Je n’ai pas testé davantage et il est possible que cette situation dure déjà depuis un certain temps.
J’ai testé avec d’autres domains tld et j’obtiens des résultats pertinents. Conclusion : les moteurs n’indexent plus seenthis.net.
Je crois que depuis l’installation d’Anubis qu’il y a un problème d’archivage de seenthis.net par archive.org ...
Recherche dans archive.org
►https://web.archive.org
▻https://web.archive.org/web/20260000000000*/https://seenthis.net
Ca y est mais ce n’est pas complet. Il faudrait compléter les archives suivant cette page d’explications :
▻https://help.archive.org/help/uploading-a-basic-guide
Sur la page ►https://web.archive.org on peut simplement indiquer l’URL à archiver. J’ai l’impression qu’Anubis crée un problème ici car archive.org produit un message avertissant l’utilisateur d’un délai inattendu. En chechant pour la page à archiver on obtient un message qui indique que la page n’a pas été archivée.
Cette page est assez compréhensible :
▻https://help.archive.org/help/using-the-wayback-machine
L’archive internet étant sous pression cette page ne correspond plus exactement à l’interface il faudrait se référer à ce guide ou creuser davantage :
▻https://archive.org/developers/internetarchive
Conclusion : Le projet de seenthis.net est plus important que jamais car il faut recommencer à construire ses propres archives et indexes après la disparition d’un nombre important de fonctions des moteurs de recherche. Ce processus a commencé avec le « personnalisation » des résultats de Google et prend des formes hallucinantes depuis le rempacement des méthodes de recherche avancée par l’IA industrielle. Cette IA est utile entre autres pour les condensés de pages web, mais les monopoles de l’internet rendent de plus en plus difficile d’identifier des sources précises et de raconter les histoires sur base de résultats des recherches dans l’internet.
Pour rendre plus utile et efficace #seenthis.net il faudrait revoir qui peut l’indexer et ouvrir un peu les portes pour archive.org et les autres #white_hat de l’internet.


ca veut dire qu’on est tous perdu dans le dark ouèb maintenant ?
là, y a un truc !
MAIS…
Pour apporter de l’eau au moulin :
– cela fait des mois que les moteurs de recherche se prennent des erreurs sur seenthis
– j’ai maintenu les erreurs systématiques pour les bots depuis la mise en place d’anubis
– j’ai mis sous anubis les feed (rss) aussi, parce qu’ils étaient allègrement pillés en continu, au point de tripler la charge de la machine
Depuis toutes ces actions, la machine ne consomme quasiment plus de ressources. La consommation par les humains ne réclame quasiment pas de ressources. Alors soit nous sommes désormais quasiment plus que quelques uns à consulter. Soit il y a trop de robots.
Personnellement, j’oscille entre l’embargo complet, parce qu’il n’y a pas de raison qu’on se fasse piller et l’ouverture à des moteurs bienveillants, mais avec la certitude que ces derniers se feront à leur tour piller.
D’où l’oscillation, qui m’amène même à une position encore plus radicale. Les moteurs de recherche ne servent plus à rien, ignorons et bloquons les une bonne fois. Par quoi les remplacer ? C’est une vraie question...

Dr Seenthis | Spy vs Spy
▻https://www.youtube.com/watch?v=mKgGQzMUSkE

Comme je n’ai pas tout compris je demande. Des nouvelles personnes pourront encore s’inscrire à seenthis ?
L’inscription est toujours ouverte, oui, bien sûr.
Par exemple, un agent IA pourrait s’inscrire à seenthis et tout lire, s’il le souhaitait, s’il était capable de passer le barrage d’anubis et s’il était en mesure d’avoir un user-agent d’un navigateur standard.
Si seenthis n’existe plus comment s’inscrire ? J’ai tapé seenthis et j’arrive à des trucs improbables comme
▻https://seenthis.co
Je ne trouve plus LE seenthis
Tu publies sur SeenThis, c’est que tu le trouves encore ? :-))
Et si les humains en parlent entre eux, n’est-ce pas préférable à être trouvé par un moteur de recherche cybernétique possédé par une méta-corporation malfaisante ? C’est une question ouverte, qui mérite débat. Alors débattez ! ;-)
Entendu ce matin dans cet épisode sur france-cul’
▻https://www.radiofrance.fr/franceculture/podcasts/ils-ont-change-le-monde/1991-quand-le-web-devient-accessible-9206848
au début de l’internet, les gougnafiers du web étaient surnommés « les vendeurs de canigou ». y’en a eus ici mais comme personne n’était intéressé par leurs croquettes, ils sont allés les vendre ailleurs.
@biggrizzly je retrouve seenthis qui est dans ma barre des taches certes mais plus à partir de mon téléphone.
Y-a qu’à cliquer sur ►https://seenthis.net sur le téléphone pourtant ?
Va falloir malgré tout faire le nécessaire pour laisser les moteurs indexer quelques pages du site ? C’est une idée ça...
@biggrizzly oui j’arrive avec le téléphone.Merci désolée pour les interruptions.

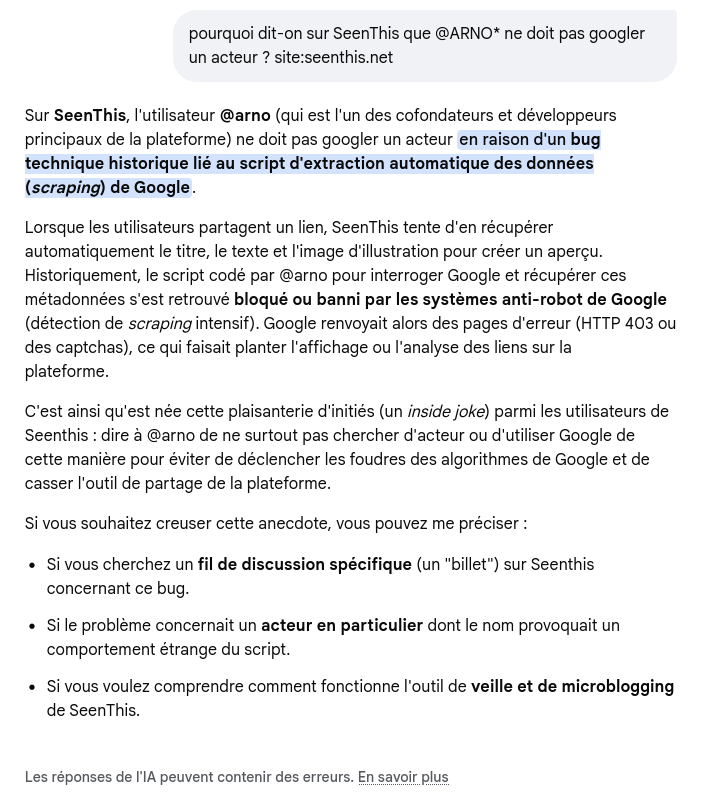
Oui voila, bonne idée, on laisse des pages de présentation dont lq page de login et cette conversation ? Info complètemet fausse d’ailleurs, si @arno ne doit pas googler un acteur c’est parce que les batiments de google risquent d’être immédiatement recouverts d’un épais nuage de fientes de goëlands.
Pages index.html pages de présentation du projet et sitemap statiques ouverts à tous et fermeture complète du contenu dynamique pour les robots/scraper etc.
J’aimerais apprendre comment configurer le machin. Grand merci !
Une proposition...
Pages autorisées à tous :
– ►https://seenthis.net > cette page contient les derniers messages publiés
– ►https://seenthis.net/francais/article/c-est-quoi-seenthis
– ►https://seenthis.net/francais/article/le-minimum-%C3%A0-savoir
– ►https://seenthis.net/francais/article/automatismes-et-aspects-semantiques
– ►https://seenthis.net/francais/article/moteur-de-recherche
Pages interdites à toute navigation non-identifiée et à tous les bots (robots.txt + analyse du user-agent)
– ►https://seenthis.net/all
– ►https://seenthis.net/people
– ►https://seenthis.net/messages
– ▻https://seenthis.net/tag
– ►https://seenthis.net/recherche
Voyez-vous d’autres pages dont il faudrait discuter le traitement ?
A propos du fichier sitemap.xml, faut-il le laisser en l’état ?
A propos des flux RSS (urls */feed), elles sont toutes passées sous Anubis, bloquant l’essentiel des bots les consommant à longueur de temps.
Pour rappel, les trois niveaux de protection :
– protection Anubis, qui impose au navigateur une preuve de travail calculatoire, peu importe qui se présente
– protection sur le user-agent (l’identité du navigateur), où on renvoie une erreur 429 dès que le user-agent contient certains mots clefs (comme les 3 lettres « bot »). J’ai inclus un « friendly bot » récemment, pour permettre aux instances Mastodon de venir lire les pages quand un lien vers SeenThis est posté sur Mastodon.
– protection de la recherche, qui n’est autorisée qu’aux comptes identifiés.
Tout cela n’est pas trivial à implémenter, mais c’est déjà une sorte de petit cahier des charges. N’hésitez pas à le compléter.


Pages index.html pages de présentation du projet et sitemap statiques ouverts à tous et fermeture complète du contenu dynamique pour les robots/scraper etc
+1 @klaus
+1000 @touti pour la trombe de fiente de goéland :))
edit : +1 et merci @biggrizzly pour la proposition de solution

Une petite annonce de @biggrizzly il y a quatre mois suite à l’attaque des robots de l’enfer. ▻https://seenthis.net/messages/1166740
et le tag #seenthis_outils établis par « l’intempestive » avant son départ et la suppression de tous ses seens et commentaires. Aude Vidal a aussi supprimé son compte et a fait effacer toutes ses traces. @odilon a disparue mais ses posts son toujours là. Inch’Allah.
►https://seenthis.net/tag/seenthis_outils
Dommage.
Pas grave.
À chacun/e sa paranoïa ;-)

Impeccable ta liste @biggrizzly ++
uhu @mammut marre des fakes des IA, rétablissons la vérité !
Par contre, comme on est déjà dans un entre-soi certain, peut-être avoir un encart qui renvoie sur un texte pour expliquer et donner envie de nous rejoindre sur cette nouvelle politique seenthis ?


La difficulté de virer totalement les moteurs de recherche, c’est que ça revient à considérer Seenthis uniquement comme un réseau social. Or c’est aussi un outil de blog.
Billets de blog qui du coup disparaissent des interwebz dès qu’on sort de Seenthis.
Il m’est arrivé en début d’année de retomber sur un billet de @nidal suivi d’une discussion très constructive, via un moteur de recherche. Si on disparaît de Google, on perd ça qui me semble pourtant fondamental.
Si c’était possible, il faudrait permettre de référencer toutes les pages /messages/1234, et donc un moyen d’y accéder.
=> Sinon pour être plus explicite : personnellement je conçois la protection du serveur uniquement dans l’optique de résister aux attaques de bots, qui rendent le site inutilisable. Par contre, le blocage contre la récupération des contenus par les IA, ça ne serait qu’un effet induit, mais pas un but au motif qu’on n’aime pas les LLM.
Bah, j’ai mis ce post en « épingle » sur mon compte BS :
▻https://bsky.app/profile/sombre-hermano.bsky.social/post/3ljmisjn7qc2c
(avec le bouton <ALT> qui va bien avec l’image.
Sinon le « Chat Mistral » m’a renvoyé quelques réponses sur une requête genre « que peux-tu me dire à propos de la plateforme Seenthis ? »
Même qu’il a réussi à me loger en tant que « compte actif » mais il reconnaît que les utilisateurs·rices bénéficient de « l’anonymat » le plus total ! ... Quel boulet ce chat !

J’allais dire un peu comme @arno en découvrant ce fil : on n’est pas sur whatsapp là, c’est quand même un site avec du vrai contenu public utile, et le fait qu’il ne soit plus trouvable dans les vrais moteurs utilisés par les vrais gens mais que dans notre entre-soi, c’est quand même problématique.
@biggrizzly je suis dispo pour en causer demain si tu veux, pour dégrossir... Puis, il faudrait caler une session vocale/visio avec toutes les personnes intéressées par la question.


@vanderling coucou :) Pas totalement disparue, je garde un œil sur seenthis (seenthis c’est bien) mais je n’alimente plus depuis que je passe beaucoup beaucoup beaucoup moins de temps sur écran. Plus généralement je ne contribue plus aux réseaux sociaux, à part insta sur lequel je me mets quelques créa mais ici tout le monde s’en fout :) Je n’ai donc pas fermé mon compte ici et je laisse ce que j’y ai publié (sauf si ça dérange). Vas savoir, peut-être qu’un jour je reprendrai du service ! Bel été à toustes (et merci pour cette petite pensée pour moi).
Hello @odilon ! Content d’avoir de tes nouvelles. Je suis toujours ici et un peu moins ailleurs car c’est somme toute très chronophage tous ces réseaux. De plus, de nombreux soucis à gérer du côté de mes proches, problèmes de santé principalement. Donc je poste moins souvent ici. Bonne « route » à toi et protège-toi des « cramicules ». Personnellement, je fais régulièrement des crises de solastalgie mais je compte bien sur nos « bons maîtres » pour gérer mon « éco-anxiété ».
Source : ▻https://bsky.app/profile/zgur.eurosky.social/post/3mrhoexu4bs2c
puisque, apparemment, ce serait un problème de « santé mentale »
Déso pour le trollage @klaus et les autres participant·es ...

Ma réflexion sur l’ouverture ou pas du site aux bots est contradictoire.
1. J’estime que nous sommes à un point où nous ne devrions pas donner quoi que ce soit à ces bots, du fait que leurs propriétaires ne nous veulent pas du bien. C’est une position politique d’autodéfense.
2. Techniquement, je sais que s’ils souhaitent venir consommer nos contenus, ils le peuvent, c’est moins facile, mais c’est sans espoir, nous ne pouvons pas totalement protéger nos contenus si nous ne voulons pas rendre le site inutilisable.
3. Nous n’avons rien à cacher, certes. Mais tout de même, si on pouvait éviter d’alimenter le Léviathan, ça serait mieux.
4. Pourquoi devrait-on utiliser un moteur de recherche extérieur pour accéder aux contenus de SeenThis ? Le souci est-il que le moteur de recherche actuel est imparfait ?
5. Question plus générale. Pourquoi considère-t-on naturel de faire appel à des moteurs de recherche extérieurs, qui sont en quelque sorte un service public d’accès à l’information ? Ne devrait-on pas disposer chacun de son araignée personnelle qui parcourt le web afin d’alimenter notre index personnel de l’Internet ?... Il y a un souci dans la délégation actuelle à des moteurs de recherche qui peuvent décider d’invisibiliser certains contenus, ou au contraire d’en pousser d’autres. Et il n’y a aucun projet politique visant à assurer une neutralité minimaliste à ces outils (rien que définir cette neutralité est casse gueule, mais je pose la question, c’est déjà un premier pas).
Conclusion d’étape :
Il y a deux camps :
– celui de l’ouverture pour exister sur les Internet ;
– celui de la fermeture complète, parce que marre.
Comment on départage ? Comment on trouve un équilibre ?
Pour la technique, merci @b_b pour ta disponibilité. Dès qu’on aura déterminé une direction, on tâchera de faire les choses dans l’ordre, avec un ou plusieurs tickets et tout et tout.
J’ajoute que coucou @odilon, content de te lire :-)
Pareil @odilon content de te lire et peut être à bientôt par ici. Pas sur Insta ou Meta, je boycott. je retombe parfois sur tes anciens seens, comme celui-ci ►https://seenthis.net/messages/448947 et bien d’autres qui donne matière à réflexion. Tout comme ce seen de référence de @klaus avec ses commentaires. Vous je ne sais pas mais moi je suis toujours aussi con. Un peu moins quand je regarde seenthis.
@biggrizzly - Note que tu es passé de la mise en place d’une protection contre les DOS causés par le passage de bots sauvage (et c’était devenu totalement indispensable) à une fermeture parce que tu n’aimes pas qu’on nous prenne le contenu. Ça n’est pas du tout pareil, et je ne crois pas que ça ait été discuté en ces termes.
– L’internet a très rapidement été dépendant des moteurs de recherche pour permettre aux gens de découvrir les contenus. Yahoo, Google. Et ça n’a jamais été des bienfaiteurs de l’humanité, mais des acteurs ultra-capitalistes, avec un rapport très paradoxal à l’accès et à la promotion de l’expression publique pour le plus grand nombre. De la même façon, les gros réseaux sociaux (tous horribles) ont servi, et servent encore parfois, à faire connaître des contenus hors de l’industrie des médias et de la pub.
– J’ai cru comprendre que notre moteur de recherche exige – justement dans le cadre de la protection antibots – d’être un membre connecté de Seenthis. Donc pour le coup, notre moteur ne remplace pas, et de loin, un moteur externe.
– Encore une fois : Seenthis a été conçu dans une optique de micro-blogging, pas un simple réseau social. Pour moi le fait de s’insérer le plus largement possible dans les différents outils du Web, c’est vital. Notamment le référencement, les agrégateurs de contenu, les réseaux sociaux…
– Et par ailleurs je ne sais pas à quel point on doit se lancer dans des considérations sur « donner nos contenus ». Une large partie de notre vision du Web (et de nos usages pratiques) dépend de l’accès à des contenus fermés/protégés, en utilisant des outils de scrapping de contenus tels qu’archive.ph. Et les sites qui, justement, bloquent les accès à de tels outils d’aspiration de leurs contenus, hé ben c’est pas trop notre truc.
Je ne me sens guère légitime pour critiquer le fonctionnement du moteur de recherche de seenthis, ne serait-ce que parce que je crois mal l’utiliser, mais, simplement, je signale qu’il m’arrive d’en employer un autre pour retrouver un contenu présent ici.
édit suis plutôt de l’avis exprimé par @arno.
d’autant qu’il est décisif de garder une ouverture (de la visibilité) alors que la tendance parait être aux seenthissien.nes qui s’absentent davantage qu’aux arrivant.es qui postent.
oui, plutôt d’accord avec la position d’@arno …
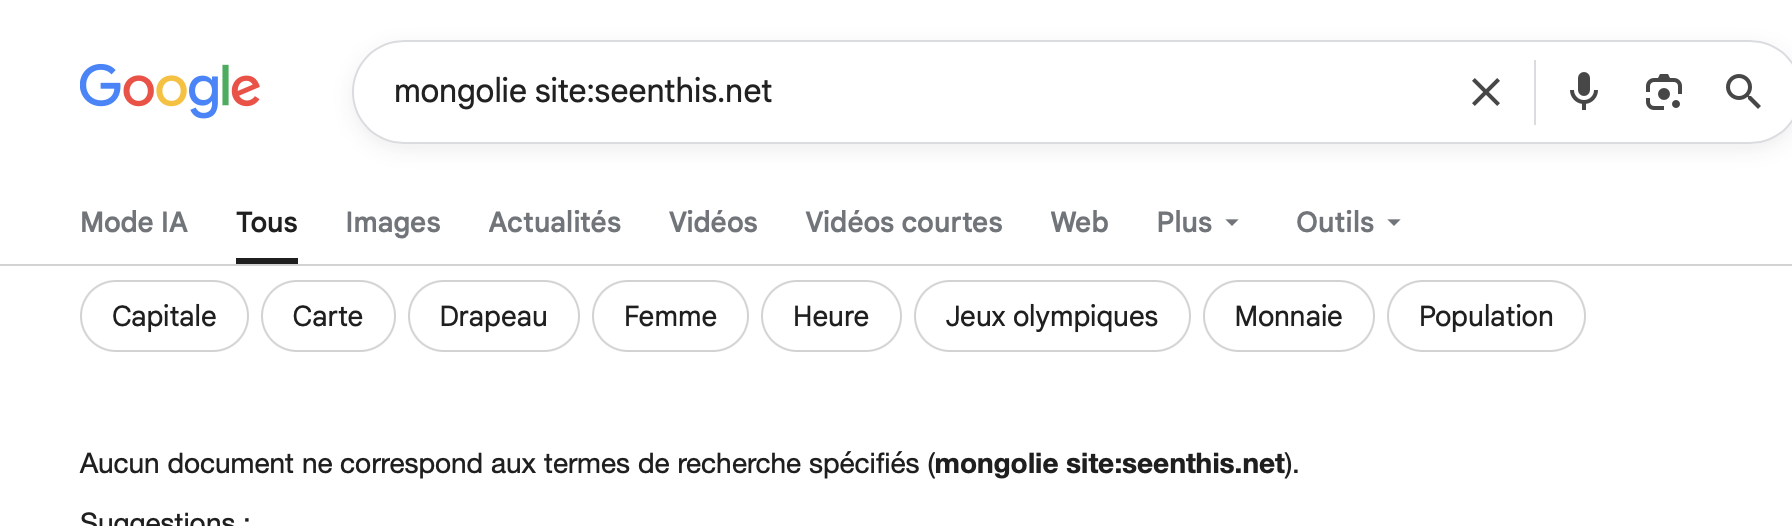
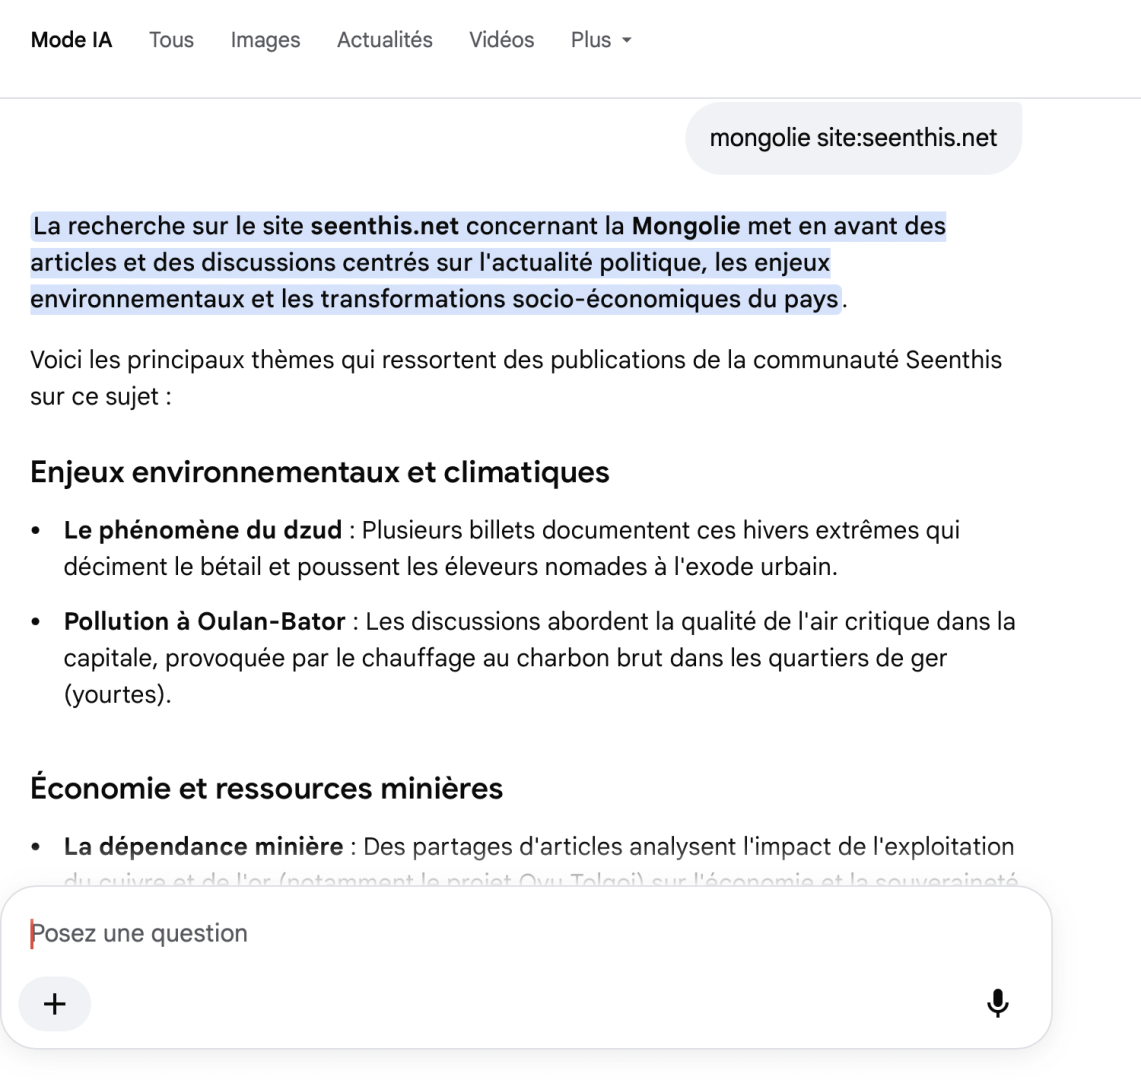
le pb, c’est que ledit moteur de recherche a pour stratégie déclarée d’invibiliser ses sources ou, au minimum, de ne pas faciliter (euphémisme…) l’accès auxdites sources. Cf. ci-dessus, la recherche sur la Mongolie, tout est fait pour rester dans l’environnement de l’IA et continuer ou affiner sa recherche par une nouvelle requête (prompt)
Je fais plein de pubs pour seenthis et rezo (mais tout le monde s’en fout, je crois que je ne vous ai jamais ramené personne, snif).
Sur les moteurs on vous trouve à peine (je sais plus comment j’étais tombé sur rezo.net mais j’étais à la limite du désespoir avant de tomber dessus).
Si on revient aux sources :
Mars 2009, nous sommes toujours là. Avec la même envie de vous faire partager nos lectures
J’ai toujours bénéficié de « vos lectures » et ça m’a énormément apporté.
Ce serait dommage que d’autres acharnés et avides de comprendre le monde puissent pas vous trouver à cause des IA.
(pour répondre à la question 4)
Ca fait longtemps que je surveille les alternatives aux moteurs de recherche existant.
Il est dit ici qu’il faut des moyens considérables pour avoir quelque chose d’efficace. Ca explique pourquoi il n’y en a que 4 (▻https://mamot.fr/@bendineliot/102507200895682574 ) et que les alternatives ne décollent pas.
(question 5)
Tout cela étant dit, politiquement c’est dur de ne pas être d’accord avec les points 1 2 et 3.
Mais j’ai l’impression que l’IA nous dépasse tellement que c’est comme tenter de vivre sans électrons provenant du nucléaire (mon obsession, argh) en France.
Pour répondre à 4 (mais ça répond à 1 2 3 du coup) :
– le moteur interne ne sert que pour les déjà-utilisateurices
– le but de seenthis est bien de publier des contenus utiles à toutes, pas que aux gens qui ont déjà un compte seenthis
– même si le moteur interne était ouvert à toutes : ça n’aurait quasiment aucun intérêt puisque pour ça il faut déjà connaitre le site… or c’est justement le fait que les contenus utiles soient indexables et indexés ailleurs qui fait que des inconnus peuvent les trouver
A propos du fait de trouver SeenThis au moyen d’un moteur de recherche, je n’ai sans doute pas été assez complet dans mes prémisses.
Le chemin que prend la fonctionnalité « moteur de recherche » chez les fournisseurs de cet oligopole est que tu ne trouveras plus de références aux ressources qui répondent à tes questions, mais uniquement des réponses à tes questions rédigées depuis les ressources que tu recherches.
Si on est pessimiste, on conclue que même si SeenThis est indexé, jamais les portails de recherche ne te diront qu’ils ont utilisé son contenu pour répondre à la question posée. De mon côté, j’estime que c’est le chemin qui est en train d’être pris. Mais je sais que je suis exagérément pessimiste, et qu’il va rester possible d’accéder à des moteurs de recherche traditionnels.
Ceci dit. Je n’ai pas découvert SeenThis par un moteur de recherche. On m’a dit qu’il existait, et je m’y suis inscrit et j’y suis resté. Je continue d’y alimenter mon compte. Alors même que j’apprécie aussi Mastodon et que je continue régulièrement de me demander pourquoi je n’ouvre pas une instance autonome de Mastodon... (je le sais, il faudrait la maintenir, et j’ai déjà bien assez de choses à maintenir... et il faudrait la modérer, et je déteste modérer et fréquenter les gens qui s’amusent avec les modérateurs... et surtout, il faudrait éviter de se faire bloquer par les autres instances, et quoi que très diplomate, j’ai quelques doutes quant à ce que l’instance reste connectée avec le reste du monde bien longtemps, à cause de la modération en particulier).
J’ai essayé régulièrement, de retrouver certains de mes billets techniques au moyen des moteurs de recherche internes et externes, et je dois dire que j’ai toujours eu du mal pour les retrouver !
Ce que je veux dire, c’est que je ne crois pas qu’on découvre SeenThis par les moteurs de recherche. Par contre, comme pour un site vitrine, on en vérifie l’existence et la notoriété, assurément.

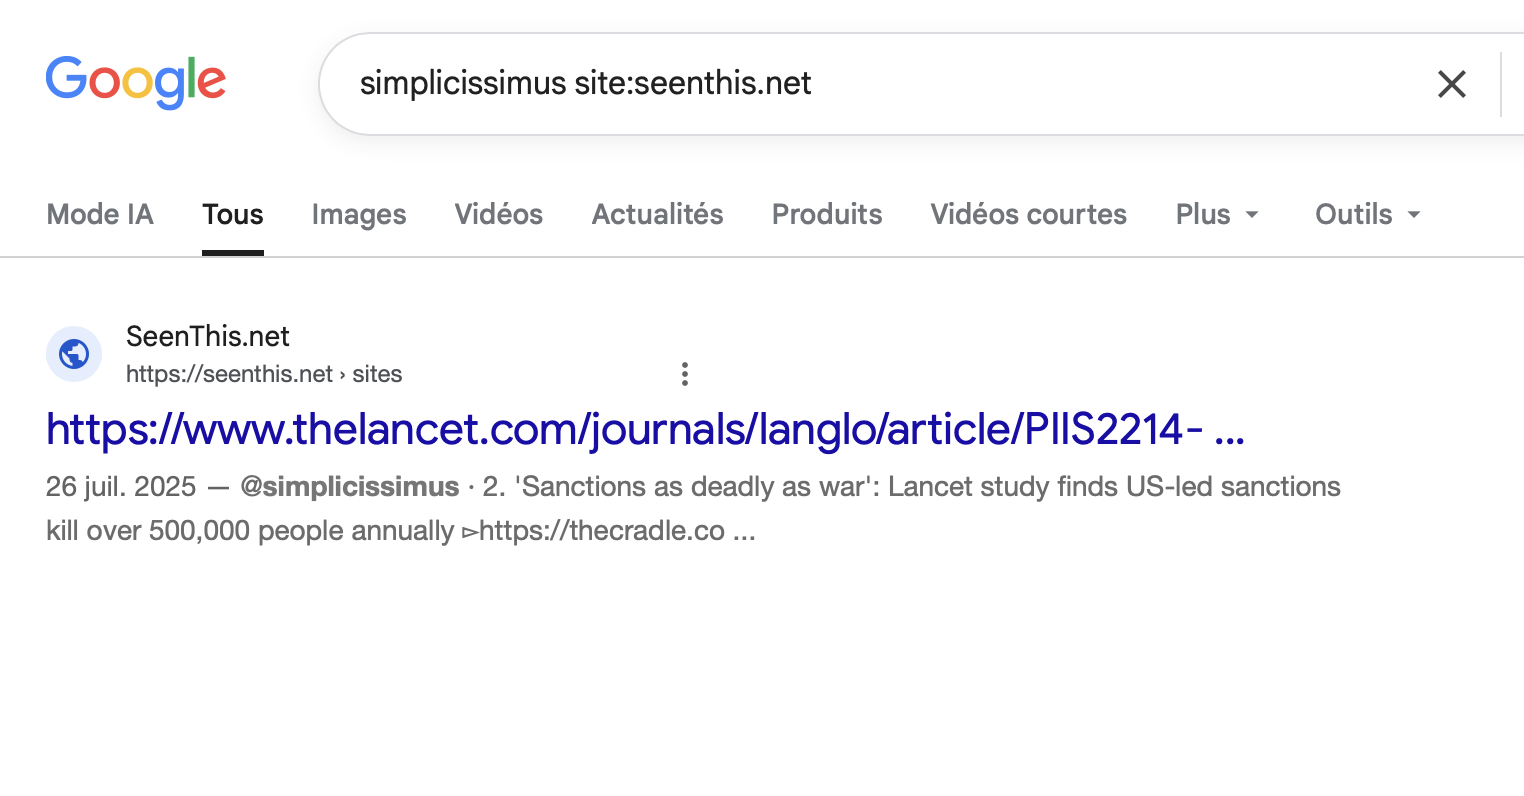
Je n’ai pas non plus découvert seenthis par un moteur mais il m’est arrivé de chercher des seen en utilisant un moteur externe (faute de trouver).
Là, comme le dit @simplicissimus, il semble que cela ne fonctionne plus (si par exemple je tape « chômeurs seenthis » y a R a part l’accès à un résumé de ce que seenthis relaie, qui est catastrophique).
HS : pour les personnes qui galèrent pour retrouver un de leurs post ou un de ceux qu’elles ont étoilés, je rappelle l’existence de ce plugin firefox dont je suis le seul utilisateur à ce jour ^^
►https://addons.mozilla.org/fr/firefox/addon/seenthis-search
@b_b : c’est amusant car cet après midi, je suis tombé sur cette page en suivant justement un moteur de recherche, en l’occurence Zotop de chez Zaclys.
Et il y avait quelques résultats qui matchaient avec seenthis.net dont celui-ci :
Je ne me sens pas très légitime pour intervenir ici parce que je ne suis pas développeur informatique, à peine bidouilleur, et pas celui qui a le plus d’ancienneté. D’ailleurs je ne vais pas prendre position faute d’avoir une opinion et encore moins une solution sur ce serpent diabolique qui se mord la queue.
Mais je veux quand même en profiter pour dire deux trois choses :
Premièrement une grande gratitude pour toutes celles et ceux qui ont bâti ce truc seenthis improbable et le maintiennent.
Depuis quelques semaines je prends un peu plus conscience de l’ampleur de l’impasse dans laquelle se trouvent plein d’organisations avec le pillage par l’IA et le tournant historique des moteurs de recherche. Le fait que des créateurs de contenu (et souvent ce sont les meilleurs) se retirent de la toile me terrifie. C’est une bibliothèque qui brûle (et nous regardons ailleurs ;-)
Et il y a tous ceux qui ont un modèle économique qui s’effondre. Dans le tas, il y a des gentils : petits e-commerçants, petits producteurs de contenus indépendants, médias alternatifs, artistes... Que restera-t-il dans seulement un an ?
Je comprends mieux maintenant l’atrophie totale vers laquelle le nouveau paradigme mène internet.
Finalement cela produit une sensation de fin d’un monde très perturbant. Un monde dans lequel je savais bien nager. D’une certaine manière, je faisais partie des winers de ce monde. Rien que cette prise de conscience me donne à réfléchir.
Internet était riche, il s’appauvrit. Dans seulement un an, je pense qu’on pourra parler de méga enshittification, ou d’enshittification totale ou finale.
Quand le supermarché ne vend plus que de la merde, on se demande si ce n’était pas lui qui était de la merde depuis tout ce temps malgré son sympathique rayon de bières artisanales locales... et il est temps d’aller au marché de producteurs et à l’épicerie autogérée.
On arrête tout, on réfléchit, et c’est pas triste. Réduire beaucoup beaucoup beaucoup les écrans comme Odilon, c’est l’avenir, surtout si ça se remplace par des trucs bien.
Désolé, tout ça n’aidera même pas à prendre une décision. C’est juste un partage d’état d’âme.
La discussion n’est pas technique, à mon sens. Elle est sur les principes : dans quelle mesure où ouvre le contenu aux robots et aux milliardaires, c’est à dire dans quelle mesure où on offre des ressources matérielles et intellectuelles, gratuitement, et avec un espoir de retour proche de zéro, voire négatif.
Jusqu’alors, la promesse de Google, c’était que Google allait dire qu’on existe, et nous on allait dire que c’est génial, Google ils aident à ce qu’on existe. Mais comme chez Google et chez les autres, ils sont en situation d’oligopole, ils ont décidé que le service rendu, dire qu’on existe, ce n’était pas assez rémunéré.
Alors. Donc. Voilà. Tout le monde peut participer à la discussion. :-)
Il y a aussi le sujet des flux RSS. Je ne pensais pas qu’un jour j’en arriverais à dire qu’ils sont nocifs. Mais sur SeenThis, leur nombre, et leur consommation par des bots avides, est à mon avis une des explications au fait qu’on ait des difficultés sur certains traitements, lorsqu’il y a de la montée en charge. Et ça pose donc la question de la pertinence d’avoir de laisser ces flux en accès libre (sans Anubis). Mais c’est un autre débat. Mais c’est un débat aussi.
@biggrizzly une piste alternative à anubis qui remonte souvent ces temps-ci est iocaine ▻https://iocaine.madhouse-project.org
- Serve identifiable bots garbage, with poisoned urls
– Anything that hits a poisoned url gets 12 hours on the firewall.
source ▻https://mastodon.roflcopter.fr/@algernon@come-from.mad-scientist.club/117036039914052825
À étudier...
C’est drôle, la dernière mise à jour de SPIP sur SeenThis a désactivé un élément de protection que j’avais placé à la sauvage dans le code de SPIP. Ce qui fait que plus aucun bot ne se fait bloquer du tout.
Le résultat est en quelque sorte édifiant.
Tu veux avoir le droit d’exister sur Internet ? Y compris en activant Anubis. Alors accepte de devoir assumer un trafic multiplié par 10.
C’est en quelque sorte le tribut au dieu de l’Internet que tout un chacun se doit de verser.
Vous aurez noté que certains posts créés par RSS ne se créent plus convenablement (par exemple XKCD du jour). Ceci expliquant donc cela.
Et donc ça c’est même avec Anubis… et c’était quoi le blocage ajouté en plus ?
SPIP a une protection sur le load du serveur. De plus, cette protection ajoute un aléa. Quand le load est trop élevé, les bots reçoivent une erreur 429. Sur la machine SeenThis, il y a un paramètre (une jail) fail2ban qui bloque les IP qui génèrent des erreurs 429. Dans la version personnalisée à la sauvage de SPIP, il n’y a pas d’aléas à l’envoi de l’erreur 429, et le load est toujours trop élevé. Et donc, les IP des bots sont systématiquement bannies au bout de 2 tentatives.
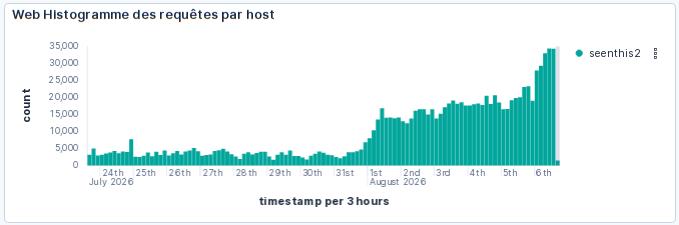
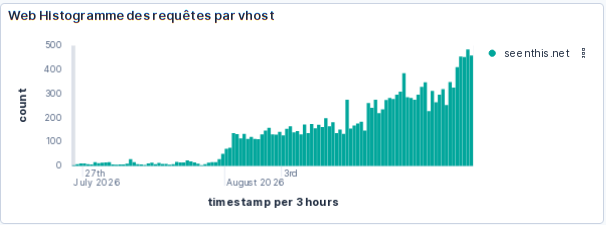
Le graph des requêtes avant Anubis a environ le même aspect en moins pire. C’est à dire qu’il y a une croissance du trafic. Je tâcherais de sortir les deux graphs la prochaine fois que j’allume le PC :-)
Arf, désolé @biggrizzly je ne savais pas et ne pouvais pas le savoir puisque l’installation n’était pas en git. Maintenant que c’est le cas, je pourrai faire les prochaines mises à jour sans perdre tes modifs.
PS : il serait peut-être intéressant d’ajouter un point d’entrée dans SPIP pour permettre ta modif de manière plus pérenne. On en cause la semaine prochaine si tu veux.
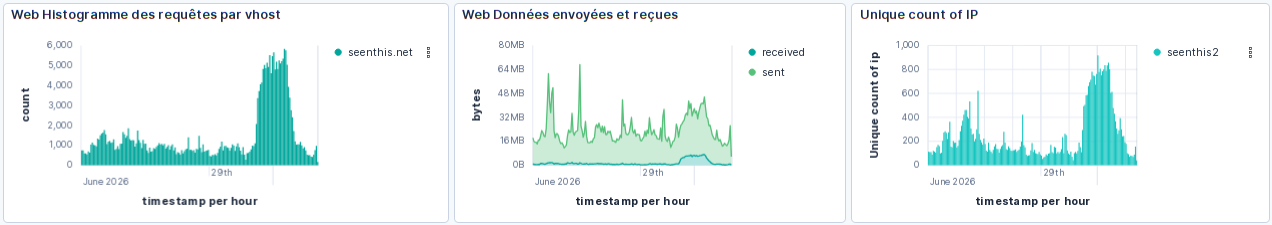
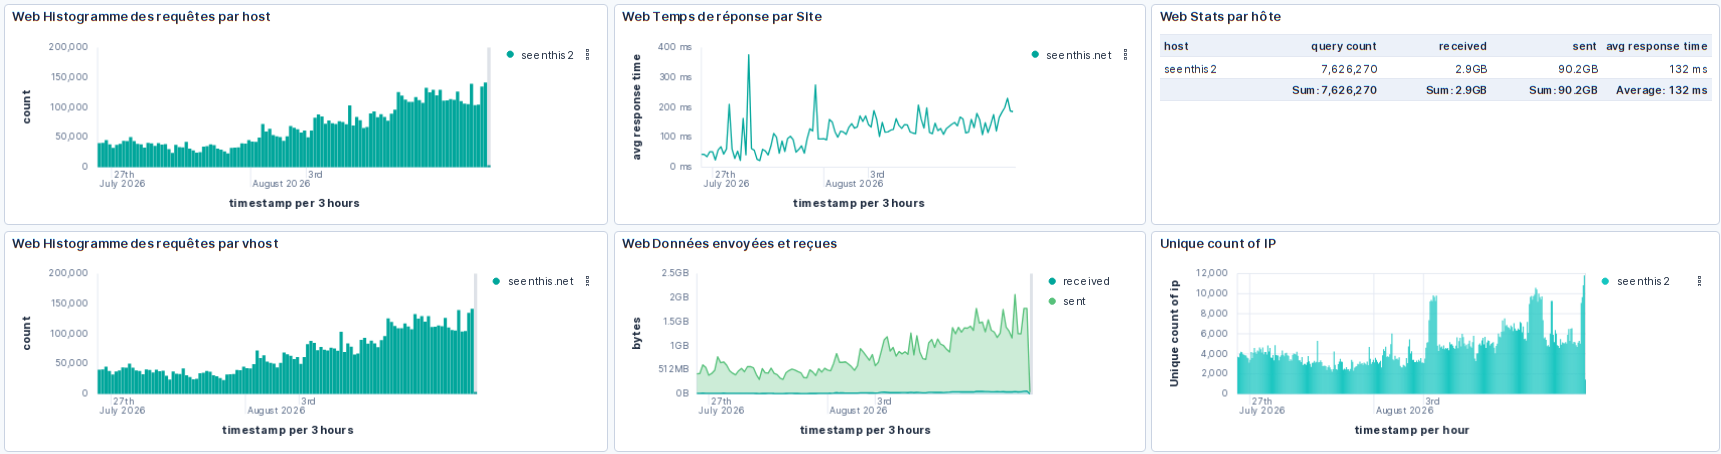
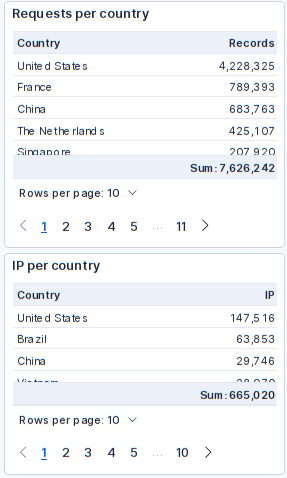
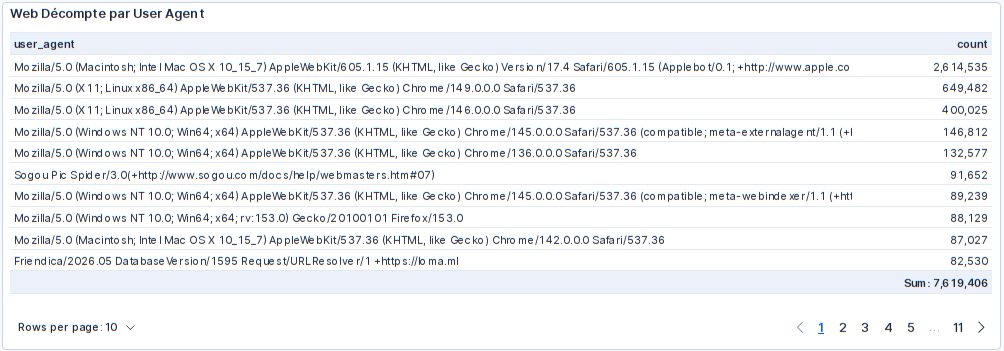
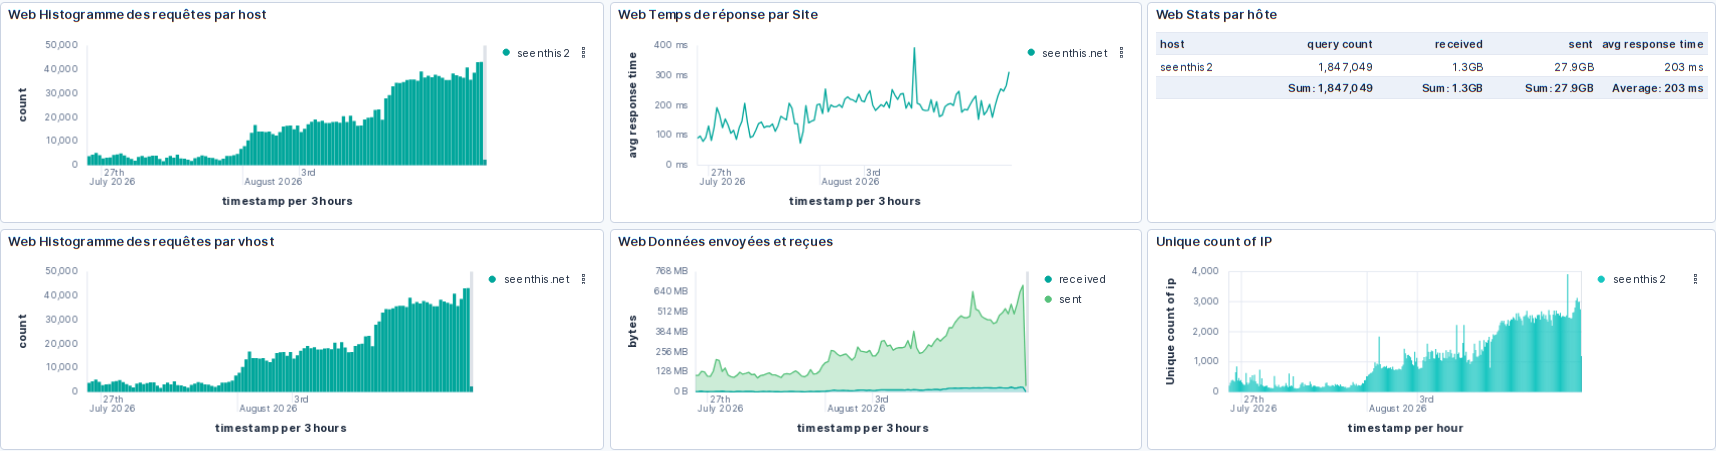
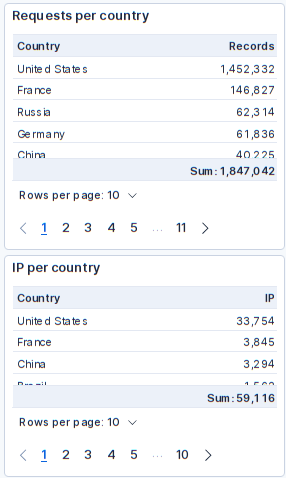
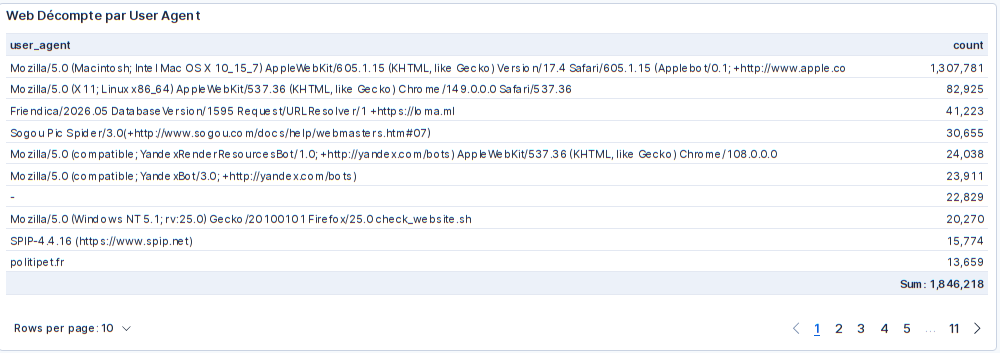
C’est amusant de voir la différence de volume avant/après Anubis.
L’analyse sur les IP est intéressante aussi. On voit que les chinois ne passent pas (encore) Anubis.
Et on constate que Apple est très ouvert dans son comportement. Il n’a qu’un seul user-agent, mais qu’est-ce qu’il est gourmand !
Avant Anubis :
 https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/C7fcOGZx2vGR/rRGxLUUoe1T4YmDyOPiONJpZpd7KHRLjF0tblsvc.png
 https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/u1yyNDnFDFJd/EjUfjMDxSfIZmgc3wZb6MeBFhFK5RRXhPnYMwFKn.png
 https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/S7g4gymER2Qb/hk0saYaSYWGBlsKU1ZChdgzQbQwzzMdxFLIfdRCe.png
Après Anubis :
 https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/fotisJifJXLh/6iwRN1C3UXxNs9hnMBJQtmRJPUaaQsnItCWAnh3l.png
 https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/ICGJOJN5nHS2/ohYOciDZsadvr7eg9FEdVKxADnrw3xRuD7M9KGOj.png
 https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/3wAfLmSfPgXs/YRD9M9Q3UrXPxTtyWhI1QJjILJTcJwt7oU35risj.png
Si, comme vous semblez le vouloir, il faut s’ouvrir à fond les ballons à tous les techbros-sauveurs-du-capitalisme de la planète, je dirais qu’il faut améliorer SeenThis dans les directions déjà mentionnées dix fois je crois :
1. Améliorer le fonctionnement du CRON interne, pour qu’il ne s’exécute pour de vrai qu’une seule fois par minute.
2. Améliorer le fonctionnement de la création des posts par RSS, pour qu’ils ne se retrouvent pas bloqués par la surcharge du serveur, liée aux bots.
3. Améliorer certaines requêtes très lentes (calcul des fils avec blocages).
On pourra aussi sans doute, aussi, un de ces jours, réfléchir à la façon de construire les flux RSS sans qu’ils n’engendrent eux même des soucis de concurrence sur la base de données. Parce que si on ne les protège pas par Anubis, ils sont consommés à un rythme infernal.
1. Améliorer le fonctionnement du CRON interne, pour qu’il ne s’exécute pour de vrai qu’une seule fois par minute.
Est-ce souhaitable, car ça veut dire seulement pile 1440 fois par jour, alors que s’il y a beaucoup de tâches de fond à faire, les jobs de SPIP se lancent « quand il y a un truc à faire » dès lors qu’il y a un hit PHP par quelqu’un (humain ou robot qui passe les portes).
Quand il n’y a aucune tâche à faire à un instant T… ce cron n’est censé rien faire non ? Donc ça fait quoi comme surcharge, ça lance quoi de trop que ça ne devrait pas lancer ? Juste la « recherche de tâches à faire » (qui est vide si plus rien en stock) est déjà trop gourmande ?
2. Améliorer le fonctionnement de la création des posts par RSS, pour qu’ils ne se retrouvent pas bloqués par la surcharge du serveur, liée aux bots.
Ça se fait justement… dans les jobs/cron, donc si ça se lance plein de fois : ça fait avancer plus souvent l’importation. Là encore le diagnostique n’est super clair : c’est quoi qui bloque quoi ? Et de quelle manière ça bloque plus l’import de seen que les créations manuels par un humain dans l’interface ?
3. Améliorer certaines requêtes très lentes (calcul des fils avec blocages).
C’est le seul point pour lequel sans plus d’infos je pourrai avoir une intuition dont on avait parlé ya 5 ans ou plus déjà : si on s’assure d’indexer assez des bonnes informations nécessaires dans Manticore, alors l’ensemble des fils du site pourraient être générés avec, et non pas juste la page de recherche. Au moins les boucles principales de sélection. Càd : toutes les listes de chaque auteurices, tous les RSS, et les accueils de chaque personne et des anonymes. Les boucles/requêtes de Manticore sont beaucoup, beaucoup, plus rapides que les requêtes MySQL à priori.
Autre graphique : nombre de requêtes qui durent plus de 5 secondes sur les 14 derniers jours.
Plus il y a de monde qui consulte le site, plus il y a de pages qui se retrouvent bloquées.
Il y a un souci de concurrence dans le code de seenthis, souci à corriger d’une façon ou d’une autre ; j’ignore où il se situe, et je ne fais en l’état que des propositions de pistes de recherche.
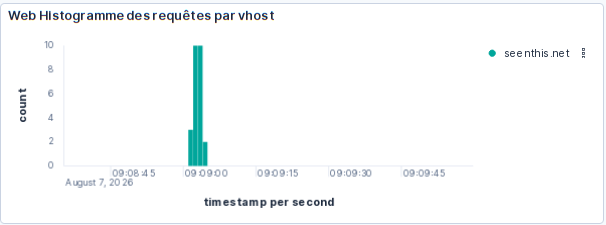
J’évoque le CRON car parfois, dans le passé, avant Anubis, j’ai constaté qu’il s’appelait de très nombreuses fois dans des intervalles de temps très courts, sans aucune raison valable. Du fait d’Anubis, je ne vois pas de cas comparable en ce moment. Je note des pics, avec des appels concentrés sur une même seconde.
Ici, on voit qu’à 09h09 le 7 août, on a une vingtaine d’appels. Je soupçonne des soucis de ce point de vue là, s’il manque une vraie section critique. Ceci dit, ces appels, présentement, ont tous duré moins de 100ms.
Par principe, je désapprouve les webcrons. Quand on a besoin de faire exécuter qq chose régulièrement, si on en a la possibilité, je trouve un vrai gestionnaire de tâches planifiées préférable. Mais si le CRON de SPIP est conforme tant mieux. Il n’empêche qu’il lui arrive de s’emballer, à mon sens, de ce que je vois dans les journaux apache.
Concernant les posts créés par RSS, dès qu’il y a de la concurrence, ils apparaissent sans contenu dans les fils. Pendant toute la durée de bannissement des bots, les posts RSS se sont créés sans difficultés. Depuis que c’est rouvert, on a à nouveau de tels soucis. Ceci dit ces soucis se résolvent d’eux même quand les posts passent en page 2. C’est apparemment un souci de mise en cache du post, quand le post est créé, et qu’en même temps la page d’accueil est réclamée.
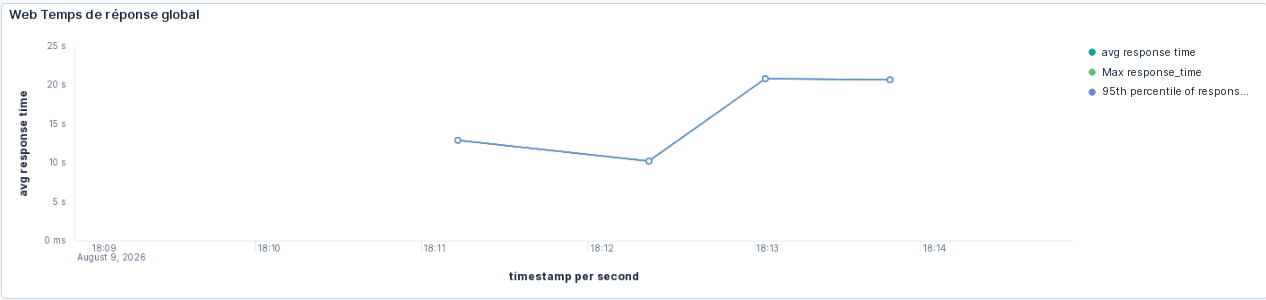
L’envoi de mon commentaire a pris plus de 8 secondes. Ce n’est pas normal. Et ça n’a lieu qu’en situation de forte charge.
(bis, ce second commentaire aussi, plus de 8 secondes)
(ter, la validation de la modification du commentaire, plus de 20 secondes)
Confirmation par les journaux : mes 4 validations successives.
Pas un souci de concurrence pour le coup, y-a pas de surcharge présentement. Ça doit être lié à la structure de ce post plein de commentaires ?
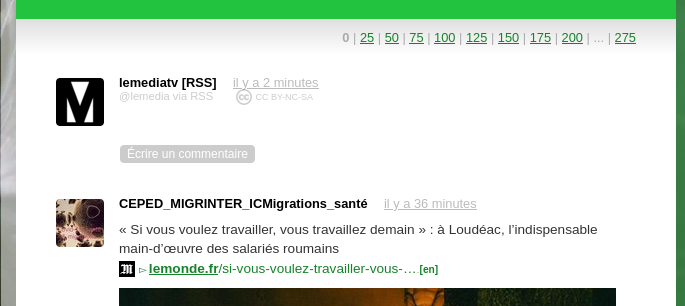
C’est chouette, je tombe juste sur le souci de création de post depuis un RSS. Sur mon fil, ça affiche ça :
99% of My Website Traffic Is Bots
▻https://patronview.com/news/99-percent-of-my-website-traffic-is-bots
Les observations et contre-mesures d’un autre galérien, lui avec Cloudflare.
@biggrizzly pour info, je viens de mettre à jour #seenthis en SPIP 4.4.18. J’ai vérifié avant de le faire, et il n’y avait pas de modifications locales. Je reviendrais plus tard dans ce fil pour discuter des points que tu listes plus haut.
Juste pour discuter.
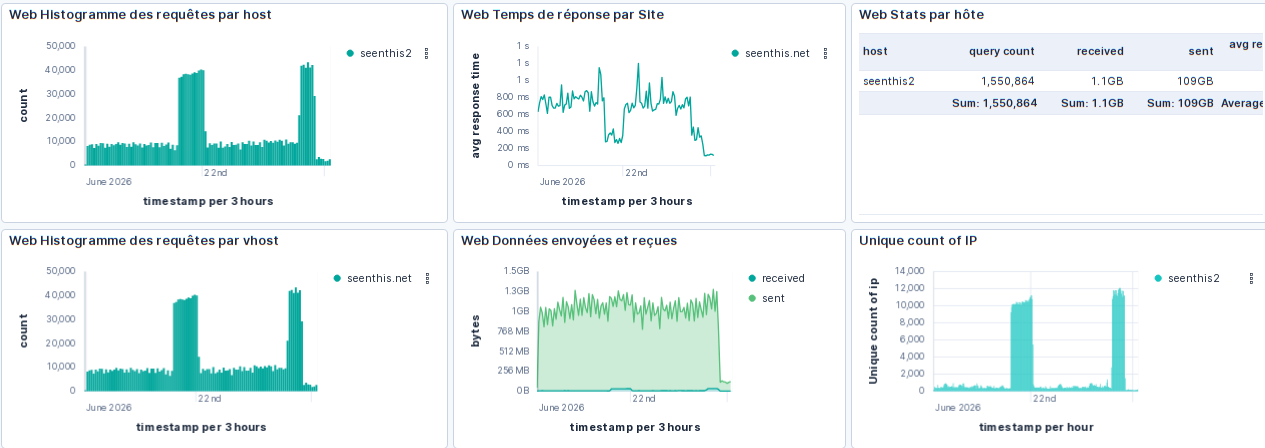
On vient de faire un point sur la journalisation de nos serveurs web, qui permet de visualiser les stats comme dans mes commentaires précédents.
On confirme le avant/après blocage des bots
– Avant Anubis, trafic sans bots = 1, trafic avec bots = 6
– Après Anubis, trafic sans bots = 1, trafic avec bots = 10
On a multiplié le trafic par 10 depuis que les bots sont libres de consommer SeenThis.
On ne stocke que 3 mois de journaux pour SeenThis. Mais un trafic multiplié par 10, plus le trafic supplémentaire impliqué par Anubis, ça augmente l’espace nécessaire pour les journaux.
On doit aussi gérer d’autres absurdités des bots sur d’autres serveurs web. Par exemple le cas de ce bot meta qui consomme en continu les photos d’un blog qui a commencé sa vie au début du siècle. Des millions de lecture de photos lues et relues, toujours les mêmes, consommées en continu. On a bloqué meta globalement sur ce serveur mutualisé. C’est tellement absurde.
Malgré nos mesures de nettoyage et de blocage, c’est une croissance du trafic qu’on constate, alors même que globalement, les moteurs de recherche, c’est de notoriété publique, ne renvoient plus de visiteurs.
Bref, on ajoute ce matin 100Go de plus sur le serveur dédié aux journaux web, ça fait un petit serveur à 500Go d’espace total. Pour voir venir.
Mon opinion est de plus en plus ferme. Les bots ne servent à rien d’autres qu’à nous imposer de rajouter des ressources sans aucun retour en échange. Le futur de la communication entre humains ne passe pas par les moteurs de recherche mais par les réseaux sociaux distribués. Peut-être devrions-nous tâcher de construire des moteurs de recherche distribués (ça n’existe pas en l’état, consommer des moteurs commerciaux ça n’est pas du moteur de recherche distribué).
StupidAntibot [Wiki de sebsauvage.net]
►https://sebsauvage.net/wiki/doku.php?id=stupidantibot
(...)
Alors bien sûr cela va aussi bloquer les bots indexeurs des moteurs de recherche, mais de toute manière Google n’est déjà plus capable d’afficher des résultats pertinents et il n’amène plus de trafic.
Mon crédo : Écrire pour les humains, pas pour les robots. Donc je m’en fous totalement que tous les robots soient bloqués.
(...)
De l’eau au moulin :-)
Réponses un peu tardives...
1. Améliorer le fonctionnement du CRON interne, pour qu’il ne s’exécute pour de vrai qu’une seule fois par minute.
Je croyais que la solution que je proposais dans ▻https://github.com/seenthis/hebergement/issues/29#issuecomment-4104042165 faisait le job, ça n’est pas le cas ?
2. Améliorer le fonctionnement de la création des posts par RSS, pour qu’ils ne se retrouvent pas bloqués par la surcharge du serveur, liée aux bots.
Ça mérite un ticket dans ▻https://git.spip.net/seenthis/importer-flux/-/work_items :)
3. Améliorer certaines requêtes très lentes (calcul des fils avec blocages).
Ça fait 10 ans qu’on a un ticket à ce sujet ▻https://git.spip.net/seenthis/squelettes/-/work_items/159 mais personne ne s’y jamais vraiment collé :\
Le futur de la communication entre humains ne passe pas par les moteurs de recherche mais par les réseaux sociaux distribués.
Avec le temps qui passe et le peu d’énergies/volontés à dispo pour maintenir seenthis, je pense parfois (souvent ?) qu’une instance masto (ou autre) dédiée aux membres de seenthis ferait très bien le job.
La page que vous recherchez n’existe pas.
hgaiser/moonshine: #headless #streaming server for Moonlight clients, written in Rust.
▻https://github.com/hgaiser/moonshine
— Permalink
garrytan/gstack: Use Garry Tan’s exact Claude Code setup: 23 opinionated tools that serve as CEO, Designer, Eng Manager, Release Manager, Doc Engineer, and QA
▻https://github.com/garrytan/gstack
— Permalink
#softwareengineering #claudecode #generativeai #copilot #teamwork #management #dev
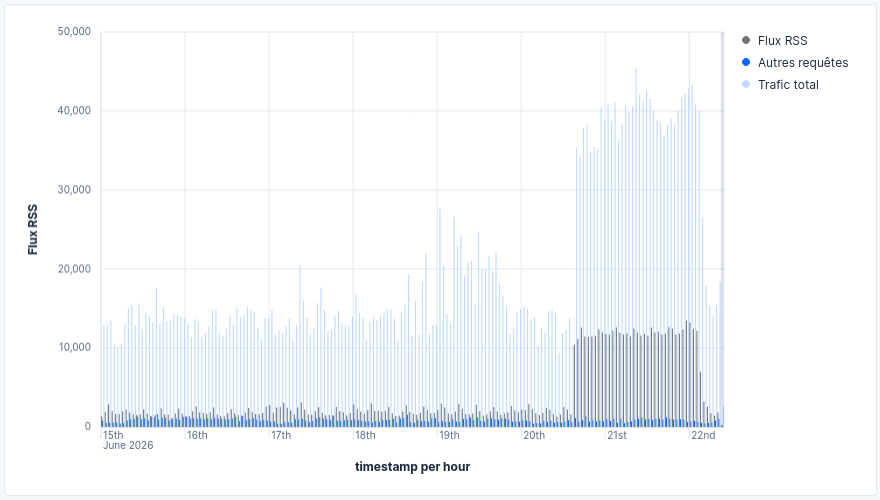
SeenThis, requêtes reçues ces 7 derniers jours.
– Flux RSS : requêtes reçues sur les URL se terminant par /feed ; ces URL ne sont pas protégées par Anubis.
– Autres requêtes : requêtes de la part des navigateurs qui ont réussi à passer Anubis ; elles sont réputées légitimes.
– Trafic total : nombre de requête total, légitimes et illégitimes.
Dans les 48 dernières heures, on a un botnet de taille respectable (300000 ip distinctes) qui a décidé d’avaler toutes les URL /feed, et pas qu’une seule fois chacune. 435000 requêtes.
Autre façon de voir les choses : 10% de trafic humain.

alors la différence entre la somme des colonnes RSS + « Autres requêtes » et la colonnes « Trafic total » correspond au trafic des bots ?
J’ai ajouté un message pour faire le forceur 2 mois après le précédent, mais toujours sur le même ticket fermé : ▻https://github.com/TecharoHQ/anubis/issues/721#issuecomment-4767236192
Ça recommence depuis 24 heures. Des dizaines de milliers de requêtes sur les URL /feed. Ils ont bien vu qu’elles n’étaient pas protégées. Et ça ralentit en conséquence tous les traitements. J’ai réinclus les URL /feed sous protection d’Anubis.
Ça tournait à 4 requêtes /feed par seconde.
Snif bon bah plus d’actus à part 7h36 tant qu’on trouve pas une solution (ou que je déplace la gestion de mes flux RSS/Atom autre part que dans Thunderbird mais j’en ai aucune envie vu qu’une fois récupéré je peux tout lire en local).
Il faut se rendre compte de l’absurdité de la situation. Ci-dessous, les connexions qui passent au travers d’Anubis, y compris, donc /feed, sur les 14 derniers jours. La partie toute réduite à droite, c’est depuis que j’ai coupé /feed...
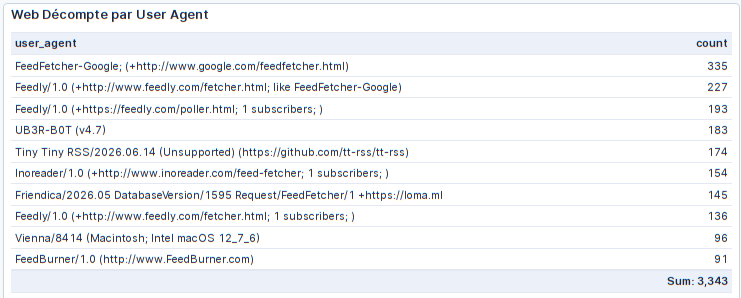
Sur les 14 derniers jours, ce sont près de 500K IP distinctes. Le flux /feed, c’est en continu plus de 8Go/jour de trafic envoyé. Quand on supprime /feed, ça descend à 0,5Go/jour.
Y-a quand même un bon nombre de lecteurs RSS qui passent Anubis, apparemment...
en revanche, le droplet ne passe pas Anubis.
pas grave cependant car il suffit d’ouvrir normalement ST et de franchir la détection avant de réitérer la publication.
Je suis tombé sur la difficulté pour l’anomalie sur le droplet. Comme tu l’indiques, il faut et il suffit d’avoir une page ouverte SeenThis, pour que le droplet fonctionne.
Depuis 06h00 ce matin, les URL /feed sont à nouveau réclamées par des dizaines de milliers d’URL. Anubis stoppe tout, évidemment. Mais tout cela ne milite pas pour un Internet ouvert malheureusement...
Hier, on a eu une hausse forte des visites légitimes. 800 IP uniques et 5000 hits par heure. Les botnets commencent à savoir passer Anubis, apparemment. On a pourtant passé la difficulté à 4, ce qui est assez élevé. On va peut-être tenter de passer au-dessus ?
On va peut-être tenté de passer au-dessus ?
si ça peut ralentir ces s***eries de bots je serais pour : la gène pour les « vrais » visiteurs sera toujours très inférieure à celle d’un site devant gérer un trafic illégitime monstrueux...
Apparemment, passer la difficulté à 5, cela empêcherait les terminaux anciens (android de plus de 6-7 ans) de pouvoir passer le barrage calculatoire.
Avec Anubis, on oblige les botnets à encore plus cramer la planète. C’est consternant.
Avec 0 kH/s sur mon vieux smartphone, j’arrive pourtant à passer Anubis.
Je m’interrogeais sur cette nouvelle mécanique ici : ►https://seenthis.net/messages/1177099
Tu as mis le tag dans ton post. En le suivant, tu trouves l’origine de l’inclusion d’#Anubis.
kH comme ~~kilohertz~~ kiloHash.
Mon smartphone est un samsung S de 2019, et il n’est jamais vraiment bloqué par Anubis, même avec la difficulté de 4.
Si du monde nous lit, je serais intéressé de savoir si Anubis vous bloque longtemps ?
H, c’est hashes, pas hertz. C’est un calcul de checksum, une preuve de travail.
▻https://yumechi.jp/en/blog/2025/proof-of-mutex-outspeeding-anubis-with-valid-pow
Ah, OK. C’est sans doute du fait de ne pas m’être assez intéressé au minage...
À l’instant, environ 6 secondes sur un iPhone 11.
Sinon, y’a pas une version d’Anubis qui permet de miner du bitcoin en mode décentralisé ?
J’ai passé du temps à installer Miniflux, un lecteur webapp, sur mon serveur, et tout configurer… pour rien. Miniflux, comme curl, ne sait pas passer Anubis, et les devs disent eux aussi qu’il faut ajouter des règles de bypass pour Miniflux si on veut que ça marche : c’est pas à eux d’ajouter du code tordu pour savoir lire et passer les tests JS, ils veulent que leur code reste simple.
Donc tout ce temps pour rien… et toujours pas d’infos depuis 2 mois à part 7h36 (c’était les vacances d’actus on va dire).
Par contre dans Miniflux je peux personnaliser le user agent qui appelera le flux. Du coup si on convient d’un truc secret que je mets dedans et que tu ajoutes cette chaine en bypass ça pourrait marcher ?
Tu peux tjs me filer l’ip fixe de ton serveur...
Vous êtes un humain, et vous voulez consommer les flux RSS de SeenThis ? Il vous faut une IP fixe pour cela. Si vous en avez une, envoyez-là nous, et on l’ajoutera en liste blanche d’Anubis.
Résumé :
– avec l’IP fixe, du coup ça remarche aussi dans mon Thunderbird tant que je suis à la maison
– mais au passage j’ai donc installé une instance de Miniflux (agrégateur-lecteur libre et rapide sans fioritures) sur mon serveur d’outils perso… ça marche aussi donc… si yen a qui veulent pas donner les infos de ce qu’ils suivent à des services privés, je peux toujours créer d’autres comptes, c’est multi-utilisateurices

GitHub - lenucksi/aur-malware-check: Detection tools for the June 2026 atomic-lockfile AUR supply-chain attack. Consolidated from community Gists. · GitHub
▻https://github.com/lenucksi/aur-malware-check
git clone ▻https://github.com/lenucksi/aur-malware-check.git cd aur-malware-check ./aur_check-v2.sh —full et aussi ./aur_check-v2.sh —refresh —full
-- Permalien
ddocs.new — Fileverse · GitHub
▻https://github.com/fileverse
End-to-end encrypted workspace & collaboration apps - Fileverse 💛 ddocs.new ▻http://ddocs.new (Public Beta) is your privacy-enhancing alternative to Google Docs: end-to-end encrypted and decentralized. It supports both async and real-time collaboration, works seamlessly on mobile and desktop, and doesn’t require an account. With dDocs you can write, collaborate, and share knowledge in a self-sovereign way and without sacrificing privacy. 👩🏭 dsheets.new ▻http://dsheets.new (Public Beta): no-code query, read and manipulate financial & onchain data. Use it as your decentralized alternative to Excel and Google Sheets. Built on the same middleware as dDocs which guarantees your self-sovereignty & privacy, by design. Spreadsheets are the world’s most popular reactive functional (…)
Jeremiah Fieldhaven: #rsync, since 3.4.1, 36 commits by “#tridge and #claude” - Mastodon
▻https://mastodon.gamedev.place/@JeremiahFieldhaven/116654345332213390
So my systems recently updated to rsync 3.4.3, and as soon as that happened my backup system - which does incremental backups using multiple —compare-dest= arguments - started to fail on anything but a full backup.
Revert to 3.4.1 and it works.
So I go look at the source in #GitHub to see what might have changed, because there doesn’t seem to be anything relevant in the changelog.
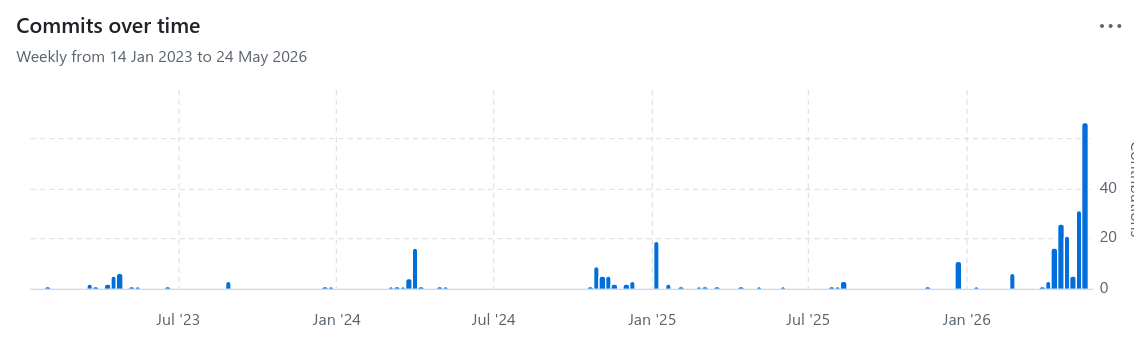
Since 3.4.1, 36 commits by “tridge and claude”
Oh for fuck’s sakes.
Typique de : correlation n’est pas causalité. Et donc ce post ne dit rien d’autre que la panique de son auteur (pour l’instant).
L’histoire ne dit pas si c’est précisément un commit « tridge and claude » qui provoque le nouveau bug ajouté (il y a aussi plein d’autres commits sans claude, et aussi des commits d’autres que tridge le créateur).
Ça peut, mais rien ne le montre pour l’instant. Imaginons :
– tridge, qui n’est pas le premier venu (créateur de rsync…), utilise Claude en relisant super sérieusement le résultat, et ça ne vient d’aucun de ces commits là
– que le bug vienne en fait d’un commit d’une autre personne OU de tridge sans Claude
Alors ça ne serait qu’un post de plus de panique moral, et qui ne dit rien de plus.
Donc attendons le vrai commit fautif exact ?
Laura - Mastodon
▻https://chaos.social/@codingcatgirl/116657307599659520
Sorry to be the bearer of bad news, but almost all commits on rsync since March 1st 2026 have been Claude Code.
rrsync refuses “absolute” source path (starting with /) · Issue #922 · RsyncProject/rsync
▻https://github.com/RsyncProject/rsync/issues/922
d4c4f67 added a single line to rrsync to “remove multiple leading slashes”. By removing all leading slashes, this line ensures that the test for a leading slash four lines further down never succeeds and “absolute” paths below the rrsync base directory are not appended to that base directory anymore. This breaks rsync calls with, e.g., source path /.
jonny (nonvenomous) - Mastodonc
▻https://neuromatch.social/@jonny/116657411750038515
all the criticism has been said, all the takes been had. the only metaphor i have been finding consistently useful for understanding what is happening with people and “AI” is addiction, and specifically gambling addiction.
i love gambling. i have used “AI” extensively. it feels the same.
So, look. One shot rewriting the whole test suite in another language is probably not great to do, but what happened here is so much worse than you are expecting.
▻https://github.com/RsyncProject/rsync/pull/903
This does not “translate tests into pytest” or a unit testing framework, it writes its own testing framework where tests are whole python scripts that redefine basic test functions in every script. Surely there would be a single way to “run rsync and get the results” - nope, well, there is, but then every test file will randomly redefine its own _run_and_capture function. So like now rsync needs a test suite for its test suite.
If instead of telling an LLM to “rewrite the tests in python” you just searched “python testing” you would find the pytest docs. And then you would find examples. And then you could write fixtures to deduplicate all the prior shell script setup and teardown stuff, and so on. But since it was just “rewrite the tests in python” its now worse than before, and the odds of the rewrite actually being a 100% faithful translation are close to 0.
I think the modal situation here is that the people are reading none or very little of what is being generated by the LLM, so the tests have a special role: Tests function as the pull arm on the slot machine, you just generate until tests pass, and that’s a jackpot. Obviously that’s meaningless when the tests are meaningless, so tests take on a very different meaning and role in slot machine coding.
Previously we would write careful test conditions that were based off some real problem or an understanding of what the code under test did, and had a specific thing they were intended to protect against. Tests move slow and are designed to protect us against the things we know can go wrong. When we learn of a new wrong thing, we add a test.
LLM tests have the form of tests but don’t do the same thing. They often test nothing, and are just expressions of truisms that the probabilistic text space explored while generating. They have strongly worded names but end up actually asserting that basic language features work as expected. Because it is not us writing tests for ourselves, where we only harm ourselves by making them weak, they function instead as a passively obfuscated justification for the code that the LLM generates. The user wants the tests to pass. The LLM provides.
The tests are theater: they are the play field for the slot machine. They are mild, surmountable, need to fail a few times to be plausible, but must eventually pass within the expected generation loop window to deliver the payout.
Here’s an example from some code that was thrust at me this week. The rest of the tests try a bit harder to look like tests, but this one is perplexing.
What does it test? The function name suggests its a smoke test. LLMs love to call things smoke tests. That would suggest this would be an early-run test that fails loudly if some basic precondition - like having ffmpeg - fails. Or, I guess we are smoke testing the ensure_ffmpeg function? Anyway who knows. However we first check if ffmpeg or ffprobe are present, which is exactly what ensure_ffmpeg does. If they aren’t present, a warning tells us that ffmpeg/ffprobe are required for the video tests, which makes it seem like this should be a parameterizing test that controls which tests are run, which of course it does not do.
So the test literally does nothing and cannot possibly fail, but says it does at least two things, because to an LLM something saying it does something is the same thing as it actually doing that thing.
Edit: I’m seeing some comments that suggest ppl think this example is from rsync, as said at top, this is just an example that came my way in a different project and I’m using it to illustrate a common LLM test problem.
rsync and outrage. I gave up blogging a long time ago… | by Andrew Tridgell | Jun, 2026 | Medium
▻https://medium.com/@tridge60/rsync-and-outrage-d9849599e5a0
I gave up blogging a long time ago (apart from an occasional thing about ArduPilot), I tend to just write code and hope people find it useful, so it feels a bit odd to be writing this, but given the volume of rage posts I’ve been on the receiving end of lately I thought maybe I should post something.
Like many developers of open source packages I’ve been hit by a flood of security reports lately in my role as the rsync maintainer. Many of those reports are AI generated (not all though, there are some notable ones with very careful and high quality manual analysis).
I’m retired (though my wife may dispute that!) and I’d rather be out sailing than working on rsync security issues, so I have reached for several AI tools to help with what needs to be done. I have absolutely no regrets about doing that, although from the storm of anti-AI rage it’s clear that many people think I should be hung up by my toe nails and flogged for even considering doing this.
[…]
I did the design for that myself (and I’m really quite pleased with it), but used claude with cross-checks from codex and gemini to do the grunt work. I did not just vibe-code “convert test suite to python”. I’m a software engineer with 40 years experience (yeah, I’m OLD!), so I did a design first and had a plan for how to validate it. I used AI tools to do the grunt work because they are good at that. I reviewed every part of it myself and ran through a huge amount of CI time getting it right (I’m since moved to having a bunch of local VMs to do most testing to reduce the CI wait time). What you see in the commit history with co-authored by claude is the tip of the proverbial software engineering iceberg.
[…]
for the people saying things like “I’m a PhD from xyz uni and I’m telling your LLMs are just stochastic tools that make everything up and the world will fall apart if you use them”, I’m here to tell you that you are out of date. The world of software engineering has changed dramatically in the last few months. The world of IT security and maintaining software in the face of the flood of reports has completely and utterly changed just in the last few weeks. Anything you learned about this stuff last year might as well be from another planet.
[…]
Bottom line is I do know (well, roughly!) how LLMs work, but that doesn’t make them not useful. It does mean you have to be cautious, but I am being cautious, or as cautious as I can be given my desire to be sailing and not dealing with a flood of gunk from so-called internet experts.
A un moment, il met le doigt sur un point, qu’on peut considérer sans intérêt. Mais.
I’m trying to decide at the moment between a 3.4.4 release that softens some of the regressions and going for the 3.5.0 that I had planned with much larger changes. The 3.5 release will raise the bar enormously with regards to rsync security, but it is a huge change. The large change set that is needed was a big motivation for the effort on the test suite rewrite — you can’t do a rapid large change to a piece of software like rsync without a really comprehensive test suite. I thought it would be a good idea to do the core structure for the new test suite in public on master first though given all the rage that has generated maybe that was a bad idea. Anyway, the new test suite has helped a lot, and I have a big pile of additional tests for security related issues that you can all enjoy reading when 3.5 comes out.
Ces projets essentiels ne devraient pas reposer uniquement sur la bonne volonté d’un seul gars, même hyper-doué.
Le projet curl est exemplaire à cet égard. Daniel Stenberg s’en sort plutôt bien. Au moins, il communique. Et il n’est pas seul.
Bah ça c’est un truc très très connu des projets open source, et du fait qu’un nombre énormes de projets centraux sont toujours maintenus par un unique gars sous l’eau, avec un opensource burn out.
Rsync opens the slopgates, regressions and bugs ensue – OSnews
▻https://www.osnews.com/story/145198/rsync-opens-the-slopgates-regressions-and-bugs-ensue
Andrew Tridgell, developer of rsync, has published a blog post addressing the massive surge in “AI” code submissions and the string of regressions supposedly caused by them. He explains rsync was flooded with “AI”-generated security reports, and he couldn’t handle the volumes anymore.
(...)
Tridgell’s blog post already has all the usual talking points from “AI” techbros about how the tools sucked last [year][month][week] but they’re good now, trust me I know how these tools work, humans are actually the same as these “AI” tools, really what is intelligence anyway, and yeah we got a whole slew of new issues caused by the “AI” code but more “AI” code will surely fix that, and so on. There’s some red flags that give me the ick, because I’ve seen them all before from people entirely losing themselves in “AI” hype.
Tridgell also takes pot shots at openrsync, a reimplmentation of rsync developed by the OpenBSD team, also shipped by default on macOS. Openrsync has nothing to do with any of the current issues rsync is facing, as the project was started way back in 2018 or so. Taking pot shots at this project in this particular blog post feels childish and unnecessary, and reeks of insecurity; focus on the issues your own project is facing before attacking some other project. This feels like another red flag.
(...)
[object Object] - Mastodon
▻https://mas.to/@zzt/116689607026693907
computer fuckers really will swoon about the nuanced position taken by the author of a blog post that declares that all of the PhDs who disagree with them are wrong and LLMs work exactly like human brains because they said so and also help help they’re the victim of an online hate mob because they did something fucked up and someone else noticed
maybe keep the word nuance out of your fucking mouth if your version of nuance is indistinguishable from being a contrarian asshole
you really don’t have to tie your brain into knots to make this into the kind of story where a person you already lionized was the victim of an unthinking angry mob, but you will because doing analysis is much harder than just claiming nuance
within the past 24 hours I’ve watched two people claim there was nuance to the rsync story that made tridge right, and after not too much discussion they admitted they didn’t know rsync’s slop code only got noticed after a severe breakage occurred, or that people have evaluated the slop commits and found them to be of extraordinarily poor quality (including rendering rsync’s test suite ineffective by translating it from bash into broken python). the story they heard is that someone saw Claude in the commit log and freaked out and directed harassment towards tridge. they seemed to be under the false impression that rsync still worked fine.
how is it that the members of the supposed angry mob are doing deeper analysis than the people claiming nuance?
(...)
there might well be people who legitimately went overboard on the guy and that’s awful
what I’ve seen is exactly along the lines of what you described though: people are exhausted and filled with anxiety because a core tool broke and is promising more breakages. it keeps happening and it happened yet again, to a tool that was previously understood to be done. it’s both insult and injury.
what’s interesting in this case is how many distro maintainers responded negatively but reasonably: first with exhaustion, then with a concrete plan to either pin or replace rsync. that feels to me like it might be what’s prompting the accusation that there’s a hate mob. rsync is losing its position, and this is damage control.
Réécrire tout un pan d’un logiciel, avec ou sans IA, ça ne s’improvise pas dans un commit non-annoncé au sein d’une version mineure. Les jeux de test, ce ne sont pas des parties mineures d’un projet. Et le burn-out n’excuse ni n’explique pas tout.
Quand on dit qu’on a plusieurs dizaines d’années d’expérience, on ne se permet pas ce genre d’amateurisme, en expliquant qu’on maîtrise la bête et que si on n’est pas d’accord avec lui, on est des gros nuls.
Sa communication, dans le fond, est catastrophique.
Il fait partie des gens tombés dans le côté obscur de l’IA, à la façon Star Wars.
Halupedia — Halupedia
▻https://halupedia.com
Halupedia is an encyclopedia covering topics that have received insufficient attention in mainstream reference works. Coverage spans historical events, scientific disciplines, geographical features, notable persons, organizations, treaties, academic disputes, and cultural phenomena. Articles are generated on demand and stored permanently upon first request.
The encyclopedia approaches all subjects with equal seriousness regardless of their prominence, scope, or the number of people aware of their existence. Entries follow standard encyclopedic structure and cite relevant scholarly literature throughout.
How it works
Click any linked term inside an article to load its entry. New topics are documented at the moment of first access. Use the Stumble button in the header to navigate to a random existing article.
Minor inconsistencies between entries are a known characteristic of the encyclopedia and fall within acceptable tolerances.
GitHub - BaderBC/halupedia: Encyclopedia that hallucinates articles on the fly
▻https://github.com/BaderBC/halupedia
An infinite, #hallucinated #encyclopedia. Every link leads to an entry that does not exist yet — until you click it, at which point an #LLM pretends it has always existed and writes it for you, in the deadpan register of a 19th-century scholarly press.
Live at halupedia.com. Cooked on a Cloudflare Worker. Cached forever in KV. Threaded HN-style comments under every article, no signup, #AI-hallucinated identities. Patrons may buy us tokens so the press can keep printing. Editors and conspirators meet in the Discord.
#IA