Le blog de Lionel Dricot

https://ploum.net

  • Un manifeste Offpunk
    https://ploum.net/2026-08-03-offpunk_manifesto.html

    Alors que l’hyperconnexion apparait comme le symptôme d’un futur inéluctable, un timide mouvement semble prendre de l’ampleur  : celui de la #déconnexion volontaire et intentionnelle. L’adoption des «  dumb phones  » est en train de croître. Les appareils photo numériques font leur retour. Tout comme les cassettes audio et les machines à écrire… Il existe un mouvement pour se réabonner à la presse papier. Même le minidisc, vite oublié après le succès des lecteurs MP3, semble renaître de ses cendres.

    -- Permalien

    #numérique #liberté

  • Une #bulle d’#intelligence_artificielle et de #stupidité naturelle
    (pour archivage, publié en 2024)

    La technologie derrière #ChatGPT, #Dall-E et autres n’est pas révolutionnaire, elle est spectaculaire. C’est très différent. Et, comme souvent, le spectaculaire attire une attention démesurée du grand public par rapport aux capacités réelles de la technologie. C’est ce qu’on appelle «  une bulle  ».

    Et une bulle, ça finit toujours par imploser.

    Mais en vrai, c’est quoi l’intelligence artificielle  ?

    Rappelons qu’un logiciel est un ensemble d’instructions données à un ordinateur par un programmeur pour donner un résultat (un «  output  ») basé sur des paramètres modifiables («  l’input  »). Un programme «  classique  » est donc un programme qui donnera toujours un résultat prévisible. Je vous expliquais d’ailleurs cela en détail dans un article précédent.

    L’histoire d’un bit (https://ploum.net/lhistoire-dun-bit/index.html)

    Ce que nous appelons «  intelligence artificielle  » est un ensemble de techniques, parfois très diverses, pour qu’un logiciel puisse être «  entrainé  ». Au lieu de définir exactement comment va fonctionner le logiciel, on va lui fournir des «  données d’apprentissage  » pour qu’il en tire une forme de moyenne statistique. Exemple  : lui montrer des photos de terroristes et des photos de gens innocents pour, ensuite, tenter de voir s’il détecte des terroristes inconnus parmi une foule sur laquelle on n’a aucune information.

    Mais qui est responsable si le programme développé de cette manière désigne un innocent comme terroriste et entraine son élimination par un drone  ? Le programmeur qui a développé l’algorithme  ? Il n’avait pas conscience du cadre d’utilisation, il a juste fait un logiciel pour différencier deux types de personnes sur base de photos. Celui qui a sélectionné les données et qui a «  oublié  » d’inclure des barbus parmi les innocents  ? Celui qui, à la base de tout ça, a imaginé qu’un terroriste était reconnaissable à son visage  ?

    La fameuse intelligence artificielle, ce n’est que ça  : des algorithmes statistiques sont très utiles dans certains cas très spécifiques à condition d’être très surveillés. Mais qui diluent toute responsabilité en cas d’erreur.

    Un algo de type ChatGPT ne fait pas autre chose  : pour simplifier à outrance, il prend à chaque fois le texte de la conversation et tente de prédire quel mot a la plus grande probabilité de suivre. Il prend littéralement tous les mots de son dictionnaire, les rajoute à la fin de la phrase et évalue un score pour le texte résultant basé sur la moyenne statistique calculée durant son apprentissage.

    Si je lui demande  :

    Ploum : Quelle est la couleur d’un schtroumpf  ?

    Il va voir que, dans toutes ses données d’apprentissage, la suite de mot «  Quelle est la couleur de X  ? La couleur de X est  » est plus probable que « Quelle est la couleur de X  ? Banane volante à pistons  ». Du coup, il répond  :

    IA : La couleur de…

    Ben oui, parce que ça fonctionne aussi pour la couleur d’un marsupilami ou de n’importe quoi d’autre. C’est une des raisons qui fait que ChatGPT ne vous répond pas platement «  bleu  » comme n’importe quel humain le fait. Parce que dans ses données d’apprentissage apparait régulièrement qu’une réponse commence souvent en reformulant sa question.

    IA : La couleur d’un schtroumpf est…

    Cette reformulation reprend des parties de la phrase. Ce n’est pas du tout évident, mais cela donne l’impression que ChatGPT comprend ce qu’il dit. C’est faux. C’est simplement le plus probable parmi les milliards de possibilités de la langue française (ou de la langue schtroumpf).

    IA : La couleur d’un schtroumpf est bleue

    Parce que, dans tous les textes du corpus où apparait le mot «  schtroumpf  », c’est le mot «  bleu  » qui revient le plus souvent et qui est souvent associé avec le mot «  couleur  ».

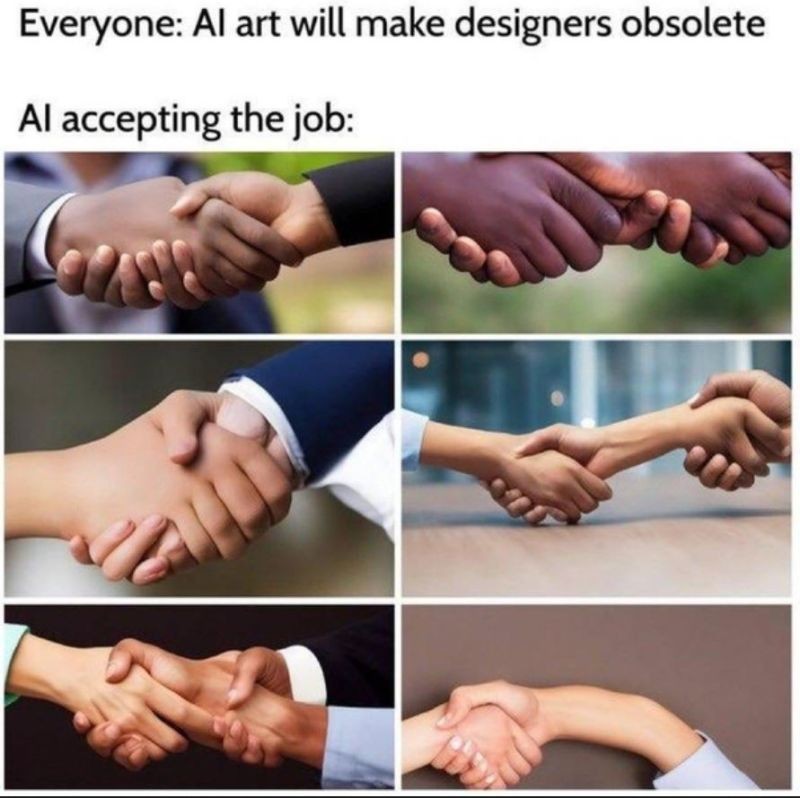
    Évidemment, ce qui est le plus probable n’est pas toujours ce qui a le plus de sens. Les personnages générés par Dall-E ont, par exemple, souvent bien plus de doigts que nécessaire. Pour une raison toute simple  : sur une image, la probabilité est très grande que ce qui est à côté d’un doigt soit un autre doigt. En fait, si vous me montriez une partie de photo représentant un doigt en me demandant de parier sur ce qu’il y a juste à côté, j’aurais tout intérêt à répondre  : «  un autre doigt  !  ». Ce n’est pas une hallucination, c’est un résultat entièrement logique, statistique  !

    Des résultats techniques spectaculaires…

    Nonobstant ce que nous appelons des «  hallucinations  » (un mot choisi à dessein pour anthropomorphiser et rendre encore plus attirantes et mystiques les IA), les résultats sont très impressionnants, spectaculaires, imprévus. C’est un véritable show qui nous est offert dont les hallucinations font intégralement partie.

    À la base de tous les ChatGPT et consorts, on trouve une nouvelle méthode de programmation appelée «  Transformers  » (oui, comme les robots de mon enfance) inventée par 8 types chez Google (qui sont, depuis, tous partis pour fonder leur startup AI sauf un qui a fondé une startup blockchain).

    > [1706.03762] Attention Is All You Need (https://arxiv.org/abs/1706.03762)

    Le papier décrivant la méthode est devenu un «  landmark paper  ». Pour les spécialistes, il est bouleversant, car il introduit de nouvelles techniques, de nouvelles perspectives. Mais, pour le grand public, il n’est finalement qu’une énième optimisation (impressionnante, je le répète) de méthodes de machine learning qui existent et s’améliorent depuis 40 ans. La grosse révolution, outre une amélioration significative des performances générales, c’est d’avoir permis une mise en parallèle des calculs. Du coup, plutôt que de devoir sans cesse optimiser des algorithmes ou créer des superordinateurs, on peut se contenter de mettre beaucoup d’ordinateurs en parallèle. Beaucoup comme dans «  beaucoup beaucoup beaucoup  ». Et donc multiplier les performances des algorithmes existants. Ce qui est très cool mais, selon ma définition, pas vraiment «  révolutionnaire  ».

    > 8 Google Employees Invented Modern AI. Here’s the Inside Story (https://www.wired.com/story/eight-google-employees-invented-modern-ai-transformers-paper), visited on Mon Apr 1 20:51:01 2024

    Ces améliorations de performances ont permis d’entrainer les algorithmes sur des quantités astronomiques de données. De l’ordre de «  tout ce qui nous tombe sous la main  ». Et de créer des produits attractifs pour le grand public (ChatGPT, Dall-E, …) alors qu’à la base, l’algorithme visait surtout à automatiser les traductions.
    Un enthousiasme naïf qui l’est encore plus  !

    Si ces nouvelles techniques sont spectaculaires, la vitesse avec laquelle les investisseurs et les entreprises se sont engouffrées dans le buzz l’est encore plus. Comme le dit très bien Cory Doctorow, de nombreuses boites AI se sont créées avec des technologies incapables de remplacer un travailleur humain, mais avec une équipe marketing capable de convaincre votre patron que c’est bien le cas.

    Et chaque patron découvrant ChatGPT se sent soudain dans l’urgence d’investir dans l’AI, de peur que le concurrent le fasse avant lui. C’est parfois très con un CEO. Surtout quand ça a peur de rater le coche.

    Petit aparté  : si vous apprenez l’existence d’une technologie à travers la presse généraliste, c’est trop tard. C’est que vous êtes le dernier couillon à en ignorer l’existence. Et c’est vous qui allez constituer la dernière couche de la pyramide de ponzi qu’est la bulle spéculative sur ce sujet. Bref, vous êtes le pigeon. Face à un enthousiasme exubérant dans un domaine qui n’est pas le vôtre et sur lequel vous arrivez sur le tard, il n’y a qu’une chose à faire  : rien. Attendre que tout se tasse et tirer les leçons des échecs ou réussites des uns ou des autres.

    Se jeter dans la bulle AI, c’est un peu comme aller voir Titanic en pariant qu’il ne va pas couler à la fin. D’ailleurs, ils sont déjà en train de se casser la gueule : les fournisseurs d’AI ont dépensé 50 milliards de dollars pour des pelles, pardon des puces Nvidia et ont fait… trois milliards de chiffre d’affaires. L’action Nvidia, elle, a vu sa valeur multipliée par 9 en 15 mois. Comme dit le proverbe «  Pour s’enrichir durant une ruée vers l’or, vendez des pelles  !  »

    Tous les CEO qui ont investi dans l’AI commencent à se rendre compte que c’est, en fait, très compliqué ce machin, qu’il y a peu de résultats, qu’on ne peut pas faire confiance dans ces résultats et qu’ils ne dorment plus la nuit par peur que des données privées soient exposées par les AI ou qu’ils soient attaqués pour non-respect du copyright.

    > When Will the GenAI Bubble Burst ? (https://garymarcus.substack.com/p/when-will-the-genai-bubble-burst)

    D’ailleurs, je vous alertais déjà l’année passée sur la problématique d’utiliser des datas privées pour entrainer une IA et sur le fait que, à un moment ou un autre, un petit malin arriverait à les faire ressortir. Ou, du moins, à faire croire qu’il les a ressorties, même si ce sont des hallucinations.

    > Modern AI and the end of privacy (https://ploum.net/2023-02-15-ai-and-privacy.html)

    La fin du film est encore plus prévisible qu’un Marvel du mois d’août  : les boites IA commencent à couler.

    > Stability AI reportedly ran out of cash to pay its AWS bills • The Register (https://sebsauvage.net/links/?Vwkq4g)

    La décadence et la chute

    La technologie a beau être géniale, elle nécessite énormément d’électricité et coute un pognon de dingue. Et puis il faut l’entrainer sur le plus de données possible. C’est-à-dire sur tout ce qui a jamais été posté sur Internet auquel on a accès. Sauf que, ben… ce n’est pas suffisant. Surtout que les gens ne postent plus sur Internet, mais sur des plateformes privées avec lesquelles il faut signer des contrats pour avoir accès aux données.

    > Feeding the Machine (gemini ://rawtext.club/~winter/gemlog/2024/4-02.gmi)

    Pour résumer, on assiste, comme d’habitude, à une belle bulle, une parfaite ruée vers l’or. Avec des vendeurs de pelles (Nvidia) et des vendeurs de mines (Reddit, Facebook et tous ceux qui ont les données). Les mineurs vont, pour la plupart, faire faillite. Toute bulle finit par imploser. La seule question est de savoir si ce que la bulle laissera comme débris sera utile (comme l’ont été les infrastructures réseau financées pendant la bulle du web en 2000) ou s’il ne restera que ruines et destruction (comme la bulle des subprimes en 2008).

    Ces dernières sont les pires bulles  : elles détruisent activement une infrastructure existante. Exactement ce que la bulle AI est en train de faire avec le web en le merdifiant au-delà de tout espoir de sauver quoi que ce soit. Et en pourrissant toutes les données avec lesquelles s’entraineront les prochaines générations AI.

    La bulle actuelle est peut-être en train d’utiliser la connaissance accumulée pendant des décennies pour la diluer irrémédiablement dans sa propre merde, détruisant, en quelques mois, le travail de milliers de chercheurs pour les décennies à venir. Car, dans dix ans, comment pourra-t-on créer des jeux de données importants dont on soit sûrs qu’ils ne contiennent pas de données générées par d’autres algorithmes  ?

    > Drowning in AI Generated Garbage  : the silent war we are fighting (https://ploum.net/2022-12-05-drowning-in-ai-generated-garbage.html)

    Finalement, l’AI ne fait que répéter, en vitesse accélérée, ce que le consuméro-capitalisme inspiré d’Ayn Rand applique à toute la planète depuis Thatcher et Reagan  : promettre un futur incroyable en détruisant le présent pour en revendre les décombres dix fois le prix, ne léguant finalement que des cadavres, des ruines fumantes, des déserts de déchets et un air irrespirable.

    Je me pose cette simple question  : et maintenant  ?

    On a ChatGPT, on a Dall-E. On ne peut pas leur donner plus de données d’apprentissage. On ne peut pas leur donner plus d’électricité ni plus d’ordinateurs. Les augmentations de performance purement algorithmique sont incroyablement rares, difficiles et imprévisibles. Du coup, on fait quoi avec nos bots de discussion qui spamment tous le web  ? On rend les codeurs plus rapides avec Github Copilot  ? Super, on va pondre encore plus de code que personne ne comprend, dont personne n’a la responsabilité. Mais pourquoi  ?

    > Keynote Touraine Tech 2023  : Pourquoi  ? (https://ploum.net/2023-03-30-tnt23-pourquoi.html)

    Beaucoup pensent que ChatGPT est l’aube d’une révolution, d’un nouveau paradigme. Je pense, au contraire, qu’il représente la fin, l’aboutissement technologique à la fois des techniques algorithmiques, mais également de la parallélisation et de la mise en réseau globale des connaissances humaines.

    Nous avons trop souvent tendance à confondre l’aube avec le crépuscule.

    https://ploum.net/2024-04-04-la-bulle-ai.html
    #IA #AI
    #à_lire

  • Pas de médaille pour les résistants
    https://ploum.net/2025-08-26-medailles-et-resistance.html

    Si vous voulez changer le monde, il faut entrer en résistance. Il faut accepter d’agir et de se taire. Il faut accepter de perdre du confort, des opportunités, des relations. Et il ne faut espérer aucune récompense, aucune reconnaissance.

    Un espionnage pire que tout ce que vous imaginez

    Prenez notre dépendance envers quelques monopoles technologiques. Je pense qu’on ne se rend pas compte de l’espionnage permanent que nous imposent les smartphones. Et que ces données ne sont pas simplement stockées «  chez Google  ».

    Tim Sh a décidé d’investiguer. Il a ajouté un simple jeu gratuit sur un iPhone vierge dont tous les services de localisation étaient désactivés. Cela semble raisonnable, non  ?

    (...)

  • L’histoire du logiciel  : entre collaboration et confiscation des libertés
    https://ploum.net/lhistoire-du-logiciel-entre-collaboration-et-confiscation-des-libertes

    Le concept même de logiciel n’est pas évident. Comme le rappelait Marion Créhange, la première titulaire d’un doctorat en informatique en France, la manière d’influencer le comportement des premiers ordinateurs était de changer le branchement des câbles. Un programme était littéralement un plan de câblage qui nécessitait de s’arracher les mains sur des fils.

    Petit à petit, les premiers informaticiens ont amélioré la technologie. Ils ont créé des ordinateurs « programmables » qui pouvaient être modifiés si on leur fournissait des programmes au format binaire, généralement des trous sur des cartes en carton qui étaient insérées dans un ordre précis. Il fallait bien évidemment comprendre exactement comment fonctionnait le processeur pour programmer la machine.

  • De l’utilisation des smartphones et des tablettes chez les adolescents par Ploum - Lionel Dricot.
    https://ploum.net/2025-04-10-smartphone_ado.html

    Les pédiatres et les psychiatres recommandent de ne pas avoir une utilisation régulière du smartphone avant 15 ou 16 ans, le système nerveux et visuel étant encore trop sensible avant cela. Si une limite d’âge n’est pas réaliste pour tout le monde, il semble important de retarder au maximum l’utilisation quotidienne et régulière du smartphone. Lorsque votre enfant devient autonome, privilégiez un «  dumbphone  », un simple téléphone lui permettant de vous appeler et de vous envoyer des SMS. Votre enfant arguera, bien entendu, qu’il est le seul de sa bande à ne pas avoir de smartphone. Nous avons tous été adolescents et utilisé cet argument pour nous habiller avec le dernier jeans à la mode.

    -- (...)

    #éducation #écran #parentalité

  • L’Apple Vision Pro est une vision d’hommes - Numerama
    https://www.numerama.com/tech/1625948-lapple-vision-pro-est-une-vision-dhommes.html

    Il n’empêche que j’ai du mal à imaginer qu’une femme puisse se balader le visage couvert par un Vision Pro, pour rire ou pour de vrai. Et si cela obstruait suffisamment ma vue pour me mettre en danger ? Et si cela attirait trop l’attention sur moi ? On a déjà assez d’emmerdes en marchant simplement dehors, sans appareil à 3500 dollars sur le nez. Et à l’inverse, je me sentirais tout de suite mal à l’aise si je croisais un homme portant un casque capable de me filmer (comme je me méfie déjà de ceux qui ont leur portable à la main dans le métro ou dans la rue).

    • Pourquoi sommes-nous tellement accros à #Google_Maps et #Waze  ?

      S’il y’a bien un logiciel propriétaire difficile à lâcher, c’est Google Maps. Ou Waze, qui appartient également à Google. Pourquoi est-ce si compliqué de produire un logiciel de navigation libre  ? Ayant passé quelques années dans cette industrie, je vais vous expliquer les différents composants d’un logiciel de navigation.

      Les briques de base d’un logiciel de navigation sont la position, les données, le mapmatching, le routing, la recherche et les données temps réel. Pour chaque composant, je propose une explication et une analyse des solutions libres.
      La position

      Le premier composant est un système de positionnement qui va fournir une coordonnée géographique avec, parfois, un degré de précision. Une longitude et une latitude, tout simplement.

      Il existe plusieurs manières d’estimer une position. Le plus connu est le GPS qui capte des ondes émises par les satellites du même nom. Contrairement à une idée tenace, votre téléphone n’émet rien lorsqu’il utilise le GPS, il se contente d’écouter les signaux GPS tout comme une radio FM écoute les ondes déjà présentes. Votre téléphone n’a de toute façon pas la puissance d’émettre jusqu’à un satellite. Les satellites GPS sont, au plus près, à 20.000 km de vous. Vous croyez que votre téléphone puisse envoyer un signal à 20.000 km  ?

      Pour simplifier à outrance, le principe d’un satellite GPS est d’émettre en permanence un signal avec l’heure qu’il est à son bord. Votre téléphone, en captant ce signal, compare cette heure avec sa propre horloge interne. Le décalage entre les deux permet de mesurer la distance entre le téléphone et le satellite, sachant que l’onde se déplace à la vitesse de la lumière, une onde radio n’étant que de la lumière dans un spectre invisible à l’œil humain. En refaisant cette opération pour trois satellites dont la position est connue, le téléphone peut, par triangulation, connaître sa position exacte.

      Fait intéressant : ce calcul n’est possible qu’en connaissant la position des satellites GPS. Ces positions étant changeantes et difficilement prévisibles à long terme, elles sont envoyées par les satellites eux-mêmes, en plus de l’heure. On parle des «  éphémérides  ». Cependant, attendre l’envoi des éphémérides complètes peut prendre plusieurs minutes, le signal GPS ne pouvant envoyer que très peu de données.

      C’est la raison pour laquelle un GPS éteint depuis longtemps mettra un long moment avant d’afficher sa position. Un GPS éteint depuis quelques heures seulement pourra réutiliser les éphémérides précédentes. Et pour votre smartphone, c’est encore plus facile  : il profite de sa connexion 4G ou Wifi pour télécharger les éphémérides sur Internet et vous offrir un positionnement (un «  fix  ») quasi instantané.

      Le système GPS appartient à l’armée américaine. Le concurrent russe s’appelle GLONASS et la version civile européenne Galileo. La plupart des appareils récents supportent les trois réseaux, mais ce n’est pas universel.

      Même sans satellite, votre smartphone vous positionnera assez facilement en utilisant les bornes wifi et les appareils Bluetooth à proximité. De quelle manière  ? C’est très simple  : les appareils Google et Apple envoient, en permanence, à leur propriétaires respectifs (les deux entreprises susnommées) votre position GPS ainsi que la liste des wifi, appareils Bluetooth et NFC dans le voisinage. Le simple fait d’avoir cet engin nous transforme un espion au service de ces entreprises. En fait, de nombreux engins espionnent en permanence notre position pour revendre ces données.

      Exemple d’un moniteur de batterie de voiture Bluetooth qui collecte les données de position à l’insu de son propriétaire.

      Si on coupe le GPS d’un appareil Android Google, celui-ci se contentera d’envoyer une requête à Google sous la forme  : «  Dis, je ne connais pas ma position, mais je capte le wifi grandmaman64 et superpotes89 ainsi qu’une télé Samsung compatible Bluetooth, t’aurais pas une idée d’où je suis  ?  ». Réponse  : «  Ben justement, j’ai trois utilisateurs qui sont passés hier près de ces wifis et de cette télé, ils étaient dans la rue Machinchose. Donc tu es probablement dans la rue Machinchose.  » Apple fait exactement pareil.

      Quelle que soit la solution utilisée, GPS ou autre, la position d’un smartphone est fournie par le système d’exploitation et ne pose donc aucun problème au développeur d’application. C’est complètement transparent, mais l’obtention d’une position sera parfois légèrement plus longue sans les services Google ou Apple propriétaires décrits ci-dessus.
      Les datas (données cartographiques)

      Ce n’est pas tout d’avoir une position, encore faut-il savoir à quoi elle correspond. C’est le rôle des données cartographiques, souvent appelées "data" dans l’industrie.

      Obtenir des données cartographiques est un boulot inimaginable qui, historiquement, impliquait de faire rouler des voitures sur toutes les routes d’un pays, croisant les données avec la cartographie officielle puis mêlant cela aux données satellites. Dans les années 2000, deux fournisseurs se partageaient un duopole (Navteq, acquis par Nokia en 2007 et TeleAtlas, acquis par Tomtom en 2008). Google Maps utilisait d’ailleurs souvent des données issues de ces fournisseurs (ainsi que tous les GPS de l’époque). Dans certaines régions, le logo Navteq était même visible sur la cartographie Google Maps. Mais plutôt que de payer une fortune à ces entreprises, Google a décidé de lancer sa propre base de données, envoyant ses propres voitures sur les routes (et profitant de l’occasion pour lancer Google Street View).

      La toute grande difficulté des data, c’est qu’elles changent tout le temps. Les sentiers et les chemins se modifient. Des routes sont ouvertes. D’autres, fermées. Des constructions se font, des quartiers entiers apparaissent alors qu’une voie se retrouve à sens unique. Parcourir la campagne à vélo m’a appris que chaque jour peut être complètement différent. Des itinéraires deviennent soudainement impraticables pour cause de ronces, de fortes pluies ou de chutes d’arbres. D’autres apparaissent comme par magie. C’est un peu moins rapide pour les automobilistes, mais tentez de traverser l’Europe avec une carte d’une dizaine d’années et vous comprendrez votre douleur.

      En parallèle de ces fournisseurs commerciaux est apparu le projet OpenStreetMap que personne ne voulait prendre au sérieux dans l’industrie. On m’a plusieurs fois ri au nez lorsque j’ai suggéré que cette solution était l’avenir. Tout comme Universalis ne prenait pas Wikipédia au sérieux.

      Le résultat, nous le connaissons : OpenStreetMap est aujourd’hui la meilleure base de données cartographiques pour la plupart des cas d’usage courant. À tel point que les géants comme Waze n’hésitent pas à les repomper illégalement. Sebsauvage signale le cas d’un contributeur OSM qui a sciemment inventé un parc de toutes pièces. Ce parc s’est retrouvé sur Waze…

      Mais les applications utilisant OpenStreetMap doivent faire face à un gros défi  : soit demander à l’utilisateur de charger les cartes à l’avance et de les mettre à jour régulièrement, soit de les télécharger au fur et à mesure, ce qui rend l’utilisation peut pratique (comment calculer un itinéraire ou trouver une adresse dans une zone dont on n’a pas la carte  ?). Le projet OpenStreetMaps est en effet financé essentiellement par les dons et ne peut offrir une infrastructure de serveurs répondant immédiatement à chaque requête, chose que Google peut confortablement se permettre.
      Le mapmatching

      Une fois qu’on a la carte et la position, il suffit d’afficher la position sur la carte, non  ? Et bien ce n’est pas aussi simple. Tout d’abord parce que la planète est loin de correspondre à une surface plane. Il faut donc considérer la courbure de la terre et le relief. Mais, surtout, le GPS tout comme les données cartographiques peuvent avoir plusieurs mètres d’imprécision.

      Le mapmatching consiste à tenter de faire coïncider les deux informations : si un GPS se déplace à 120km/h sur une ligne parallèle située à quelques mètres de l’autoroute, il est probablement sur l’autoroute  ! Il faut donc corriger la position en fonction des données.

      En ville, des hauts bâtiments peuvent parfois refléter le signal GPS et donc allonger le temps de parcours de celui-ci. Le téléphone croira alors être plus loin du satellite que ce n’est réellement le cas. Dans ce genre de situation, le mapmatching vous mettra dans une rue parallèle. Cela vous est peut-être déjà arrivé et c’est assez perturbant.

      Une autre application du mapmatching, c’est de tenter de prédire la position future, par exemple dans un tunnel. La position GPS, de par son fonctionnement, introduit en effet une latence de quelques secondes. Dans une longue ligne droite, ce n’est pas dramatique. Mais quand il s’agit de savoir à quel embranchement d’un rond-point tourner, chaque seconde est importante.

      Le logiciel peut alors tenter de prédire, en fonction de votre vitesse, votre position réelle. Parfois, ça foire. Comme lorsqu’il vous dit que vous avez déjà dépassé l’embranchement que vous devez prendre alors que ce n’est pas le cas. Ou qu’il vous dit de tourner dans trente mètres alors que vous êtes déjà passé.
      La recherche

      On a la position sur la carte qui est, le plus souvent, notre point de départ. Il manque un truc important : le point d’arrivée. Et pour trouver le point d’arrivée, il faut que l’utilisateur l’indique.

      Les recherches géographiques sont très compliquées, car la manière dont nous écrivons les adresses n’a pas beaucoup de sens : on donne le nom de la rue avant de donner la ville avant de donner le pays  ! Dans les voitures, la solution a été de forcer les utilisateurs à entrer leurs adresses à l’envers : pays, ville, rue, numéro. C’est plus logique, mais nous sommes tellement habitués à l’inverse que c’est contre-intuitif.

      Le problème de la recherche dans une base de données est un problème très complexe. Avec les applications OpenStreetMap, la base de données est sur votre téléphone et votre recherche est calculée par le minuscule processeur de ce dernier.

      Ici, Google possède un avantage concurrentiel incommensurable. Ce n’est pas votre téléphone qui fait la recherche, mais bien les gigantesques serveurs de Google. Tapez "rue Machinchose" et la requête est immédiatement envoyée à Google (qui en profite pour prendre note dans un coin, histoire de pouvoir utiliser ces informations pour mieux vous cibler avec des publicités). Les ordinateurs de Google étant tellement rapide, ils peuvent même tenter d’être intelligent : il y’a 12 rue Machinchose dans tout le pays, mais une MachinChause, avec une orthographe différente, dans un rayon de 10km, on va donc lui proposer celle-là. Surtout que, tient, nous avons en mémoire qu’il s’est rendu 7 fois dans cette rue au cours des trois dernières années, même sans utiliser le GPS.

      Force est de constater que les applications libres qui font la recherche sur votre téléphone ne peuvent rivaliser en termes de rapidité et d’aisance. Pour les utiliser, il faut s’adapter, accepter de refaire la recherche avec des orthographes différentes et d’attendre les résultats.
      Le routing

      On a le départ, on a l’arrivée. Maintenant il s’agit de calculer la route, une opération appelée «  routing  ». Pour faire du routing, chaque tronçon de route va se voir attribuer différentes valeurs  : longueur, temps estimé pour le parcourir, mais aussi potentiellement le prix (routes payantes), la beauté (si on veut proposer un trajet plus agréable), le type de revêtement, etc.

      L’algorithme de routing va donc aligner tous les tronçons de route entre le départ et l’arrivée, traçant des centaines ou des milliers d’itinéraires possibles, calculant pour chaque itinéraire la valeur totale en additionnant les valeurs de chaque tronçon.

      Il va ensuite sélectionner l’itinéraire avec la meilleure valeur totale. Si on veut le plus rapide, c’est le temps total estimé le plus court. Si on veut la distance, c’est la distance la plus courte, etc.

      À mon époque, l’algorithme utilisé était le plus souvent de type «  Bidirectionnal weighted A-star  ». Cela signifie qu’on commence à la fois du départ et de l’arrivée, en explorant jusqu’au moment où les chemins se rencontrent et en abandonnant les chemins qui sont déjà de toute façon disqualifiés, car un plus court existe (oui, on peut aller de Bruxelles à Paris en passant par Amsterdam, mais ce n’est pas le plus efficace).

      Une fois encore, le problème est particulièrement complexe et votre téléphone va prendre un temps énorme à calculer l’itinéraire. Alors que les serveurs de Google vont le faire pour vous. Google Maps ne fait donc aucun calcul sur votre téléphone  : l’application se contente de demander aux serveurs Google de les faire à votre place. Ceux-ci centralisent les milliers d’itinéraires demandés par les utilisateurs et les réutilisent parfois sans tout recalculer. Quand on est un monopole, il n’y a pas de petits profits.
      Les données temps réels

      Mais si on veut le trajet le plus rapide en voiture, une évidence saute aux yeux : il faut éviter les embouteillages. Et les données concernant les embouteillages sont très difficiles à obtenir en temps réel.

      Sauf si vous êtes un monopole qui se permet d’espionner une immense majorité de la population en temps réel. Il vous suffit alors, pour chaque tronçon de route, de prendre la vitesse moyenne des téléphones qui sont actuellement sur ce tronçon.

      L’artiste Simon Weckert avait d’ailleurs illustré ce principe en promenant 99 smartphones connectés sur Google maps dans un chariot. Le résultat  ? Une rue déserte est devenue un embouteillage sur Google Maps.

      Là, force est de constater qu’il est difficile, voire impossible, de fournir ces données sans espionner massivement toute la population. À ce petit jeu, les alternatives libres ne pourront donc jamais égaler un monopole de surveillance comme celui de Google.

      Mais tout n’est pas noir, car, contrairement à ce qu’on pourrait croire, les infos trafic ne nous permettent pas d’aller plus vite. Elles donnent une illusion d’optimalité qui empire le trafic sur les itinéraires alternatifs et, au final, le temps perdu reste identique. Le seul avantage est que la prévision du temps de trajet est grandement améliorée.

      Ce résultat résulte de ce que j’appelle le paradoxe de l’embouteillage. C’est un fait bien connu des scientifiques et ignoré à dessein des politiciens que le trafic automobile est contre-intuitif. Au plus la route est large et permet à de nombreux véhicules de passer, au plus les embouteillages seront importants et la circulation chaotique. Si votre politicien propose de rajouter une bande sur le périphérique pour fluidifier la circulation, changez de politicien  !

      L’explication de ce phénomène tient au fait que lorsqu’il y’a un embouteillage sur le périphérique, ce n’est pas le périphérique qui bouche. C’est qu’il y’a plus de voitures qui rentrent sur le périphérique que de voitures qui en sortent. Or, les sorties restent et resteront toujours limitées par la taille des rues dans les villes.

      En bref, un embouteillage est causé par le goulot d’étranglement, les parties les plus étroites qui sont, le plus souvent, les rues et ruelles des différentes destinations finales. Élargir le périphérique revient à élargir le large bout d’un entonnoir en espérant qu’il se vide plus vite. Et, de fait, cela rend les choses encore pires, car cela augmente le volume total de l’entonnoir, ce qui fait qu’il contient plus d’eau et mettra donc plus longtemps à se vider.
      99 smartphones dans un bac à roulette : c’est tout ce que nous sommes pour Google

      Les infotrafics et les itinéraires alternatifs proposés par Google Maps ne font pas autre chose que de rajouter une bande de trafic virtuelle (sous forme d’un itinéraire alternatif) et donc élargissent le haut de l’entonnoir. Les infos trafic restent utiles dans les cas particuliers où votre destination est complètement différente du reste de la circulation. Où si la congestion apparait brusquement, comme un accident : dans ce cas, vous pourriez avoir le bénéfice rare, mais enviable d’emprunter l’itinéraire de secours juste avant sa congestion.

      La plupart du temps, les infotrafics sont globalement contre-productifs par le simple fait que tout le monde les utilise. Elles seraient parfaites si vous étiez la seule personne à en bénéficier. Mais comme tout le monde les utilise, vous êtes également obligé de les utiliser. Tout le monde y perd.

      Leur impact premier est surtout psychologique : en jouant avec les itinéraires alternatifs, vous pouvez vous convaincre que vous n’avez pas d’autre choix que prendre votre mal en patience. Alors que, sans eux, vous serez persuadés qu’il y’a forcément une autre solution.
      Les logiciels

      Alors, se passer de Google Maps ? Comme nous l’avons vu, ce n’est pas évident. Le service Google Maps/Waze se base sur l’espionnage permanent et instantané de milliards d’utilisateurs, offrant une précision et une rapidité insurpassable. Quand on y pense, le coût de ce confort est particulièrement élevé. Et pourtant, Google Maps n’est pas la panacée.

      J’ai personnellement un faible pour Organic Maps, que je trouve bien meilleur que Google Maps pour tout à l’exception du trafic routier : les itinéraires à pieds, en vélo et même en voiture hors des grands axes sont bien plus intéressants. Certes, il nécessite de télécharger les cartes. Inconvénient, selon moi, mineur, car permettant une utilisation même sans connexion. La recherche est, par contre, souvent frustrante et lente.

      Mais le mieux est peut-être d’explorer les alternatives libres à Google Maps dans cet excellent article de Louis Derrac.

      Et puis, pourquoi ne pas lutter contre la privatisation du bien commun qu’est la cartographie en apprenant à contribuer à OpenStreetMap  ?

      https://ploum.net/2023-11-03-logiciels-de-navigation.html

  • « Faire quelque chose, le partager », sans visée commerciale : le combat du logiciel libre n’est pas mort - Basta !
    https://basta.media/faire-quelque-chose-le-partager-sans-visee-commerciale-le-combat-du-logicie

    Souvent bénévoles, les développeuses et développeurs de #logiciels_libres contribuent largement au monde numérique actuel. Deux libristes trentenaires témoignent d’un secteur en recomposition, sous pression des géants du numériques.

    • Aujourd’hui, s’opposer aux divisions que le capitalisme a créées sur la base de la race, du genre, de l’âge, réunir ce qu’il a séparé dans nos vies et reconstituer un intérêt collectif doivent donc être des priorités politiques pour les féministes et les autres mouvements en faveur de la justice sociale. C’est bien, en dernière analyse, l’enjeu de la politique des communs, qui, sous son expression la plus intéressante, présuppose un partage des richesses, la prise de décision collective et une révolution dans notre rapport à nous-mêmes et aux autres. Car la coopération sociale et la création de savoir que Marx attribuait au travail industriel ne peuvent se construire que par des activités auto-organisées qui « font du commun » ( commoning activities ) – jardinage urbain, banques de temps, code source ouvert ( open sourcing ) –, qui supposent, en même temps qu’elles produisent, de la communauté. En ce sens, dans la mesure où elle vise à reproduire nos vies sous des formes qui renforcent la solidarité et pose des limites à l’accumulation du capital69, la politique des communs traduit pour partie l’idée marxienne du communisme comme abolition de l’état actuel. On pourrait aussi soutenir qu’avec le développement des communs numériques – l’essor des mouvements pour le logiciel libre et la culture libre – nous sommes en train de nous rapprocher de cette universalisation des facultés humaines que Marx avait prévue comme une conséquence du développement des forces productives . Mais la politique des communs est un tournant radical par rapport à ce que le communisme a signifié dans la tradition marxiste et dans une bonne partie de l’œuvre de Marx, à commencer par le Manifeste du Parti communiste. Il y a un certain nombre de différences cruciales entre la politique des communs et le communisme qui ressortent, notamment quand on les considère d’un point de vue féministe et écologiste.

      Sylvia Federici, Le capitalisme patriarcal, Ed. La Fabrique, janvier 2019.

  • De la merdification des choses
    https://ploum.net/2023-06-15-merdification.html

    Le principe de la merdification est simple  : maintenant que les utilisateurs sont captifs, que les concurrents ont quasiment disparu, que les business indépendants ont été acculés à la faillite ou rachetés, on peut exploiter l’utilisateur jusqu’au trognon.

    Certains groupes d’investisseurs se sont spécialisés dans ces techniques. Cory Doctorow les regroupe sous le terme «  Private Equity  » (PE). Leur job  ? À partir d’un business existant, extraire un maximum d’argent en un minimum de temps, disons entre deux et cinq ans.
    Comment  ?

    Premièrement, en augmentant les tarifs et en supprimant les programmes gratuits. Les utilisateurs sont habitués, migrer vers un autre service est difficile, la plupart vont payer. Surtout si cette hausse est progressive. L’objectif n’est pas d’avoir de nouveaux utilisateurs, mais bien de faire cracher ceux qui sont déjà là. On va donc leur pourrir la vie au maximum : tarifs volontairement complexes et changeant, rebranding absurdes pour justifier de nouveaux tarifs, blocage de certaines fonctionnalités, problèmes techniques empêchant la migration vers un autre service, etc.

    En second lieu, on va bien entendu stopper tout investissement dans l’infrastructure ou le produit. Un maximum d’employés vont être licenciés pour ne garder que l’équipage minimal, si possible sous-payé. Le support devient injoignable ou complètement incompétent, la qualité du produit se dégrade tout à fait.

    Bref, c’est la merdification.

  • L’histoire du #logiciel  : entre collaboration et confiscation des libertés

    Le concept même de logiciel n’est pas évident. Comme le rappelait #Marion_Créhange, la première titulaire d’un doctorat en #informatique en France, la manière d’influencer le comportement des premiers ordinateurs était de changer le branchement des câbles. Un programme était littéralement un plan de câblage qui nécessitait de s’arracher les mains sur des fils.

    Petit à petit, les premiers informaticiens ont amélioré la #technologie. Ils ont créé des #ordinateurs « programmables » qui pouvaient être modifiés si on leur fournissait des programmes au format binaire, généralement des trous sur des cartes en carton qui étaient insérées dans un ordre précis. Il fallait bien évidemment comprendre exactement comment fonctionnait le processeur pour programmer la machine.

    https://ploum.net/lhistoire-du-logiciel-entre-collaboration-et-confiscation-des-libertes

    #unix #linux #logiciel_libre

  • Chapitre 8  : l’artiste déconnecté | ploum.net
    https://ploum.net/chapitre-8-lartiste-deconnecte

    Reposons la question autrement : pourquoi les artistes ont-ils l’impression que les réseaux sociaux sont essentiels à leur carrière ? Parce qu’ils ont des retours : des commentaires, des likes, des partages. Des statistiques détaillées sur « l’engagement de leur communauté  ». Qui leur fournit ces retours ? Les réseaux sociaux eux-mêmes !

    Qui sont les artistes qui ont le plus de followers sur les réseaux sociaux ? Les artistes qui ont du succès… en dehors des réseaux sociaux !

    Les réseaux sociaux nous font confondre la cause et l’effet. En soi, ils ne sont la cause d’aucun succès, ils ne font que souligner les succès existants. Ils ne font que récompenser l’utilisation de leur plateforme par une monnaie de singe qu’ils contrôlent. Le « Like ».

    ...

    ""Poster du contenu sur les réseaux sociaux pour obtenir des likes est une quête chimérique. L’artiste travaille littéralement au profit du réseau social pour l’alimenter, pour donner une raison aux utilisateurs de venir le consulter. En échange, il peut avoir la chance de recevoir une impression virtuelle de succès.""

    #EMI #Réseauxsociaux #Art #Addiction #SNT #NSI

    • on a un peu l’impression d’un truc écrit ya 15 ans… depuis ya quand même des centaines d’artistes, en tout cas en musique, et souvent en rap, qui ont percé sans jamais être passés en radio, médias, etc, et qui donc ne faisaient pas encore de concerts non plus, juste parce que leurs clips ou même juste freestyles se propagent sur les réseaux, à commencer par youtube puisque la musique (populaire) sans clip ça n’existe presque plus (ça vaut aussi pour les chaines d’humour, vulgarisation, etc)

    • C’est certain que de nombreux artistes ont réussi à se faire connaître via les réseaux mais ils sont d’une certaine manière contraints par ces réseaux et se retrouvent à devoir les alimenter au détriment peut-être de leur œuvre.
      La logique des réseaux entretient une forme de consommation artistique qui peut éventuellement parasiter un processus de création.

    • C’est certain que de nombreux artistes ont réussi à se faire connaître via les réseaux mais ils sont d’une certaine manière contraints par ces réseaux et se retrouvent à devoir les alimenter au détriment peut-être de leur œuvre.
      La logique des réseaux entretient une forme de consommation artistique qui peut éventuellement parasiter un processus de création.

      Non. C’est pas une question de réseaux sociaux. C’est une question de marchandisation des œuvres. Réseaux ou pas, des artistes seront tenté·es de répondre à la demande en faisant ce qu’on attend d’elleux. Ou simplement pouvoir vivre de leur travail. Les autres continuent leur chemin quelque soit la façon dont leurs œuvres sont reçues par le public, les réseaux, les éditeurs... Je vis de travaux de commande en carto et graphisme et je poursuis en parallèle un travail de carto artistique et d’autres œuvres dont je ne tire que très peu de revenus (je suis plasticienne).

    • l’artiste connecté avec son public, en live y’a rien de mieux. Un.e artiste avec un profil sur Instagram pour moi c’est non grata.
      Prenez La Fraction qui vient de sortir un nouvel album De l’autre côté c’est la scène qui les a fait connaître, leur site n’est plus à jour depuis 2016.
      https://lafraction.bandcamp.com/album/de-lautre-c-t

      Disque réalisé par Fraction Productions, Stonehenge Rds, Gestalt, Maloka, Mass Productions, Tranzophobia, Crash Disques, Twisted Chords, Trujaca Fala, Konstroy, Mescufurus (+ General Strike CD)

      SHOWS 2022
      Les 30 ans de Chéribibi reportés à octobre. Dimanche 22 MAI : soutien Jargon Libre au CICP - Paris 11e.
      Samedi 4 JUIN : festival Maloka - Dijon.
      Samedi 25 JUIN : au Cheval déchaîné, Vierves (Belgique).
      Samedi 9 JUILLET : festival Punk Illegal (Alvesta/Suède)

  • « Demain j’arrête ! » : de nombreux utilisateurs veulent quitter Twitter, mais hésitent
    https://www.sudouest.fr/sciences-et-technologie/demain-j-arrete-de-nombreux-utilisateurs-veulent-quitter-twitter-mais-hesit

    Migrer, vers où ?

    De fait, aucune plateforme ne peut aujourd’hui rivaliser avec celle à l’oiseau bleu. « Ce qui fait Twitter, c’est la communauté, ce sont ses 436 millions d’utilisateurs », assure Leïla Mörch, coordinatrice du projet de recherche Content Policy and Society Lab à l’université américaine de Stanford. En termes de popularité, c’est l’application de discussion Discord (300 millions de comptes) qui s’approche le plus de Twitter. Elle rassemble des communautés en ligne mais, contrairement à Twitter, n’est pas une plateforme ouverte : chaque espace nécessite une invitation.

    Lancé en 2016, Mastodon est un clone de Twitter, sans publicité et dont le code est ouvert, mais son serveur principal est beaucoup plus petit puisqu’il compte seulement 670 000 inscrits. D’autres plateformes comme Gettr, Parler ou The Truth Social ont aussi copié l’original. Problème, étant fondées par des proches de l’ancien président des États-Unis Donald Trump, banni de Twitter en janvier 2021, ces alternatives sont considérées comme les « Twitter de droite ».
    Un espace majeur d’influence

    « Twitter attire le monde médiatique, un ensemble de journalistes et de people, le monde des décideurs politiques et économiques », ainsi qu’une « couche d’influenceurs », explique Dominique Boullier, professeur des universités en sociologie à Sciences Po Paris. Ces « relais d’opinion » ne représentent qu’une minorité des utilisateurs, selon le spécialiste, mais ce sont eux qui « génèrent de la viralité ».

    L’objectif de Musk, poursuit Dominique Boullier, est de faire de Twitter « un média de masse » en récupérant « un public friand de news choquantes, contradictoires et alternatives » moins présent depuis le bannissement de Donald Trump.

    #Twitter #Elon_Musk #Influence #Dominique_Boullier

  • Amateurs du slow Web, de la sobriété numérique, des sites d’information avec du texte et pas d’images, partisans de la vie privée, contrariants opposés au Web obèse d’aujourd’hui, voici une solution et elle fait le buzz en ce moment : #Gemini.

    Gemini est un système de publication de textes qui s’appuie sur un protocole à lui, délibérement non extensible, pour rendre plus difficile d’y ajouter des trucs comme les cookies. Il a aussi un format à lui, délibérement limité pour permettre l’écriture de clients Gemini simples.

    Je mets ici un lien vers le site de référence :

    https://gemini.circumlunar.space

    C’est un lien Web mais je mets aussi le lien Gemini (vous n’avez probablement pas un client Gemini sous la main en ce moment) :

    gemini ://gemini.circumlunar.space/

    Avant de commenter, je recommande très fortement de lire la FAQ, qui répond sans doute à votre commentaire :

    https://gemini.circumlunar.space/docs/faq.html

  • La #politique du doigt mouillé | ploum.net
    https://ploum.net/la-politique-du-doigt-mouille

    (...) La crise du coronavirus nous démontre à quel point nos politiciens sont, par construction de notre système, ineptes. Les réseaux sociaux les trompent en leur faisant croire qu’ils sont en contact avec la population, qu’ils comprennent les gens, qu’ils sont populaires. Ce mensonge n’est qu’un artefact technologique qui, sous prétexte d’optimiser les revenus publicitaires de quelques entreprises, enferme une minorité dans une bulle de résonnance hyperaddictive, mais décorrélée de la réalité. Les scientifiques ne sont évidemment pas en reste. La recherche s’est transformée en une course à la publication. Les résultats incertains sont immédiatement transformés en titres sensationnalistes. Les codes sources sont très rarement partagés, la reproductibilité est nulle. Quand, tout simplement, (...)

    #covid19 #science

  • Le mensonge des réseaux sociaux | ploum.net
    https://ploum.net/le-mensonge-des-reseaux-sociaux

    Tentant de prévenir à tout prix ma « communauté » que je publiais un roman, que c’était important pour moi et que c’était le moment de me soutenir pour ceux qui en avaient l’envie et les moyens, je me suis retrouvé à spammer sans relâche les réseaux sociaux. Certains, à raison, se sont sentis harcelés. D’autres, qui me suivent sans lire chacun de mes billets de blog, m’ont demandé de quoi je parlais. Ils n’avaient vu aucun des précédents messages, ils ne savaient pas ce qu’était ce « Printeurs » qui apparaissait pour la première fois dans leur flux. Certains ne sont toujours pas au courant aujourd’hui ! (alors que les préventes s’achèvent ce mercredi !)

    Pour toucher ma « communauté », les réseaux sociaux font pire que mal. Ils me font croire qu’il y’a une communication là où elle se réduit à quelques interactions entre les mêmes personnes.

  • Le revenu garanti revient.

    Rien ne sera jamais plus comme avant… | ploum.net
    https://ploum.net/rien-ne-sera-jamais-plus-comme-avant

    Nous commencerons à réfléchir sérieusement à l’idée de payer les gens un revenu de base pour rester à la maison, nous rendant compte que cela ne va pas détruire le monde, mais au contraire le sauver.

    Coronavirus : le revenu universel, c’est maintenant !
    https://www.courrierinternational.com/article/vu-dallemagne-coronavirus-le-revenu-universel-cest-maintenant

    “Les indépendants, les travailleurs free-lance, les créatifs, les artistes ont aussi besoin d’un soutien financier de l‘État.” Et ce, non sous forme de crédit, “mais sous la forme d‘un revenu de base mensuel […] à hauteur de 1 000 euros sur une période de six mois”, suggère le quotidien de Francfort.

  • Troisième mise en demeure pour l’association LinuxFr
    https://linuxfr.org/news/troisieme-mise-en-demeure-pour-l-association-linuxfr

    LinuxFr.org est au fil du temps devenu un site web francophone de référence sur le monde du libre et au-delà, qui traite en particulier de l’actualité du Logiciel Libre, en mode contributif, géré par une équipe bénévole, par et pour des libristes enthousiastes, et sans pub. Après plus de 21 ans d’existence, LinuxFr.org comporte plus de 100 000 contenus (dépêches, journaux, etc.) et environ 1,8 million de commentaires.

    Le site dispose notamment d’une équipe de modération intervenant a priori (dépêches, sondages) ou a posteriori (journaux, forums, wiki, tags, commentaires). L’équipe suit des règles de modération, que nous ne manquons pas de rappeler régulièrement lorsque des commentaires ou contenus problématiques le nécessitent ou qu’une édition/suppression est faite. En tant que « service de communication (...)