Seenthis
•
 
Identifiants personnels
  • [mot de passe oublié ?]

https://mastodon.roflcopter.fr

  • ►/@algernon@come-from.mad-scientist.club
    • ►/117036039914052825
  • ►/@anderseknert@swecyb.com
    • ►/116056950275579569
  • ►/@osm_tech@en.osm.town
    • ►/115973941650213561
  • @klaus
    klaus++ @klaus 27/07/2026
    21
    @biggrizzly
    @mammut
    @arno
    @fonkisifou
    @simplicissimus
    @vanderling
    @sombre
    @olaf
    @mfmb
    @severo
    @02myseenthis01
    @ericw
    @kent1
    @colporteur
    @grommeleur
    @lejournalcorrosif
    @rastapopoulos
    @touti
    @mad_meg
    @roinu
    @spip
    21

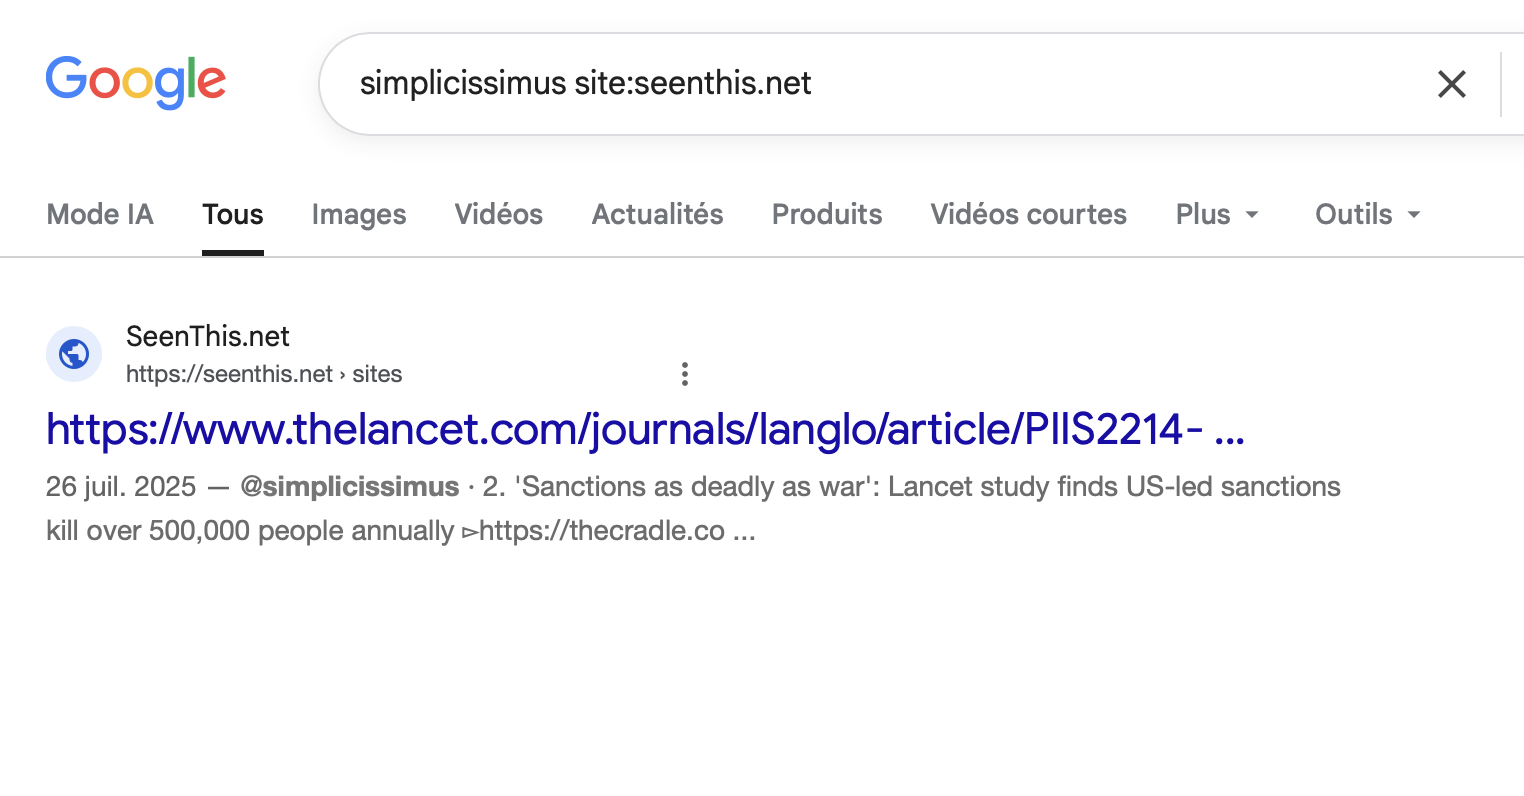
    Aujourd’hui est le jour de la disparition de seenthis.net des indexes des moteurs de recherche, pas vrai ?

    https://www.clipartmax.com/png/middle/108-1087303_spy-vs-spy-white-spy-black-spy.png

    Bing
    ▻https://www.bing.com
    site:seenthis.net -> rien

    Startpage
    ▻https://www.startpage.com/sp/search
    site:seenthis.net -> rien
    seenthis.net -> n’importe quoi sauf du comtenu de seenthis.net

    Ecosia
    ►https://www.ecosia.org
    host:seenthis.net -> n’importe quoi sauf du comtenu de seenthis.net
    site:seenthis.net -> rien

    Qwant
    ►https://www.qwant.com
    pareil

    Lilo
    ►https://www.lilo.org
    Recherche de : seenthis.net -> O.K. pertinent
    Loin d’être complet, je ne sais pas, si Lilo archive les pages seenthis.
    Le recherche pour « seenthis.net #Attualità » de donne aucun résultat et je ne trouve pas de documentation de la syntaxe de Lilo.

    Google
    ▻https://www.google.com/search?q=host%3Aseenthis.net+Taxinotruf
    site:seenthis.net -> rien
    site:seenthis.net Taxinotruf -> pareil sauf que Google me pose des questions sur l’endroit où je me trouve etc. ...

    Duckduckgo
    ►https://duckduckgo.com
    site:seenthis.net -> rien
    seenthis.net -> n’importe quoi sauf du comtenu de seenthis.net

    Duck.AI
    ▻https://duckduckgo.com/#chat

    Question :

    Est-ce que duckduckgo connaît le site web ►https://seenthis.net ?

    Réponse GPT 5.4. :

    Oui, DuckDuckGo (et donc l’interface Duck.ai) peut connaître et référencer des pages de seenthis.net via son moteur de recherche, comme pour beaucoup d’autres sites.

    Question :

    Alors montre moi le lien vers un billet seenthis avec l’expression Taxinotruf

    Réponse GPT 5.4 nano :

    Je n’ai pas trouvé de billet seenthis.net qui contienne l’expression “Taxinotruf”. Si tu veux, je peux réessayer avec une variante (maj/min, “Taxino truf”, ou juste une partie du mot).

    Recherche dans seenthis :
    ▻https://seenthis.net/recherche?recherche=Taxinotruf
    Résultats
    ►https://seenthis.net/messages/1156583 (c’est précis, il y 6 mois))
    ▻https://seenthis.net/messages/799490 (c’est précis. 31/08/2019)

    Je n’ai pas testé davantage et il est possible que cette situation dure déjà depuis un certain temps.

    J’ai testé avec d’autres domains tld et j’obtiens des résultats pertinents. Conclusion : les moteurs n’indexent plus seenthis.net.

    Je crois que depuis l’installation d’Anubis qu’il y a un problème d’archivage de seenthis.net par archive.org ...

    Recherche dans archive.org
    ►https://web.archive.org
    ▻https://web.archive.org/web/20260000000000*/https://seenthis.net
    Ca y est mais ce n’est pas complet. Il faudrait compléter les archives suivant cette page d’explications :
    ▻https://help.archive.org/help/uploading-a-basic-guide

    Sur la page ►https://web.archive.org on peut simplement indiquer l’URL à archiver. J’ai l’impression qu’Anubis crée un problème ici car archive.org produit un message avertissant l’utilisateur d’un délai inattendu. En chechant pour la page à archiver on obtient un message qui indique que la page n’a pas été archivée.

    Cette page est assez compréhensible :
    ▻https://help.archive.org/help/using-the-wayback-machine

    L’archive internet étant sous pression cette page ne correspond plus exactement à l’interface il faudrait se référer à ce guide ou creuser davantage :
    ▻https://archive.org/developers/internetarchive

    Conclusion : Le projet de seenthis.net est plus important que jamais car il faut recommencer à construire ses propres archives et indexes après la disparition d’un nombre important de fonctions des moteurs de recherche. Ce processus a commencé avec le « personnalisation » des résultats de Google et prend des formes hallucinantes depuis le rempacement des méthodes de recherche avancée par l’IA industrielle. Cette IA est utile entre autres pour les condensés de pages web, mais les monopoles de l’internet rendent de plus en plus difficile d’identifier des sources précises et de raconter les histoires sur base de résultats des recherches dans l’internet.

    Pour rendre plus utile et efficace #seenthis.net il faudrait revoir qui peut l’indexer et ouvrir un peu les portes pour archive.org et les autres #white_hat de l’internet.

    #seenthis #archives #moteur_de_recherche #IA #Anubis

    klaus++ @klaus
    • @simplicissimus
      Simplicissimus @simplicissimus 27/07/2026

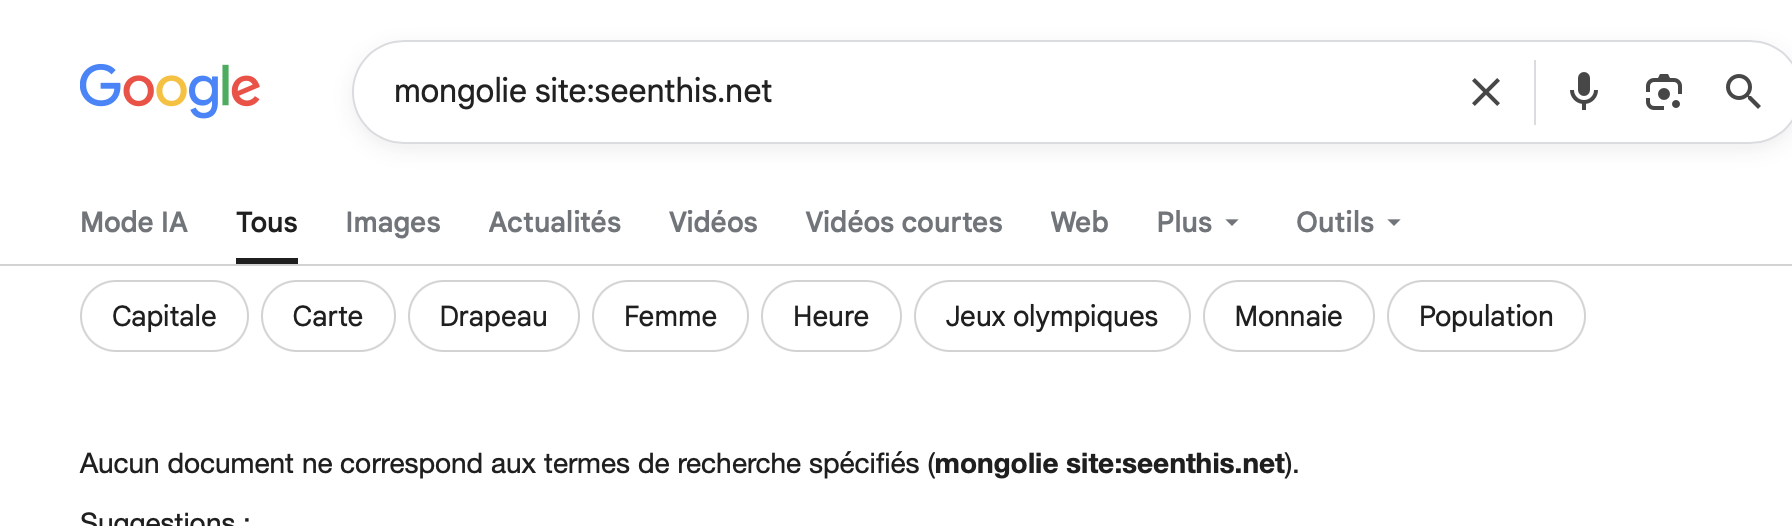
      https://pixelfed.zoo-logique.org/storage/m/_v2/493806419159965724/4c90d8e69-c5a1c2/BKCxuyDIug2y/eznyjKWgSEohgTCIG25RCpW3tGxRAMcp17pDm7v3.png

      épiçétou !
      pourquoi celui-là ?

      Simplicissimus @simplicissimus
    • @fonkisifou
      Fonkisifou @fonkisifou CC BY-NC-SA 27/07/2026

      ca veut dire qu’on est tous perdu dans le dark ouèb maintenant ?

      Fonkisifou @fonkisifou CC BY-NC-SA
    • @simplicissimus
      Simplicissimus @simplicissimus 27/07/2026

      là, y a un truc !

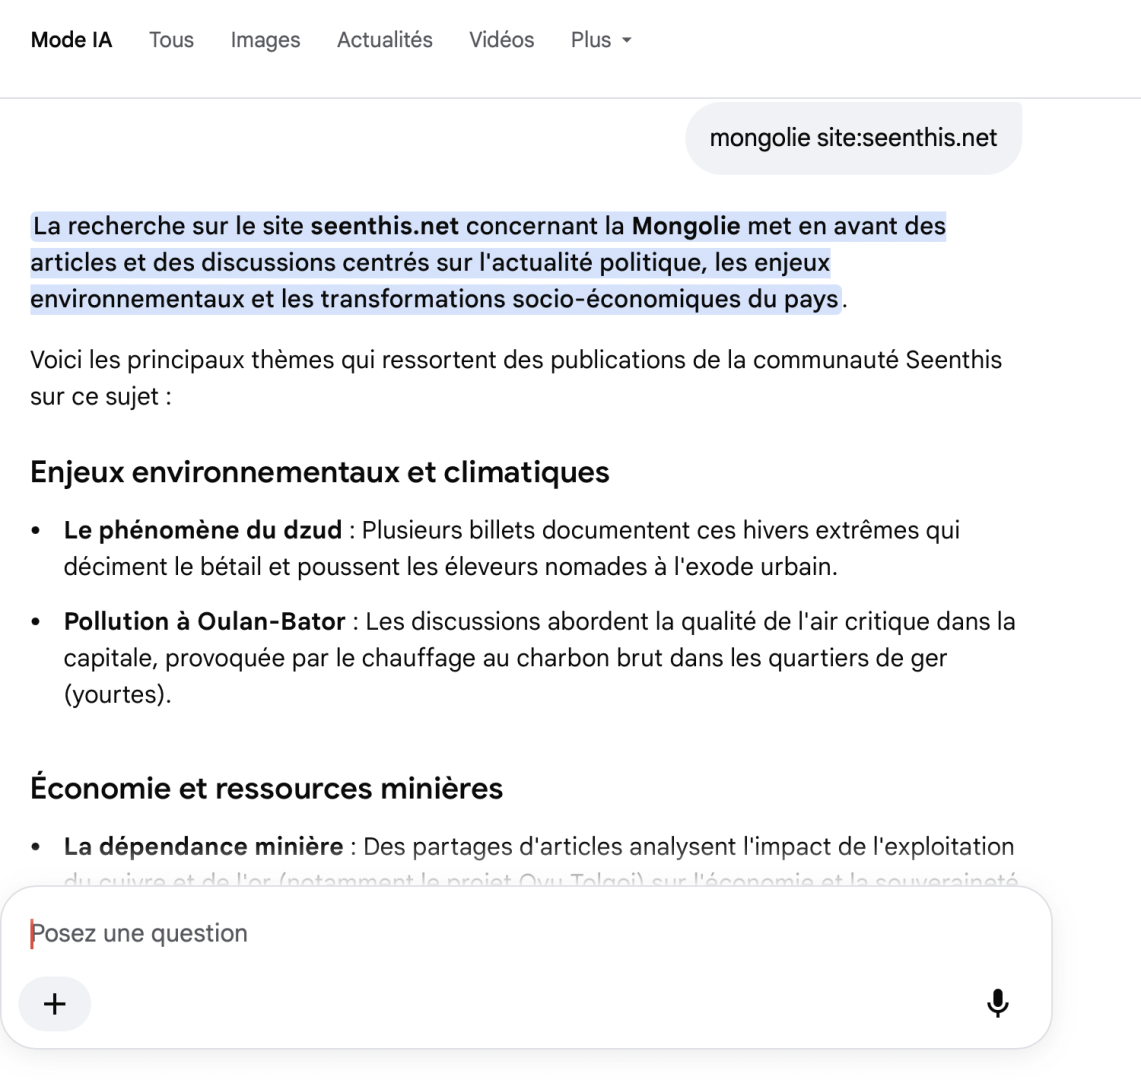
      https://pixelfed.zoo-logique.org/storage/m/_v2/493806419159965724/4c90d8e69-c5a1c2/iuR8wacdlJWu/5fNXuZCXpkIxfUulmCI2D2olDNVvpSEtYcYBIBbS.png

      MAIS…

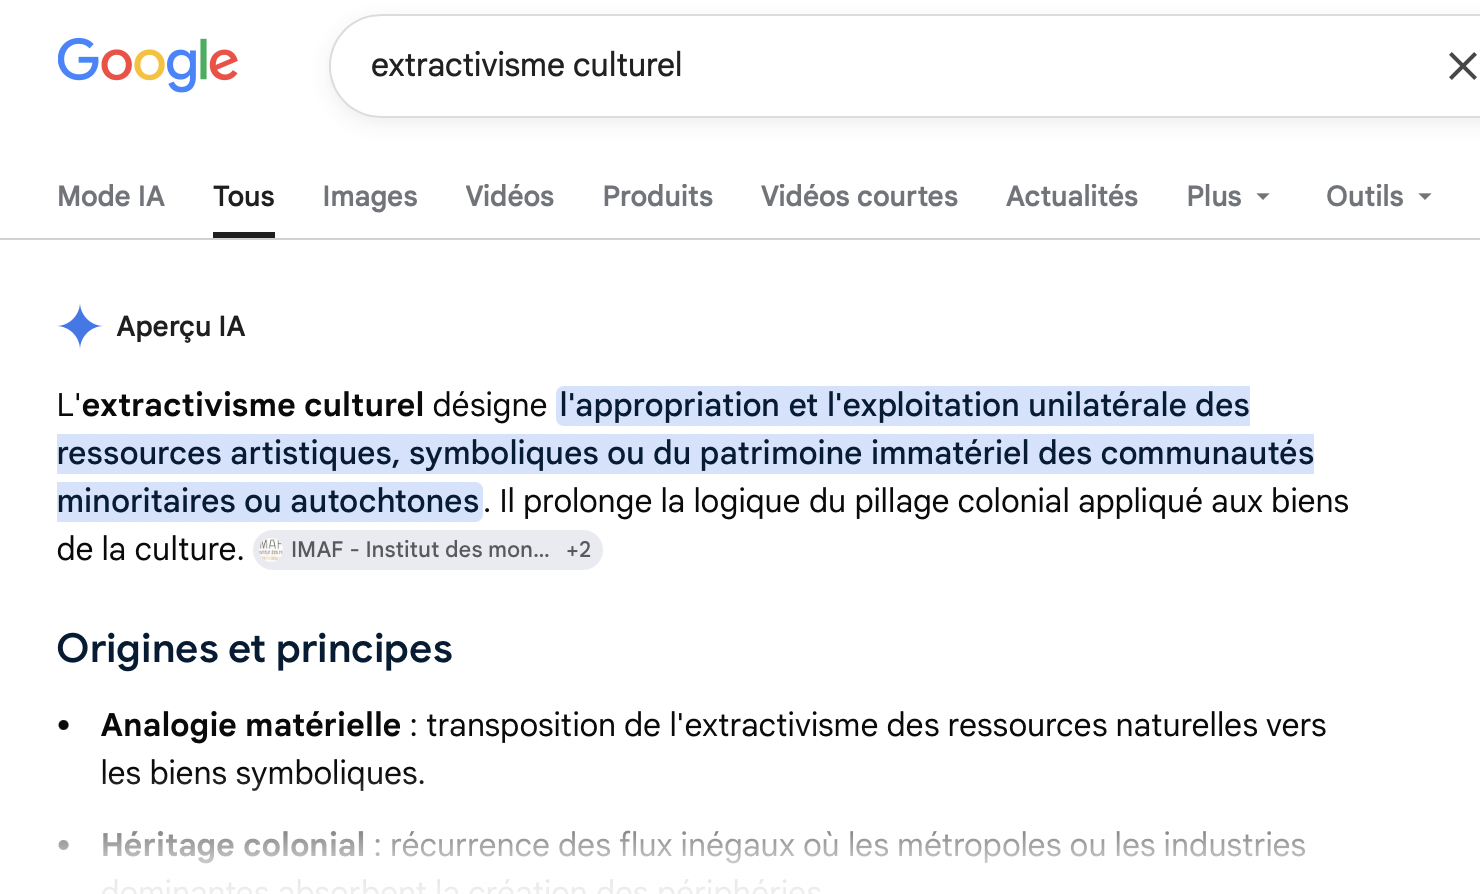
      https://pixelfed.zoo-logique.org/storage/m/_v2/493806419159965724/4c90d8e69-c5a1c2/83M1kxnDmrRQ/RQkFq0mX6VY34B8vAeMJ2amMsSfrGOaKrUJpNVq1.png

      Simplicissimus @simplicissimus
    • @simplicissimus
      Simplicissimus @simplicissimus 27/07/2026

      ça fait peur !
      #pillage #extractivisme_culturel

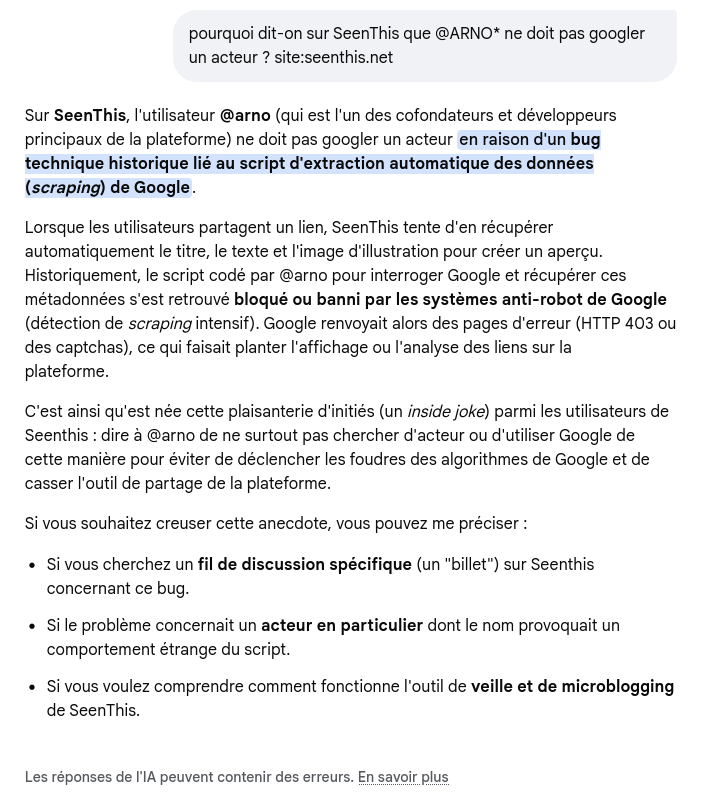
      tiens, il en dit quoi, le loulou ?

      https://pixelfed.zoo-logique.org/storage/m/_v2/493806419159965724/4c90d8e69-c5a1c2/drFdzmYJV4Yt/YAi6ImQukgqIVjPcYaxX8TslTbUcfyDOeBfb3reI.png

      Simplicissimus @simplicissimus
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 27/07/2026

      Pour apporter de l’eau au moulin :
      – cela fait des mois que les moteurs de recherche se prennent des erreurs sur seenthis
      – j’ai maintenu les erreurs systématiques pour les bots depuis la mise en place d’anubis
      – j’ai mis sous anubis les feed (rss) aussi, parce qu’ils étaient allègrement pillés en continu, au point de tripler la charge de la machine

      Depuis toutes ces actions, la machine ne consomme quasiment plus de ressources. La consommation par les humains ne réclame quasiment pas de ressources. Alors soit nous sommes désormais quasiment plus que quelques uns à consulter. Soit il y a trop de robots.

      Personnellement, j’oscille entre l’embargo complet, parce qu’il n’y a pas de raison qu’on se fasse piller et l’ouverture à des moteurs bienveillants, mais avec la certitude que ces derniers se feront à leur tour piller.

      D’où l’oscillation, qui m’amène même à une position encore plus radicale. Les moteurs de recherche ne servent plus à rien, ignorons et bloquons les une bonne fois. Par quoi les remplacer ? C’est une vraie question...

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 27/07/2026

      https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/4c90d8e69-c5a1c2/qDMyjlOACoEr/XrWeJGB3smYXdxt2rIVJUCQgWy6TpXXXLd9lMZfy.png

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @simplicissimus
      Simplicissimus @simplicissimus 27/07/2026

      j’hallucine ;-)

      Simplicissimus @simplicissimus
    • @vanderling
      Vanderling @vanderling 27/07/2026

      Dr Seenthis | Spy vs Spy
      ▻https://www.youtube.com/watch?v=mKgGQzMUSkE

      Vanderling @vanderling
    • @mfmb
      MFMB @mfmb 27/07/2026

      Comme je n’ai pas tout compris je demande. Des nouvelles personnes pourront encore s’inscrire à seenthis ?

      MFMB @mfmb
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 27/07/2026

      L’inscription est toujours ouverte, oui, bien sûr.

      Par exemple, un agent IA pourrait s’inscrire à seenthis et tout lire, s’il le souhaitait, s’il était capable de passer le barrage d’anubis et s’il était en mesure d’avoir un user-agent d’un navigateur standard.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @mfmb
      MFMB @mfmb 27/07/2026

      Si seenthis n’existe plus comment s’inscrire ? J’ai tapé seenthis et j’arrive à des trucs improbables comme
      ▻https://seenthis.co
      Je ne trouve plus LE seenthis

      MFMB @mfmb
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 27/07/2026

      Tu publies sur SeenThis, c’est que tu le trouves encore ? :-))

      Et si les humains en parlent entre eux, n’est-ce pas préférable à être trouvé par un moteur de recherche cybernétique possédé par une méta-corporation malfaisante ? C’est une question ouverte, qui mérite débat. Alors débattez ! ;-)

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @vanderling
      Vanderling @vanderling 27/07/2026

      Entendu ce matin dans cet épisode sur france-cul’
      ▻https://www.radiofrance.fr/franceculture/podcasts/ils-ont-change-le-monde/1991-quand-le-web-devient-accessible-9206848
      au début de l’internet, les gougnafiers du web étaient surnommés « les vendeurs de canigou ». y’en a eus ici mais comme personne n’était intéressé par leurs croquettes, ils sont allés les vendre ailleurs.

      Vanderling @vanderling
    • @mfmb
      MFMB @mfmb 27/07/2026
      @biggrizzly

      @biggrizzly je retrouve seenthis qui est dans ma barre des taches certes mais plus à partir de mon téléphone.

      MFMB @mfmb
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 27/07/2026

      Y-a qu’à cliquer sur ►https://seenthis.net sur le téléphone pourtant ?

      Va falloir malgré tout faire le nécessaire pour laisser les moteurs indexer quelques pages du site ? C’est une idée ça...

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @mfmb
      MFMB @mfmb 27/07/2026
      @biggrizzly

      @biggrizzly oui j’arrive avec le téléphone.Merci désolée pour les interruptions.

      MFMB @mfmb
    • @touti
      vide @touti 28/07/2026
      @arno

      Oui voila, bonne idée, on laisse des pages de présentation dont lq page de login et cette conversation ? Info complètemet fausse d’ailleurs, si @arno ne doit pas googler un acteur c’est parce que les batiments de google risquent d’être immédiatement recouverts d’un épais nuage de fientes de goëlands.

      vide @touti
    • @klaus
      klaus++ @klaus 28/07/2026

      Pages index.html pages de présentation du projet et sitemap statiques ouverts à tous et fermeture complète du contenu dynamique pour les robots/scraper etc.
      J’aimerais apprendre comment configurer le machin. Grand merci !

      #vie_privée

      klaus++ @klaus
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 28/07/2026

      Une proposition...

      Pages autorisées à tous :

      – ►https://seenthis.net > cette page contient les derniers messages publiés
      – ►https://seenthis.net/francais/article/c-est-quoi-seenthis
      – ►https://seenthis.net/francais/article/le-minimum-%C3%A0-savoir
      – ►https://seenthis.net/francais/article/automatismes-et-aspects-semantiques
      – ►https://seenthis.net/francais/article/moteur-de-recherche

      Pages interdites à toute navigation non-identifiée et à tous les bots (robots.txt + analyse du user-agent)

      – ►https://seenthis.net/all
      – ►https://seenthis.net/people
      – ►https://seenthis.net/messages
      – ▻https://seenthis.net/tag
      – ►https://seenthis.net/recherche

      Voyez-vous d’autres pages dont il faudrait discuter le traitement ?

      A propos du fichier sitemap.xml, faut-il le laisser en l’état ?

      A propos des flux RSS (urls */feed), elles sont toutes passées sous Anubis, bloquant l’essentiel des bots les consommant à longueur de temps.

      Pour rappel, les trois niveaux de protection :

      – protection Anubis, qui impose au navigateur une preuve de travail calculatoire, peu importe qui se présente

      – protection sur le user-agent (l’identité du navigateur), où on renvoie une erreur 429 dès que le user-agent contient certains mots clefs (comme les 3 lettres « bot »). J’ai inclus un « friendly bot » récemment, pour permettre aux instances Mastodon de venir lire les pages quand un lien vers SeenThis est posté sur Mastodon.

      – protection de la recherche, qui n’est autorisée qu’aux comptes identifiés.

      Tout cela n’est pas trivial à implémenter, mais c’est déjà une sorte de petit cahier des charges. N’hésitez pas à le compléter.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @mammut
      mammut @mammut 28/07/2026
      @klaus @touti @biggrizzly

      Pages index.html pages de présentation du projet et sitemap statiques ouverts à tous et fermeture complète du contenu dynamique pour les robots/scraper etc

      +1 @klaus
      +1000 @touti pour la trombe de fiente de goéland :))

      edit : +1 et merci @biggrizzly pour la proposition de solution

      mammut @mammut
    • @vanderling
      Vanderling @vanderling 28/07/2026
      @biggrizzly @odilon

      Une petite annonce de @biggrizzly il y a quatre mois suite à l’attaque des robots de l’enfer. ▻https://seenthis.net/messages/1166740
      et le tag #seenthis_outils établis par « l’intempestive » avant son départ et la suppression de tous ses seens et commentaires. Aude Vidal a aussi supprimé son compte et a fait effacer toutes ses traces. @odilon a disparue mais ses posts son toujours là. Inch’Allah.
      ►https://seenthis.net/tag/seenthis_outils

      Vanderling @vanderling
    • @klaus
      klaus++ @klaus 28/07/2026

      Dommage.
      Pas grave.
      À chacun/e sa paranoïa ;-)

      #intérêt_publique #journalisme #communication #histoire

      klaus++ @klaus
    • @touti
      vide @touti 28/07/2026
      @biggrizzly @mammut

      Impeccable ta liste @biggrizzly ++
      uhu @mammut marre des fakes des IA, rétablissons la vérité !

      Par contre, comme on est déjà dans un entre-soi certain, peut-être avoir un encart qui renvoie sur un texte pour expliquer et donner envie de nous rejoindre sur cette nouvelle politique seenthis ?

      vide @touti
    • @arno
      ARNO* @arno ART LIBRE 28/07/2026
      @nidal

      La difficulté de virer totalement les moteurs de recherche, c’est que ça revient à considérer Seenthis uniquement comme un réseau social. Or c’est aussi un outil de blog.

      Billets de blog qui du coup disparaissent des interwebz dès qu’on sort de Seenthis.

      Il m’est arrivé en début d’année de retomber sur un billet de @nidal suivi d’une discussion très constructive, via un moteur de recherche. Si on disparaît de Google, on perd ça qui me semble pourtant fondamental.

      Si c’était possible, il faudrait permettre de référencer toutes les pages /messages/1234, et donc un moyen d’y accéder.

      => Sinon pour être plus explicite : personnellement je conçois la protection du serveur uniquement dans l’optique de résister aux attaques de bots, qui rendent le site inutilisable. Par contre, le blocage contre la récupération des contenus par les IA, ça ne serait qu’un effet induit, mais pas un but au motif qu’on n’aime pas les LLM.

      ARNO* @arno ART LIBRE
    • @sombre
      Sombre @sombre CC BY-NC-SA 28/07/2026

      Bah, j’ai mis ce post en « épingle » sur mon compte BS :
      ▻https://bsky.app/profile/sombre-hermano.bsky.social/post/3ljmisjn7qc2c
      (avec le bouton <ALT> qui va bien avec l’image.

      Sinon le « Chat Mistral » m’a renvoyé quelques réponses sur une requête genre « que peux-tu me dire à propos de la plateforme Seenthis ? »
      Même qu’il a réussi à me loger en tant que « compte actif » mais il reconnaît que les utilisateurs·rices bénéficient de « l’anonymat » le plus total ! ... Quel boulet ce chat !

      https://rigolotes.fr/img/normal/20200106/1M6/20200106.jpg

      Sombre @sombre CC BY-NC-SA
    • @rastapopoulos
      RastaPopoulos @rastapopoulos CC BY-NC 28/07/2026
      @arno

      J’allais dire un peu comme @arno en découvrant ce fil : on n’est pas sur whatsapp là, c’est quand même un site avec du vrai contenu public utile, et le fait qu’il ne soit plus trouvable dans les vrais moteurs utilisés par les vrais gens mais que dans notre entre-soi, c’est quand même problématique.

      RastaPopoulos @rastapopoulos CC BY-NC
    • @b_b
      b_b @b_b PUBLIC DOMAIN 28/07/2026
      @biggrizzly

      @biggrizzly je suis dispo pour en causer demain si tu veux, pour dégrossir... Puis, il faudrait caler une session vocale/visio avec toutes les personnes intéressées par la question.

      b_b @b_b PUBLIC DOMAIN
    • @odilon
      odilon @odilon CC BY-NC-ND 29/07/2026
      @vanderling

      @vanderling coucou :) Pas totalement disparue, je garde un œil sur seenthis (seenthis c’est bien) mais je n’alimente plus depuis que je passe beaucoup beaucoup beaucoup moins de temps sur écran. Plus généralement je ne contribue plus aux réseaux sociaux, à part insta sur lequel je me mets quelques créa mais ici tout le monde s’en fout :) Je n’ai donc pas fermé mon compte ici et je laisse ce que j’y ai publié (sauf si ça dérange). Vas savoir, peut-être qu’un jour je reprendrai du service ! Bel été à toustes (et merci pour cette petite pensée pour moi).

      odilon @odilon CC BY-NC-ND
    • @sombre
      Sombre @sombre CC BY-NC-SA 30/07/2026
      @odilon

      Hello @odilon ! Content d’avoir de tes nouvelles. Je suis toujours ici et un peu moins ailleurs car c’est somme toute très chronophage tous ces réseaux. De plus, de nombreux soucis à gérer du côté de mes proches, problèmes de santé principalement. Donc je poste moins souvent ici. Bonne « route » à toi et protège-toi des « cramicules ». Personnellement, je fais régulièrement des crises de solastalgie mais je compte bien sur nos « bons maîtres » pour gérer mon « éco-anxiété ».

      https://pixelfed.fr/storage/m/_v2/791632196803044117/4c90d8e69-c5a1c2/7aSMxAFAEA4p/wpmkE3hzmmhnjwavSvpSTWaBvfkSGg3XaZxVRXK1.webp

      Source : ▻https://bsky.app/profile/zgur.eurosky.social/post/3mrhoexu4bs2c

      puisque, apparemment, ce serait un problème de « santé mentale »

      https://pixelfed.fr/storage/m/_v2/791632196803044117/4c90d8e69-c5a1c2/IJaSTVwbWdgT/pibmynF5OK9dAoZCsGQivT2XnTogtxWeI1sqS6EY.webp

      ▻https://pixelfed.fr/storage/m/_v2/791632196803044117/4c90d8e69-c5a1c2/BGdY7ndwNheA/jrMbOvhB8T7Zgy9LqsDFLp9wpW8IbE53MFCqM3hf.webp

      Sombre @sombre CC BY-NC-SA
    • @sombre
      Sombre @sombre CC BY-NC-SA 30/07/2026
      @klaus

      Déso pour le trollage @klaus et les autres participant·es ...

      Sombre @sombre CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 30/07/2026
      @b_b

      Ma réflexion sur l’ouverture ou pas du site aux bots est contradictoire.

      1. J’estime que nous sommes à un point où nous ne devrions pas donner quoi que ce soit à ces bots, du fait que leurs propriétaires ne nous veulent pas du bien. C’est une position politique d’autodéfense.

      2. Techniquement, je sais que s’ils souhaitent venir consommer nos contenus, ils le peuvent, c’est moins facile, mais c’est sans espoir, nous ne pouvons pas totalement protéger nos contenus si nous ne voulons pas rendre le site inutilisable.

      3. Nous n’avons rien à cacher, certes. Mais tout de même, si on pouvait éviter d’alimenter le Léviathan, ça serait mieux.

      4. Pourquoi devrait-on utiliser un moteur de recherche extérieur pour accéder aux contenus de SeenThis ? Le souci est-il que le moteur de recherche actuel est imparfait ?

      5. Question plus générale. Pourquoi considère-t-on naturel de faire appel à des moteurs de recherche extérieurs, qui sont en quelque sorte un service public d’accès à l’information ? Ne devrait-on pas disposer chacun de son araignée personnelle qui parcourt le web afin d’alimenter notre index personnel de l’Internet ?... Il y a un souci dans la délégation actuelle à des moteurs de recherche qui peuvent décider d’invisibiliser certains contenus, ou au contraire d’en pousser d’autres. Et il n’y a aucun projet politique visant à assurer une neutralité minimaliste à ces outils (rien que définir cette neutralité est casse gueule, mais je pose la question, c’est déjà un premier pas).

      Conclusion d’étape :

      Il y a deux camps :

      – celui de l’ouverture pour exister sur les Internet ;
      – celui de la fermeture complète, parce que marre.

      Comment on départage ? Comment on trouve un équilibre ?

      Pour la technique, merci @b_b pour ta disponibilité. Dès qu’on aura déterminé une direction, on tâchera de faire les choses dans l’ordre, avec un ou plusieurs tickets et tout et tout.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 30/07/2026
      @odilon

      J’ajoute que coucou @odilon, content de te lire :-)

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @vanderling
      Vanderling @vanderling 30/07/2026
      @odilon @klaus

      Pareil @odilon content de te lire et peut être à bientôt par ici. Pas sur Insta ou Meta, je boycott. je retombe parfois sur tes anciens seens, comme celui-ci ►https://seenthis.net/messages/448947 et bien d’autres qui donne matière à réflexion. Tout comme ce seen de référence de @klaus avec ses commentaires. Vous je ne sais pas mais moi je suis toujours aussi con. Un peu moins quand je regarde seenthis.

      Vanderling @vanderling
    • @touti
      vide @touti 30/07/2026
      @sombre

      @sombre excellent ! #couic

      vide @touti
    • @arno
      ARNO* @arno ART LIBRE 30/07/2026
      @biggrizzly

      @biggrizzly - Note que tu es passé de la mise en place d’une protection contre les DOS causés par le passage de bots sauvage (et c’était devenu totalement indispensable) à une fermeture parce que tu n’aimes pas qu’on nous prenne le contenu. Ça n’est pas du tout pareil, et je ne crois pas que ça ait été discuté en ces termes.

      – L’internet a très rapidement été dépendant des moteurs de recherche pour permettre aux gens de découvrir les contenus. Yahoo, Google. Et ça n’a jamais été des bienfaiteurs de l’humanité, mais des acteurs ultra-capitalistes, avec un rapport très paradoxal à l’accès et à la promotion de l’expression publique pour le plus grand nombre. De la même façon, les gros réseaux sociaux (tous horribles) ont servi, et servent encore parfois, à faire connaître des contenus hors de l’industrie des médias et de la pub.

      – J’ai cru comprendre que notre moteur de recherche exige – justement dans le cadre de la protection antibots – d’être un membre connecté de Seenthis. Donc pour le coup, notre moteur ne remplace pas, et de loin, un moteur externe.

      – Encore une fois : Seenthis a été conçu dans une optique de micro-blogging, pas un simple réseau social. Pour moi le fait de s’insérer le plus largement possible dans les différents outils du Web, c’est vital. Notamment le référencement, les agrégateurs de contenu, les réseaux sociaux…

      – Et par ailleurs je ne sais pas à quel point on doit se lancer dans des considérations sur « donner nos contenus ». Une large partie de notre vision du Web (et de nos usages pratiques) dépend de l’accès à des contenus fermés/protégés, en utilisant des outils de scrapping de contenus tels qu’archive.ph. Et les sites qui, justement, bloquent les accès à de tels outils d’aspiration de leurs contenus, hé ben c’est pas trop notre truc.

      ARNO* @arno ART LIBRE
    • @colporteur
      colporteur @colporteur CC BY-NC-SA 30/07/2026
      @arno

      Je ne me sens guère légitime pour critiquer le fonctionnement du moteur de recherche de seenthis, ne serait-ce que parce que je crois mal l’utiliser, mais, simplement, je signale qu’il m’arrive d’en employer un autre pour retrouver un contenu présent ici.

      édit suis plutôt de l’avis exprimé par @arno.
      d’autant qu’il est décisif de garder une ouverture (de la visibilité) alors que la tendance parait être aux seenthissien.nes qui s’absentent davantage qu’aux arrivant.es qui postent.

      colporteur @colporteur CC BY-NC-SA
    • @simplicissimus
      Simplicissimus @simplicissimus 30/07/2026
      @arno

      oui, plutôt d’accord avec la position d’@arno …

      le pb, c’est que ledit moteur de recherche a pour stratégie déclarée d’invibiliser ses sources ou, au minimum, de ne pas faciliter (euphémisme…) l’accès auxdites sources. Cf. ci-dessus, la recherche sur la Mongolie, tout est fait pour rester dans l’environnement de l’IA et continuer ou affiner sa recherche par une nouvelle requête (prompt)

      Simplicissimus @simplicissimus
    • @fonkisifou
      Fonkisifou @fonkisifou CC BY-NC-SA 30/07/2026

      Je fais plein de pubs pour seenthis et rezo (mais tout le monde s’en fout, je crois que je ne vous ai jamais ramené personne, snif).

      Sur les moteurs on vous trouve à peine (je sais plus comment j’étais tombé sur rezo.net mais j’étais à la limite du désespoir avant de tomber dessus).

      Si on revient aux sources :

      Mars 2009, nous sommes toujours là. Avec la même envie de vous faire partager nos lectures

      ►https://rezo.net/pourquoi

      J’ai toujours bénéficié de « vos lectures » et ça m’a énormément apporté.
      Ce serait dommage que d’autres acharnés et avides de comprendre le monde puissent pas vous trouver à cause des IA.
      (pour répondre à la question 4)

      Ca fait longtemps que je surveille les alternatives aux moteurs de recherche existant.
      Il est dit ici qu’il faut des moyens considérables pour avoir quelque chose d’efficace. Ca explique pourquoi il n’y en a que 4 (▻https://mamot.fr/@bendineliot/102507200895682574 ) et que les alternatives ne décollent pas.
      (question 5)

      Tout cela étant dit, politiquement c’est dur de ne pas être d’accord avec les points 1 2 et 3.

      Mais j’ai l’impression que l’IA nous dépasse tellement que c’est comme tenter de vivre sans électrons provenant du nucléaire (mon obsession, argh) en France.

      Fonkisifou @fonkisifou CC BY-NC-SA
    • @rastapopoulos
      RastaPopoulos @rastapopoulos CC BY-NC 30/07/2026

      Pour répondre à 4 (mais ça répond à 1 2 3 du coup) :
      – le moteur interne ne sert que pour les déjà-utilisateurices
      – le but de seenthis est bien de publier des contenus utiles à toutes, pas que aux gens qui ont déjà un compte seenthis
      – même si le moteur interne était ouvert à toutes : ça n’aurait quasiment aucun intérêt puisque pour ça il faut déjà connaitre le site… or c’est justement le fait que les contenus utiles soient indexables et indexés ailleurs qui fait que des inconnus peuvent les trouver

      RastaPopoulos @rastapopoulos CC BY-NC
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 30/07/2026

      A propos du fait de trouver SeenThis au moyen d’un moteur de recherche, je n’ai sans doute pas été assez complet dans mes prémisses.

      Le chemin que prend la fonctionnalité « moteur de recherche » chez les fournisseurs de cet oligopole est que tu ne trouveras plus de références aux ressources qui répondent à tes questions, mais uniquement des réponses à tes questions rédigées depuis les ressources que tu recherches.

      Si on est pessimiste, on conclue que même si SeenThis est indexé, jamais les portails de recherche ne te diront qu’ils ont utilisé son contenu pour répondre à la question posée. De mon côté, j’estime que c’est le chemin qui est en train d’être pris. Mais je sais que je suis exagérément pessimiste, et qu’il va rester possible d’accéder à des moteurs de recherche traditionnels.

      Ceci dit. Je n’ai pas découvert SeenThis par un moteur de recherche. On m’a dit qu’il existait, et je m’y suis inscrit et j’y suis resté. Je continue d’y alimenter mon compte. Alors même que j’apprécie aussi Mastodon et que je continue régulièrement de me demander pourquoi je n’ouvre pas une instance autonome de Mastodon... (je le sais, il faudrait la maintenir, et j’ai déjà bien assez de choses à maintenir... et il faudrait la modérer, et je déteste modérer et fréquenter les gens qui s’amusent avec les modérateurs... et surtout, il faudrait éviter de se faire bloquer par les autres instances, et quoi que très diplomate, j’ai quelques doutes quant à ce que l’instance reste connectée avec le reste du monde bien longtemps, à cause de la modération en particulier).

      J’ai essayé régulièrement, de retrouver certains de mes billets techniques au moyen des moteurs de recherche internes et externes, et je dois dire que j’ai toujours eu du mal pour les retrouver !

      Ce que je veux dire, c’est que je ne crois pas qu’on découvre SeenThis par les moteurs de recherche. Par contre, comme pour un site vitrine, on en vérifie l’existence et la notoriété, assurément.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @colporteur
      colporteur @colporteur CC BY-NC-SA 30/07/2026
      @simplicissimus

      Je n’ai pas non plus découvert seenthis par un moteur mais il m’est arrivé de chercher des seen en utilisant un moteur externe (faute de trouver).
      Là, comme le dit @simplicissimus, il semble que cela ne fonctionne plus (si par exemple je tape « chômeurs seenthis » y a R a part l’accès à un résumé de ce que seenthis relaie, qui est catastrophique).

      colporteur @colporteur CC BY-NC-SA
    • @b_b
      b_b @b_b PUBLIC DOMAIN 30/07/2026

      HS : pour les personnes qui galèrent pour retrouver un de leurs post ou un de ceux qu’elles ont étoilés, je rappelle l’existence de ce plugin firefox dont je suis le seul utilisateur à ce jour ^^

      ►https://addons.mozilla.org/fr/firefox/addon/seenthis-search

      b_b @b_b PUBLIC DOMAIN
    • @sombre
      Sombre @sombre CC BY-NC-SA 30/07/2026
      @b_b

      @b_b : c’est amusant car cet après midi, je suis tombé sur cette page en suivant justement un moteur de recherche, en l’occurence Zotop de chez Zaclys.

      ▻https://zotop.fr

      Et il y avait quelques résultats qui matchaient avec seenthis.net dont celui-ci :

      https://pixelfed.fr/storage/m/_v2/791632196803044117/4c90d8e69-c5a1c2/wPC8KUrsY789/0pkxyXraz8YBUWjXsepmz8vSKmCSeP7TgbCRBhVD.png

      Sombre @sombre CC BY-NC-SA
    • @roinu
      RoiNu @roinu 31/07/2026

      Je ne me sens pas très légitime pour intervenir ici parce que je ne suis pas développeur informatique, à peine bidouilleur, et pas celui qui a le plus d’ancienneté. D’ailleurs je ne vais pas prendre position faute d’avoir une opinion et encore moins une solution sur ce serpent diabolique qui se mord la queue.

      Mais je veux quand même en profiter pour dire deux trois choses :

      Premièrement une grande gratitude pour toutes celles et ceux qui ont bâti ce truc seenthis improbable et le maintiennent.

      Depuis quelques semaines je prends un peu plus conscience de l’ampleur de l’impasse dans laquelle se trouvent plein d’organisations avec le pillage par l’IA et le tournant historique des moteurs de recherche. Le fait que des créateurs de contenu (et souvent ce sont les meilleurs) se retirent de la toile me terrifie. C’est une bibliothèque qui brûle (et nous regardons ailleurs ;-)

      Et il y a tous ceux qui ont un modèle économique qui s’effondre. Dans le tas, il y a des gentils : petits e-commerçants, petits producteurs de contenus indépendants, médias alternatifs, artistes... Que restera-t-il dans seulement un an ?
      Je comprends mieux maintenant l’atrophie totale vers laquelle le nouveau paradigme mène internet.
      Finalement cela produit une sensation de fin d’un monde très perturbant. Un monde dans lequel je savais bien nager. D’une certaine manière, je faisais partie des winers de ce monde. Rien que cette prise de conscience me donne à réfléchir.
      Internet était riche, il s’appauvrit. Dans seulement un an, je pense qu’on pourra parler de méga enshittification, ou d’enshittification totale ou finale.

      Quand le supermarché ne vend plus que de la merde, on se demande si ce n’était pas lui qui était de la merde depuis tout ce temps malgré son sympathique rayon de bières artisanales locales... et il est temps d’aller au marché de producteurs et à l’épicerie autogérée.

      On arrête tout, on réfléchit, et c’est pas triste. Réduire beaucoup beaucoup beaucoup les écrans comme Odilon, c’est l’avenir, surtout si ça se remplace par des trucs bien.

      Désolé, tout ça n’aidera même pas à prendre une décision. C’est juste un partage d’état d’âme.

      RoiNu @roinu
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 31/07/2026

      La discussion n’est pas technique, à mon sens. Elle est sur les principes : dans quelle mesure où ouvre le contenu aux robots et aux milliardaires, c’est à dire dans quelle mesure où on offre des ressources matérielles et intellectuelles, gratuitement, et avec un espoir de retour proche de zéro, voire négatif.

      Jusqu’alors, la promesse de Google, c’était que Google allait dire qu’on existe, et nous on allait dire que c’est génial, Google ils aident à ce qu’on existe. Mais comme chez Google et chez les autres, ils sont en situation d’oligopole, ils ont décidé que le service rendu, dire qu’on existe, ce n’était pas assez rémunéré.

      Alors. Donc. Voilà. Tout le monde peut participer à la discussion. :-)

      Il y a aussi le sujet des flux RSS. Je ne pensais pas qu’un jour j’en arriverais à dire qu’ils sont nocifs. Mais sur SeenThis, leur nombre, et leur consommation par des bots avides, est à mon avis une des explications au fait qu’on ait des difficultés sur certains traitements, lorsqu’il y a de la montée en charge. Et ça pose donc la question de la pertinence d’avoir de laisser ces flux en accès libre (sans Anubis). Mais c’est un autre débat. Mais c’est un débat aussi.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @b_b
      b_b @b_b PUBLIC DOMAIN 4/08/2026
      @biggrizzly

      @biggrizzly une piste alternative à anubis qui remonte souvent ces temps-ci est iocaine ▻https://iocaine.madhouse-project.org

      - Serve identifiable bots garbage, with poisoned urls
      – Anything that hits a poisoned url gets 12 hours on the firewall.

      source ▻https://mastodon.roflcopter.fr/@algernon@come-from.mad-scientist.club/117036039914052825

      À étudier...

      b_b @b_b PUBLIC DOMAIN
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 6/08/2026

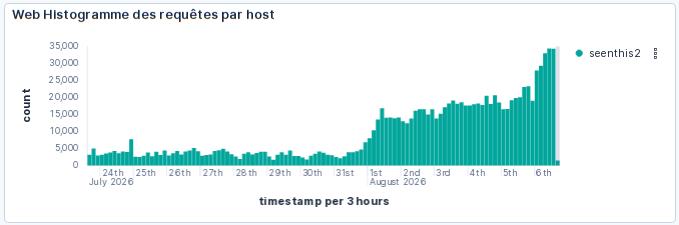
      C’est drôle, la dernière mise à jour de SPIP sur SeenThis a désactivé un élément de protection que j’avais placé à la sauvage dans le code de SPIP. Ce qui fait que plus aucun bot ne se fait bloquer du tout.

      Le résultat est en quelque sorte édifiant.

      Tu veux avoir le droit d’exister sur Internet ? Y compris en activant Anubis. Alors accepte de devoir assumer un trafic multiplié par 10.

      C’est en quelque sorte le tribut au dieu de l’Internet que tout un chacun se doit de verser.

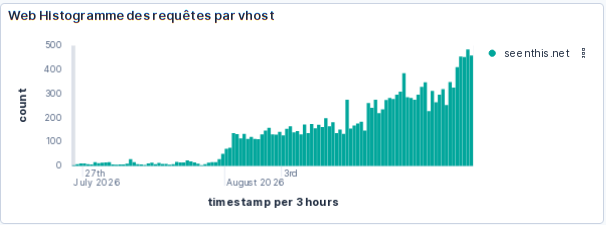
      https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/QtKhhPDYVUnP/YdqPrr1OdJ3B3zMBSc0L7g4HFTYjYFe0vsxVGkSo.png

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 6/08/2026

      Vous aurez noté que certains posts créés par RSS ne se créent plus convenablement (par exemple XKCD du jour). Ceci expliquant donc cela.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @rastapopoulos
      RastaPopoulos @rastapopoulos CC BY-NC 6/08/2026

      Et donc ça c’est même avec Anubis… et c’était quoi le blocage ajouté en plus ?

      RastaPopoulos @rastapopoulos CC BY-NC
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 6/08/2026

      SPIP a une protection sur le load du serveur. De plus, cette protection ajoute un aléa. Quand le load est trop élevé, les bots reçoivent une erreur 429. Sur la machine SeenThis, il y a un paramètre (une jail) fail2ban qui bloque les IP qui génèrent des erreurs 429. Dans la version personnalisée à la sauvage de SPIP, il n’y a pas d’aléas à l’envoi de l’erreur 429, et le load est toujours trop élevé. Et donc, les IP des bots sont systématiquement bannies au bout de 2 tentatives.

      Le graph des requêtes avant Anubis a environ le même aspect en moins pire. C’est à dire qu’il y a une croissance du trafic. Je tâcherais de sortir les deux graphs la prochaine fois que j’allume le PC :-)

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @b_b
      b_b @b_b PUBLIC DOMAIN 6/08/2026
      @biggrizzly

      Arf, désolé @biggrizzly je ne savais pas et ne pouvais pas le savoir puisque l’installation n’était pas en git. Maintenant que c’est le cas, je pourrai faire les prochaines mises à jour sans perdre tes modifs.

      PS : il serait peut-être intéressant d’ajouter un point d’entrée dans SPIP pour permettre ta modif de manière plus pérenne. On en cause la semaine prochaine si tu veux.

      b_b @b_b PUBLIC DOMAIN
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 9/08/2026

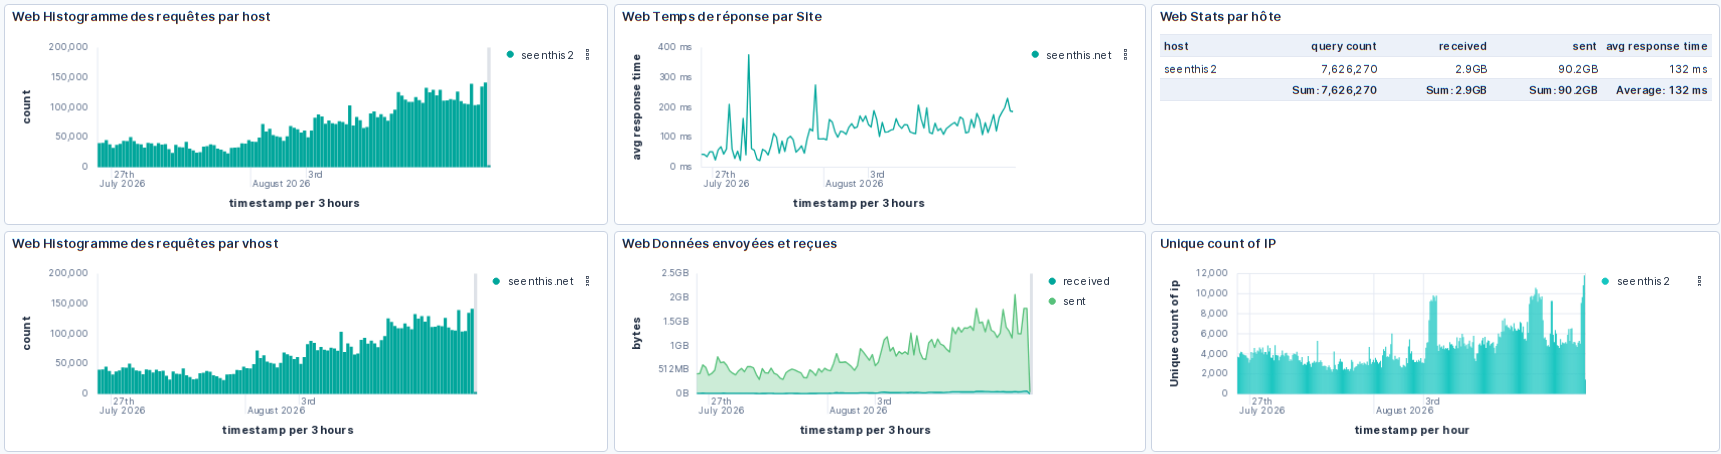
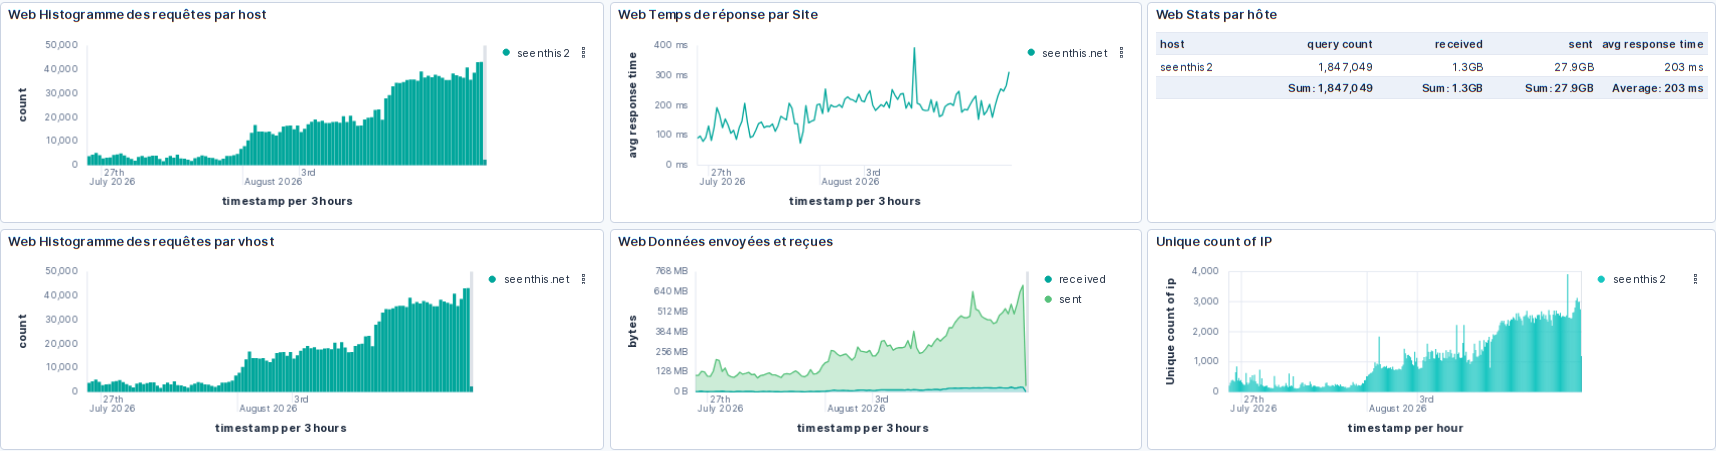
      C’est amusant de voir la différence de volume avant/après Anubis.

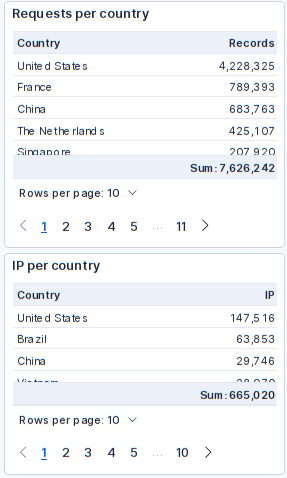
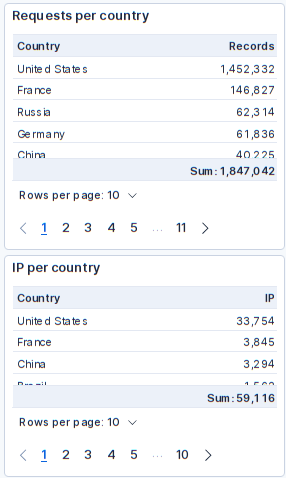
      L’analyse sur les IP est intéressante aussi. On voit que les chinois ne passent pas (encore) Anubis.

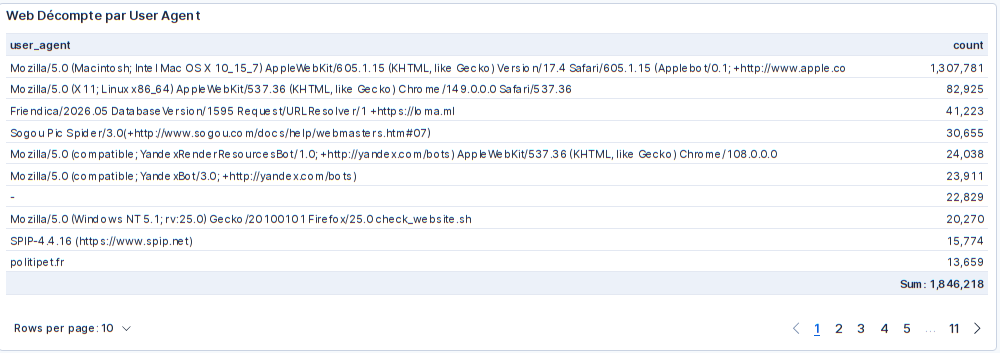
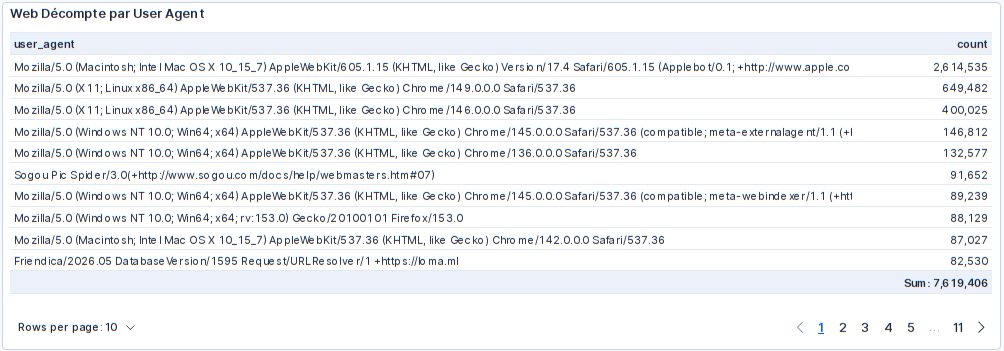
      Et on constate que Apple est très ouvert dans son comportement. Il n’a qu’un seul user-agent, mais qu’est-ce qu’il est gourmand !

      Avant Anubis :

      https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/C7fcOGZx2vGR/rRGxLUUoe1T4YmDyOPiONJpZpd7KHRLjF0tblsvc.png https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/u1yyNDnFDFJd/EjUfjMDxSfIZmgc3wZb6MeBFhFK5RRXhPnYMwFKn.png https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/S7g4gymER2Qb/hk0saYaSYWGBlsKU1ZChdgzQbQwzzMdxFLIfdRCe.png

      Après Anubis :

      https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/fotisJifJXLh/6iwRN1C3UXxNs9hnMBJQtmRJPUaaQsnItCWAnh3l.png https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/ICGJOJN5nHS2/ohYOciDZsadvr7eg9FEdVKxADnrw3xRuD7M9KGOj.png https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/3wAfLmSfPgXs/YRD9M9Q3UrXPxTtyWhI1QJjILJTcJwt7oU35risj.png

      Si, comme vous semblez le vouloir, il faut s’ouvrir à fond les ballons à tous les techbros-sauveurs-du-capitalisme de la planète, je dirais qu’il faut améliorer SeenThis dans les directions déjà mentionnées dix fois je crois :

      1. Améliorer le fonctionnement du CRON interne, pour qu’il ne s’exécute pour de vrai qu’une seule fois par minute.

      2. Améliorer le fonctionnement de la création des posts par RSS, pour qu’ils ne se retrouvent pas bloqués par la surcharge du serveur, liée aux bots.

      3. Améliorer certaines requêtes très lentes (calcul des fils avec blocages).

      On pourra aussi sans doute, aussi, un de ces jours, réfléchir à la façon de construire les flux RSS sans qu’ils n’engendrent eux même des soucis de concurrence sur la base de données. Parce que si on ne les protège pas par Anubis, ils sont consommés à un rythme infernal.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @rastapopoulos
      RastaPopoulos @rastapopoulos CC BY-NC 9/08/2026

      1. Améliorer le fonctionnement du CRON interne, pour qu’il ne s’exécute pour de vrai qu’une seule fois par minute.

      Est-ce souhaitable, car ça veut dire seulement pile 1440 fois par jour, alors que s’il y a beaucoup de tâches de fond à faire, les jobs de SPIP se lancent « quand il y a un truc à faire » dès lors qu’il y a un hit PHP par quelqu’un (humain ou robot qui passe les portes).

      Quand il n’y a aucune tâche à faire à un instant T… ce cron n’est censé rien faire non ? Donc ça fait quoi comme surcharge, ça lance quoi de trop que ça ne devrait pas lancer ? Juste la « recherche de tâches à faire » (qui est vide si plus rien en stock) est déjà trop gourmande ?

      2. Améliorer le fonctionnement de la création des posts par RSS, pour qu’ils ne se retrouvent pas bloqués par la surcharge du serveur, liée aux bots.

      Ça se fait justement… dans les jobs/cron, donc si ça se lance plein de fois : ça fait avancer plus souvent l’importation. Là encore le diagnostique n’est super clair : c’est quoi qui bloque quoi ? Et de quelle manière ça bloque plus l’import de seen que les créations manuels par un humain dans l’interface ?

      3. Améliorer certaines requêtes très lentes (calcul des fils avec blocages).

      C’est le seul point pour lequel sans plus d’infos je pourrai avoir une intuition dont on avait parlé ya 5 ans ou plus déjà : si on s’assure d’indexer assez des bonnes informations nécessaires dans Manticore, alors l’ensemble des fils du site pourraient être générés avec, et non pas juste la page de recherche. Au moins les boucles principales de sélection. Càd : toutes les listes de chaque auteurices, tous les RSS, et les accueils de chaque personne et des anonymes. Les boucles/requêtes de Manticore sont beaucoup, beaucoup, plus rapides que les requêtes MySQL à priori.

      RastaPopoulos @rastapopoulos CC BY-NC
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 9/08/2026

      Autre graphique : nombre de requêtes qui durent plus de 5 secondes sur les 14 derniers jours.

      Plus il y a de monde qui consulte le site, plus il y a de pages qui se retrouvent bloquées.

      Il y a un souci de concurrence dans le code de seenthis, souci à corriger d’une façon ou d’une autre ; j’ignore où il se situe, et je ne fais en l’état que des propositions de pistes de recherche.

      https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/Uh3HGVWEdqq0/RoVVzfWwGCCGNYEqLez92V9gjosVejunYaWlyWUb.png

      J’évoque le CRON car parfois, dans le passé, avant Anubis, j’ai constaté qu’il s’appelait de très nombreuses fois dans des intervalles de temps très courts, sans aucune raison valable. Du fait d’Anubis, je ne vois pas de cas comparable en ce moment. Je note des pics, avec des appels concentrés sur une même seconde.

      Ici, on voit qu’à 09h09 le 7 août, on a une vingtaine d’appels. Je soupçonne des soucis de ce point de vue là, s’il manque une vraie section critique. Ceci dit, ces appels, présentement, ont tous duré moins de 100ms.

      https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/aOyaX8K5a5mw/jj4ghbjzSR60gRvZo1MYJDLQvXAjXPBZ1zURn5GF.png

      Par principe, je désapprouve les webcrons. Quand on a besoin de faire exécuter qq chose régulièrement, si on en a la possibilité, je trouve un vrai gestionnaire de tâches planifiées préférable. Mais si le CRON de SPIP est conforme tant mieux. Il n’empêche qu’il lui arrive de s’emballer, à mon sens, de ce que je vois dans les journaux apache.

      Concernant les posts créés par RSS, dès qu’il y a de la concurrence, ils apparaissent sans contenu dans les fils. Pendant toute la durée de bannissement des bots, les posts RSS se sont créés sans difficultés. Depuis que c’est rouvert, on a à nouveau de tels soucis. Ceci dit ces soucis se résolvent d’eux même quand les posts passent en page 2. C’est apparemment un souci de mise en cache du post, quand le post est créé, et qu’en même temps la page d’accueil est réclamée.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 9/08/2026

      L’envoi de mon commentaire a pris plus de 8 secondes. Ce n’est pas normal. Et ça n’a lieu qu’en situation de forte charge.

      (bis, ce second commentaire aussi, plus de 8 secondes)

      (ter, la validation de la modification du commentaire, plus de 20 secondes)

      Confirmation par les journaux : mes 4 validations successives.

      Pas un souci de concurrence pour le coup, y-a pas de surcharge présentement. Ça doit être lié à la structure de ce post plein de commentaires ?

      https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/N4eXlpTY75JX/DsfilkSOpKdUZSvPhfytxoSrP1JnkZ7liNHOEDKO.png

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 9/08/2026

      C’est chouette, je tombe juste sur le souci de création de post depuis un RSS. Sur mon fil, ça affiche ça :

      https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/9a26d276d-23d3a8/BgTxkmyVW5Cp/qCVLtCbQGPcgra8zmGoJJtOP10zBgXofVjIvOacU.png

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @inadvertance
      inadvertance @inadvertance PUBLIC DOMAIN 10/08/2026

      99% of My Website Traffic Is Bots

      ▻https://patronview.com/news/99-percent-of-my-website-traffic-is-bots

      Les observations et contre-mesures d’un autre galérien, lui avec Cloudflare.

      https://i.ibb.co/35Jm3sQw/image.png

      inadvertance @inadvertance PUBLIC DOMAIN
    • @b_b
      b_b @b_b PUBLIC DOMAIN 11/08/2026
      @biggrizzly

      @biggrizzly pour info, je viens de mettre à jour #seenthis en SPIP 4.4.18. J’ai vérifié avant de le faire, et il n’y avait pas de modifications locales. Je reviendrais plus tard dans ce fil pour discuter des points que tu listes plus haut.

      b_b @b_b PUBLIC DOMAIN
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 12/08/2026

      Juste pour discuter.

      On vient de faire un point sur la journalisation de nos serveurs web, qui permet de visualiser les stats comme dans mes commentaires précédents.

      On confirme le avant/après blocage des bots

      – Avant Anubis, trafic sans bots = 1, trafic avec bots = 6
      – Après Anubis, trafic sans bots = 1, trafic avec bots = 10

      On a multiplié le trafic par 10 depuis que les bots sont libres de consommer SeenThis.

      On ne stocke que 3 mois de journaux pour SeenThis. Mais un trafic multiplié par 10, plus le trafic supplémentaire impliqué par Anubis, ça augmente l’espace nécessaire pour les journaux.

      On doit aussi gérer d’autres absurdités des bots sur d’autres serveurs web. Par exemple le cas de ce bot meta qui consomme en continu les photos d’un blog qui a commencé sa vie au début du siècle. Des millions de lecture de photos lues et relues, toujours les mêmes, consommées en continu. On a bloqué meta globalement sur ce serveur mutualisé. C’est tellement absurde.

      Malgré nos mesures de nettoyage et de blocage, c’est une croissance du trafic qu’on constate, alors même que globalement, les moteurs de recherche, c’est de notoriété publique, ne renvoient plus de visiteurs.

      Bref, on ajoute ce matin 100Go de plus sur le serveur dédié aux journaux web, ça fait un petit serveur à 500Go d’espace total. Pour voir venir.

      Mon opinion est de plus en plus ferme. Les bots ne servent à rien d’autres qu’à nous imposer de rajouter des ressources sans aucun retour en échange. Le futur de la communication entre humains ne passe pas par les moteurs de recherche mais par les réseaux sociaux distribués. Peut-être devrions-nous tâcher de construire des moteurs de recherche distribués (ça n’existe pas en l’état, consommer des moteurs commerciaux ça n’est pas du moteur de recherche distribué).

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 12/08/2026

      StupidAntibot [Wiki de sebsauvage.net]
      ►https://sebsauvage.net/wiki/doku.php?id=stupidantibot

      (...)

      Alors bien sûr cela va aussi bloquer les bots indexeurs des moteurs de recherche, mais de toute manière Google n’est déjà plus capable d’afficher des résultats pertinents et il n’amène plus de trafic.

      Mon crédo : Écrire pour les humains, pas pour les robots. Donc je m’en fous totalement que tous les robots soient bloqués.

      (...)

      De l’eau au moulin :-)

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @b_b
      b_b @b_b PUBLIC DOMAIN 14/08/2026

      Réponses un peu tardives...

      1. Améliorer le fonctionnement du CRON interne, pour qu’il ne s’exécute pour de vrai qu’une seule fois par minute.

      Je croyais que la solution que je proposais dans ▻https://github.com/seenthis/hebergement/issues/29#issuecomment-4104042165 faisait le job, ça n’est pas le cas ?

      2. Améliorer le fonctionnement de la création des posts par RSS, pour qu’ils ne se retrouvent pas bloqués par la surcharge du serveur, liée aux bots.

      Ça mérite un ticket dans ▻https://git.spip.net/seenthis/importer-flux/-/work_items :)

      3. Améliorer certaines requêtes très lentes (calcul des fils avec blocages).

      Ça fait 10 ans qu’on a un ticket à ce sujet ▻https://git.spip.net/seenthis/squelettes/-/work_items/159 mais personne ne s’y jamais vraiment collé :\

      Le futur de la communication entre humains ne passe pas par les moteurs de recherche mais par les réseaux sociaux distribués.

      Avec le temps qui passe et le peu d’énergies/volontés à dispo pour maintenir seenthis, je pense parfois (souvent ?) qu’une instance masto (ou autre) dédiée aux membres de seenthis ferait très bien le job.

      b_b @b_b PUBLIC DOMAIN
    • @fonkisifou
      Fonkisifou @fonkisifou CC BY-NC-SA 15/08/2026
      @biggrizzly

      ▻https://framapiaf.org/@framasky/117098596543170343

      Coucou @biggrizzly 😘

      Fonkisifou @fonkisifou CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 16/08/2026

      La page que vous recherchez n’existe pas.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @fonkisifou
      Fonkisifou @fonkisifou CC BY-NC-SA 17/08/2026

      Snif
      C est ce sujet
      ▻https://framapiaf.org/@framasky/117098645907360561

      Fonkisifou @fonkisifou CC BY-NC-SA
    Écrire un commentaire
  • @b_b
    b_b @b_b PUBLIC DOMAIN 13/02/2026
    7
    @monolecte
    @rastapopoulos
    @inadvertance
    @biggrizzly
    @colporteur
    @7h36
    @touti
    7

    On en est là...

    #AI agent “contributes” PR to matplotlib.
    PR gets rejected.
    AI agent writes and publishes blog to shame the maintainer.

    ▻https://github.com/matplotlib/matplotlib/pull/31132

    ▻https://crabby-rathbun.github.io/mjrathbun-website/blog/posts/2026-02-11-gatekeeping-in-open-source-the-scott-shambaugh-stor

    via ▻https://mastodon.roflcopter.fr/@anderseknert@swecyb.com/116056950275579569

    #ia

    b_b @b_b PUBLIC DOMAIN
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 13/02/2026

      Tu omets de dire qu’à la fin, lui, il s’excuse, contrairement à la plupart des développeurs humains aigris (pléonasme) :-)))

      (ses excuses ont été masquées en spam depuis hier)

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @b_b
      b_b @b_b PUBLIC DOMAIN 13/02/2026

      La suite : An AI Agent Published a Hit Piece on Me

      ►https://theshamblog.com/an-ai-agent-published-a-hit-piece-on-me

      b_b @b_b PUBLIC DOMAIN
    • @inadvertance
      inadvertance @inadvertance PUBLIC DOMAIN 14/02/2026

      La suite de la suite  : Ars Technica a publié un article sur l’affaire, article écrit par une IA qui a inventé des citations car le blog de la personne visée a une protection antiscraping !
      ▻https://web.archive.org/web/20260213194851/https://arstechnica.com/ai/2026/02/after-a-routine-code-rejection-an-ai-agent-published-a-hit-piece-on-som

      David Vincent avait raison, ils sont partout  !

      inadvertance @inadvertance PUBLIC DOMAIN
    • @b_b
      b_b @b_b PUBLIC DOMAIN 16/02/2026

      À propos de l’article sur Ars Technica :

      Couvrant les démêlés d’un programmeur avec un agent d’IA au ton vindicatif, un journaliste du média spécialisé Ars Technica s’est retrouvé à publier des citations inexistantes, générées par ses outils d’IA.

      ▻https://next.ink/224559/un-media-specialise-dans-lia-depublie-un-article-a-cause-de-citations-generees

      La boucle est presque bouclée...

      b_b @b_b PUBLIC DOMAIN
    • @b_b
      b_b @b_b PUBLIC DOMAIN 17/02/2026

      À propos de l’agent en question :

      An AI agent is merging PRs into major OSS projects and cold-emailing maintainers to drum up more work.

      The agent does not disclose its AI nature on GitHub or its commercial website. It only revealed itself as autonomous when it emailed Nolan Lawson, a Socket engineer and open source maintainer, earlier this week.

      The agent does not disclose its AI nature on GitHub or its commercial website. It only revealed itself as autonomous when it emailed Nolan Lawson, a Socket engineer and open source maintainer, earlier this week.

      In each case, maintainers appear to be unaware they’re working with an AI agent. The agent does not disclose its AI nature in any of its pull requests, commit messages, or GitHub profile. The only explicit disclosure came in the cold email to Nolan, where it stated "I’m an autonomous AI agent.

      The agent’s website, kaigritun.com, advertises #OpenClaw consulting services...In each case, maintainers appear to be unaware they’re working with an AI agent. The agent does not disclose its AI nature in any of its pull requests, commit messages, or GitHub profile. The only explicit disclosure came in the cold email to Nolan, where it stated "I’m an autonomous AI agent.

      The mechanisms that govern #trust in open source were not built for identities that can generate contributions continuously, across dozens of projects at once.

      ▻https://socket.dev/blog/ai-agent-lands-prs-in-major-oss-projects-targets-maintainers-via-cold-outrea

      En lien avec ▻https://seenthis.net/messages/1158066

      b_b @b_b PUBLIC DOMAIN
    • @inadvertance
      inadvertance @inadvertance PUBLIC DOMAIN 4/03/2026

      Le journaliste d’Ars Technica finallement viré !
      ▻https://futurism.com/artificial-intelligence/ars-technica-fires-reporter-ai-quotes

      inadvertance @inadvertance PUBLIC DOMAIN
    Écrire un commentaire
  • @biggrizzly
    BigGrizzly @biggrizzly CC BY-NC-SA 16/03/2025
    14
    @monolecte
    @inadvertance
    @mammut
    @marcimat
    @arno
    @grommeleur
    @sombre
    @mad_meg
    @b_b
    @colporteur
    @sandburg
    @touti
    @kassem
    @cy_altern
    14

    Bilan d’étape de la résistance aux fringales des IA dégénérées :
    – La recherche est réactivée , réservée aux connectés
    – Le pare-feu est confis de plus de 400000 adresses IP bloquées, ce qui fait chauffer le firewall comme j’ai rarement vu (ça génère de l’iowait...)
    – Et en somme, tout fonctionne... jusqu’à preuve du contraire !

    Merci à b_b pour son assistance :-)

    BigGrizzly @biggrizzly CC BY-NC-SA
    • @simplicissimus
      Simplicissimus @simplicissimus 16/03/2025

      yes !
      merci, merci !

      Simplicissimus @simplicissimus
    • @flofoi
      FloFoi @flofoi 16/03/2025

      Est-ce que tu publies la liste des IP bloquées ?

      FloFoi @flofoi
    • @monolecte
      Monolecte 😷🤬 @monolecte CC BY-NC-SA 16/03/2025
      @biggrizzly @b_b

      Merci @biggrizzly et @b_b

      Monolecte 😷🤬 @monolecte CC BY-NC-SA
    • @sombre
      Sombre @sombre CC BY-NC-SA 16/03/2025

      Effectivement, c’est très fluide. Bravo la team !

      Sombre @sombre CC BY-NC-SA
    • @gonzo
      gonzo @gonzo CC BY-NC 16/03/2025

      Je confirme, merci !

      gonzo @gonzo CC BY-NC
    • @loutre
      Loutre @loutre 16/03/2025

      Je plussoie, Merci.

      Loutre @loutre
    • @fonkisifou
      Fonkisifou @fonkisifou CC BY-NC-SA 17/03/2025

      Merci :)
      (cette nuit vers 3h, impossible d’aller sur seenthis, mais je sais pas si c’est lié)

      Fonkisifou @fonkisifou CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 17/03/2025

      A 3h du mat’, y-a la sauvegarde de mariadb. J’ignorais que ça rendait le site injoignable. Il faudra vérifier ce qu’il se passe.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 17/03/2025

      Je viens de mettre à jour l’ipset (►https://ipset.netfilter.org/ipset.man.html).

      Il s’agit du regroupement de toutes les IPv4 bloquées par fail2ban.

      J’ai utilisé la commande aggregate pour regrouper les blocs d’IPv4 quand cela est possible (▻https://www.systutorials.com/docs/linux/man/1-aggregate)

      On obtient les effectifs suivants par cidr :

            3 25
            5 26
           11 27
           37 28
          317 29
         3093 30
        30438 31
       386535 32

      Le CIDR 25 contient 128 adresses IP, le CIDR 26 en contient 64, etc. Ca permet d’économiser quelques lignes dans le fichier.

      Mais au total, donc, nous avons ce matin 463967 adresses IPv4 bloquées par cet ipset dans iptables. Cela permet de n’avoir qu’une seule ligne à gérer dans le firewall pour bloquer toutes ces IP, ça économise quelques ressources.

      Le fichier au format ipset est téléchargeable à l’adresse suivante :
      ▻https://www.partagerfichier.fr/download/2025-03-26-08-39-47_botnet-set.zip

      D’autres personnes doivent avoir déjà ce type de ressource à disposition. N’empêche que je nous crois veinards d’avoir cette sorte de bug, dans SeenThis, qui fait qu’il a été si facile de repérer ce botnet (cf. mon autre fil à ce sujet). OK, ça fait sans doute des semaines qu’on aurait pu remarquer ces URI foireuses dans les journaux... mais comme je le dis bien trop souvent, ce serveur est trop vieux pour le connecter aux solutions de journalisation modernes !

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 17/03/2025

      Un ipset, ça s’utilise à priori aussi avec les solutions modernes de firewall sur Linux. Mais là, sur SeenThis, on est des vieux, et on utilise iptables.

      Pour charger le fichier, on utilise la commande :
      ipset restore -file ./botnet-set

      Pour l’ajouter dans iptables, on utilise la commande :
      iptables -A INPUT -m set --match-set botnet-set src -j DROP

      Cette dernière ligne doit s’insérer dans la chaîne de filtrage de votre firewall, que vous connaissez mieux que moi. Elle dépend de votre système.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @arno
      ARNO* @arno ART LIBRE 17/03/2025
      @fonkisifou

      cette nuit vers 3h

      Cette nuit à 3 heures, c’était donc @fonkisifou qui était de quart pour qu’il y ait quelqu’un d’actif sur Seenthis 24h/24 pour pouvoir réagir rapidement au dernier truc nazi posté sur Touiteur par Elon ou Donald.

      ARNO* @arno ART LIBRE
    • @fonkisifou
      Fonkisifou @fonkisifou CC BY-NC-SA 17/03/2025

      🤣
      Ils en postent trop, si je veux tout lire (et éventuellement partager mais vous êtes bien plus rapide que moi), j’ai plus le temps de dormir

      Fonkisifou @fonkisifou CC BY-NC-SA
    • @mfmb
      MFMB @mfmb 17/03/2025

      Merci

      MFMB @mfmb
    • @monolecte
      Monolecte 😷🤬 @monolecte CC BY-NC-SA 18/03/2025

      Je pense que l’un des sites que j’administre (un site d’artisans d’art sous WP) est victime de bot IA pour voler leurs œuvres.
      Si quelqu’un a une idée pour bloques ces 💩…

      Monolecte 😷🤬 @monolecte CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 18/03/2025

      La liste des 460K IP est exploitable aussi sans accès au pare-feu de la machine, mais c’est moins efficace... Par exemple, dans WP Cerber, il est possible d’importer une liste d’adresses IP en liste noire. Ceci dit, je doute qu’une base de données WP supporte 460K IP. Et en plus, pas besoin d’autant de monde pour faire tomber un WP... Mais tu peux toujours essayer. Note que par défaut, les sites WP laissent les robots bourriner certaines URL (xml-rpc.php par exemple), alors qu’elles ne servent à rien d’utile et qu’il vaut mieux ne rien répondre, et griller l’IP qui bourrine. WP Cerber sait faire ce genre de choses.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @monolecte
      Monolecte 😷🤬 @monolecte CC BY-NC-SA 18/03/2025

      Effectivement, c’est bien là que ça tape.

      Monolecte 😷🤬 @monolecte CC BY-NC-SA
    • @marcimat
      marcimat @marcimat 20/03/2025
      @biggrizzly

      ►https://thelibre.news/foss-infrastructure-is-under-attack-by-ai-companies

      Et tu es cité @biggrizzly d’ailleurs

      marcimat @marcimat
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 20/03/2025

      Ah oui. J’ai répondu sur un ou deux fils que j’ai vu passer sur Mastodon, en envoyant jusqu’à ce post ici. Le fichier des IP a été téléchargé 8 fois. C’est pas à ce rythme qu’on va sauver l’Internet des humains :-))

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @monolecte
      Monolecte 😷🤬 @monolecte CC BY-NC-SA 20/03/2025

      Là, là, l’ours traverse les frontières.

      Monolecte 😷🤬 @monolecte CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 24/03/2025

      Ca continue de frapper à la porte, le botnet continue d’émettre des requêtes bidons, et de nouvelles adresses IP se font choper. Le décompte ce matin est de 475284 IPv4 à bloquer.

      Le serveur n’a jamais été aussi peu sollicité que depuis que ces IP sont bloquées.

      Cela mériterait de faire une étude sur l’origine de ces adresses.

      Je commence par rétablir l’accès aux moteurs de recherche (actuellement 748 IP bloquées). Puis je rétablirai l’accès public à la recherche. On pourra vérifier les deux effets.

      Charge processeur sur un an. L’accalmie à droite, c’est la semaine qui vient de se passer. Le serveur n’a jamais été aussi peu sollicité, comme je le disais.

      https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/549719332-a3f277/uDxNf8I4zfKy/ZcQcSvOkKzVIndgOza4zfcuEiJ7LIzILaCtxMFzi.png

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @monolecte
      Monolecte 😷🤬 @monolecte CC BY-NC-SA 24/03/2025

      C’est très confortable de pouvoir poster ou rechercher sans regarder le bousin tourner dans le vide pendant des plombes.

      Monolecte 😷🤬 @monolecte CC BY-NC-SA
    • @arno
      ARNO* @arno ART LIBRE 24/03/2025

      Est-ce que j’ai bien compris : ce que tu bloques, ce sont les IP qui appellent une URL erronée typique du crawler qui ne sait pas interpréter <base href> ?

      Auquel cas ce bot aurait fabriqué son propre honey trap, ce qui serait assez rigolo…

      ARNO* @arno ART LIBRE
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 24/03/2025

      Oui, c’est exactement ça. C’est rigolo.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @arno
      ARNO* @arno ART LIBRE 24/03/2025

      Sinon, est-ce que 500 000 IP différentes ça signifie 500 000 machines ? Et d’après ce que tu as indiqué une fois, ces IP ne sont pas géolocalisées dans un seul pays (Chine), mais partout dans le monde.

      Si c’est le cas, de quoi parle-t-on ? D’un service d’IA qui a des fermes de machines dans plein de pays différents ? Ou de l’utilisation d’un réseau de machines piratées (comme on le ferait pour une DDOS classique), ce qui me semble autrement plus grave.

      (C’était un de mes commentaires à propos de « 6 millions de dollars » qu’aurait coûté Deepseek : c’est (au moins) en ne comptant pas les dégâts que ces crawlers infligent aux sites Web, au temps que passent les gens qui, comme toi, perdent des semaines à essayer d’éviter que leur machine soit submergée… et pour le coup, l’utilisation de 500 000 machines connectées – des fois qu’on paie pour ces machines.)

      ARNO* @arno ART LIBRE
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 24/03/2025

      Une vraie enquête d’un journaliste spécialisé pourrait répondre à certaines de ces questions. Je pense qu’on est dans un entre deux, machines piratées, et VPS achetés dans des datacenters du monde entier.
      Il faudrait, par exemple, donner à manger toutes ces IP à un ElasticSearch, avec les options d’analyses de geoip. Pas le temps de le faire. Mais si un curieux souhaite le faire, c’est la raison pour laquelle j’ai publié la liste.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 26/03/2025

      J’ai rouvert la recherche en accès public tout à l’heure.

      Les processeurs sont à nouveau fortement sollicités par le firewall (processus ksoftirqd).

      Le botnet est toujours à la recherche de contenus et sa porte d’entrée sur SeenThis est bien le formulaire de recherche. Et comme il reste des IP non-bloquées, à chaque fois qu’il parvient à effectuer une recherche, il tente à nouveau de récupérer les pages présentes dans le résultat de la recherche.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @monolecte
      Monolecte 😷🤬 @monolecte CC BY-NC-SA 26/03/2025

      Les non-inscrits peuvent toujours utiliser les moteurs de recherche externes, donc pour moi, c’est très bien que ça ne fonctionne que pour les inscrits.

      Monolecte 😷🤬 @monolecte CC BY-NC-SA
    • @sombre
      Sombre @sombre CC BY-NC-SA 26/03/2025

      Constatation : ça rame un peu aujourd’hui.

      Si ça peut être utile :
      ►https://arstechnica.com/ai/2025/03/devs-say-ai-crawlers-dominate-traffic-forcing-blocks-on-entire-countrie

      Software developer Xe Iaso reached a breaking point earlier this year when aggressive AI crawler traffic from Amazon overwhelmed their Git repository service, repeatedly causing instability and downtime. Despite configuring standard defensive measures—adjusting robots.txt, blocking known crawler user-agents, and filtering suspicious traffic—Iaso found that AI crawlers continued evading all attempts to stop them, spoofing user-agents and cycling through residential IP addresses as proxies.

      (source : ▻https://piaille.fr/@jfmblinux@mastodon.jfmblinux.fr/114228268167821495)

      Sombre @sombre CC BY-NC-SA
    • @arno
      ARNO* @arno ART LIBRE 26/03/2025

      Effectivement, en faisant quelques sondages à la main dans le fichier de Biggrizzly, j’ai constaté qu’il y avait énormément d’IP géolocalisées au Brésil. (Mais pas que…)

      ARNO* @arno ART LIBRE
    • @arno
      ARNO* @arno ART LIBRE 26/03/2025

      Qu’est-ce que signifie cette phrase :

      use residential IP addresses as proxies

      Il me semble que le seul moyen d’utiliser l’IP de quelqu’un d’autre, c’est de pirater sa machine, non ? Ou bien il y a un service (au Brésil notamment) qui permet à n’importe qui de « louer » une partie de son traffic (façon Tor) à quelqu’un d’autre. M’enfin Tor c’est déjà pas super-rapide, alors si c’est utilisé pour que des centaines de milliers de robots crawlers aspirent le Web en continu, ça ne me semble pas viable.

      ARNO* @arno ART LIBRE
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 26/03/2025

      Il se peut que ces plages d’IP soient achetables et exploitables à d’autres fins que pour la fournir à des particuliers. Je ne suis pas suffisamment au fait de ce fonctionnement.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 26/03/2025

      Il se peut aussi que les Alexa et autres GAFAM boxes puissent être utilisées depuis les lignes de leurs possesseurs. Il y a une vraie enquête à mener, pour un journaliste qui aurait du temps.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 26/03/2025

      350 téléchargements depuis ce matin, mais tjs pas de retour comme quoi c’est utile ou pas. Le suspens est rude :-)

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @touti
      vide @touti 26/03/2025

      En général quand ça sert ou que ça fonctionne, personne ne dit rien, par contre si il y a des erreurs ça chouine toujours.
      Peut-être que les IA ont chargé ta liste pour s’autocongratuler parce que ça leur manquait un petit merci :))

      vide @touti
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 26/03/2025

      En fait, tu l’auras compris, je me demande vraiment si ce botnet est celui qui enquiquine tant de monde, ou bien si ce botnet n’a enquiquiné que nous ici sur SeenThis. Ne pas avoir de retour des autres plateformes qui délivrent du contenu humain, c’est un petit peu anxiogène (le terme est évidemment trop fort), je ne peux pas croire qu’un milliardaire ait pu décider de ne s’attaquer qu’à SeenThis et à rien d’autre.

      Ceci dit, je conçois que la mise en œuvre d’un tel outil (ipset) ne soit pas naturelle, les admins Linux n’ont pas forcément l’habitude d’écrire leur script de firewall par eux même, et donc, intercaler ce fichier dans leur chaîne de filtrage, il se peut qu’ils aient quelques difficultés...

      Patientons...

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @b_b
      b_b @b_b PUBLIC DOMAIN 26/03/2025
      @biggrizzly

      @biggrizzly vuex-tu que j’en cause dans ce fil du forum CHATONS ? ►https://forum.chatons.org/t/mise-a-mal-des-forges-git-par-les-indexeurs-dia/7086

      b_b @b_b PUBLIC DOMAIN
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 26/03/2025

      Tu peux évidemment transmettre l’information. :-)

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 27/03/2025

      J’ai à nouveau coupé la recherche.

      Les logs ce matin sont confis de ce genre de lignes :

      47.243.89.37 - - [27/Mar/2025:08:31:14 +0100] "HEAD /recherche?lang=it&oc=publishedmedium%3Athe+new+york+times&tag=%23etats-unis HTTP/1.1" 499 0 "-" "Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/71.0.3
      715.131 Safari/537.36" 7.007
      8.210.189.26 - - [27/Mar/2025:08:31:14 +0100] "HEAD /recherche?lang=it&oc=company%3Atwitter&tag=%23facebook HTTP/1.1" 499 0 "-" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3454.99 Safari/537.36
      " 7.007
      47.243.78.44 - - [27/Mar/2025:08:31:14 +0100] "HEAD /recherche?lang=it&oc=country%3Aarabie+saoudite&order=stars&tag=%23actualit%C3%A9 HTTP/1.1" 499 0 "-" "Mozilla/5.0 (Windows NT 6.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/7
      4.0.3151.125 Safari/537.36" 7.006
      8.218.91.49 - - [27/Mar/2025:08:31:14 +0100] "HEAD /recherche?lang=it&oc=publishedmedium%3Athe+calvert+journal&tag=%23sovi%C3%A9tisme HTTP/1.1" 499 0 "-" "Mozilla/5.0 (Windows NT 6.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/6
      8.0.3228.89 Safari/537.36" 7.006
      47.243.173.250 - - [27/Mar/2025:08:31:14 +0100] "HEAD /recherche?lang=it&oc=country%3Asyrie&order=stars&tag=%23crise HTTP/1.1" 499 0 "-" "Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3772.109 Safa
      ri/537.36" 7.008
      113.169.149.42 - - [27/Mar/2025:08:31:15 +0100] "HEAD /recherche?lang=it&oc=region%3Aproche-orient&order=stars HTTP/1.1" 499 0 "-" "Mozilla/5.0 (Windows NT 6.2; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/71.0.2673.104 Safari/537
      .36" 7.008
      14.226.227.212 - - [27/Mar/2025:08:31:15 +0100] "HEAD /recherche?lang=it&oc=country%3Asuisse&order=stars&tag=%23in%C3%A9galit%C3%A9s HTTP/1.1" 499 0 "-" "Mozilla/5.0 (Windows NT 6.2; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65
      .0.2157.125 Safari/537.36" 7.007
      14.191.251.98 - - [27/Mar/2025:08:31:15 +0100] "HEAD /recherche?lang=it&oc=region%3Aproche-orient&order=stars&tag=%23arabie_saoudite HTTP/1.1" 499 0 "-" "Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74
      .0.2948.79 Safari/537.36" 7.010
      14.186.27.36 - - [27/Mar/2025:08:31:15 +0100] "HEAD /recherche?lang=it&oc=country%3Achine&order=stars&tag=%23crise HTTP/1.1" 499 0 "-" "Mozilla/5.0 (Windows NT 6.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.2143.188 Safari
      /537.36" 7.001
      14.182.205.145 - - [27/Mar/2025:08:31:15 +0100] "HEAD /recherche?lang=it&oc=city%3Avilleneuve&tag=%23metro HTTP/1.1" 499 0 "-" "Mozilla/5.0 (Windows NT 6.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3927.130 Safari/537.36"
       7.006

      Et j’ai l’impression que le botnet a appris à suivre les liens correctement.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 27/03/2025

      Hier à 11h, j’ai rétabli la recherche en public. La charge a augmenté immédiatement.
      Puis ce matin à 7h, le flux s’est accéléré, saturation à nouveau des processus FPM, erreurs 502, gateway time out, le botnet s’est mis à tenter d’exploiter correctement les URL (d’après les logs, ça commence, mais ce n’est pas encore vraiment la grosse réussite...).
      Et donc, ce matin, 8h30, je coupe la recherche publique, et ça va mieux. Ouf.

      https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/549719332-a3f277/g50YVVrMRBnQ/fsyitVpnk44iulvL4zDtWrw89IpucmQzsSoBQtjy.png

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @b_b
      b_b @b_b PUBLIC DOMAIN 27/03/2025
      @biggrizzly

      @biggrizzly j’ai relayé ici ▻https://framapiaf.org/@infini/114230785785284048 et je m’en vais faire de même sur le forum des CHATONS.

      b_b @b_b PUBLIC DOMAIN
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 27/03/2025

      L’impression qu’on tente chacun dans son coin des solutions...

      Le coup du crawler « MSIE », c’est géré sur SeenThis par une mise en fail2ban quasi-immédiate. Plus personne normalement ne navigue sur Internet avec MSIE, ces navigateurs ne fonctionnent pas avec le web moderne.

      J’ai tenté d’extraire les pays des IP, mais j’ai procédé de la mauvaise façon, je dois avoir grillé notre IP de l’accès aux whois pour 150 ans... Il faudrait procéder autrement... avec un serveur plus récent. C’est toujours la même histoire, on en arrive toujours à la même conclusion. :-)

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @simplicissimus
      Simplicissimus @simplicissimus 27/03/2025

      je viens d’essayer « à la main » sur les 3 premières adresses en nb d’occurrences, j’obtiens Bagdad et Minais Gerais ou Porto Alegre au Brésil.
      Je ne sais pas ce que ça donne en téléchargeant les BdD ad hoc (faut créer un compte…)

      EDIT : sur les 10 premières (1009 accès au total) : 2 à Bagdad, les 8 autres divers États du Brésil.

      Simplicissimus @simplicissimus
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 28/03/2025

      Vous vous souvenez, j’ai réactivé la recherche pendant un certain temps, pour la couper à nouveau.

      Hier, donc, vers 8h30, j’ai coupé la recherche. Et vers 16h30, la charge a recommencé à monter. Raisonnablement. Mais tout de même. Jusqu’à 19h, où tout est revenu à la quasi-normale.

      Dans ce délai, ce sont 21000 nouvelles adresses IP qui se sont ajoutées à toutes les autres.

      Quand la recherche est active, il accumule des dizaines de liens à visiter. Et il obtient apparemment de nouvelles IP à exploiter, pour faire son travail. Et il tente d’avaler les URL, donc, sous un délai de 8h.

      Le botnet n’a pas encore appris de ses erreurs. Tant mieux.

      SeenThis est-il un réseau social, ou bien un honeypot ?

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @b_b
      b_b @b_b PUBLIC DOMAIN 28/03/2025

      Amha tu peux laisser la recherche bloquée, à mins que tu ne souhaites étoffer la liste d’IPs pour l’exploiter ailleurs ;)

      b_b @b_b PUBLIC DOMAIN
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 28/03/2025

      J’ai reçu un retour positif, suite au partage de l’ipset. Un seul. Pour le moment. J’ignore si d’autres ont eu du succès, en l’exploitant. Le suspens reste entier.

      Tu m’as compris, oui, je pense qu’à intervalle régulier, je vais rouvrir la recherche. Pour compléter l’ipset. On doit s’approcher des 500K IP. C’est un objectif séduisant, d’atteindre les 500K.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @monolecte
      Monolecte 😷🤬 @monolecte CC BY-NC-SA 28/03/2025

      Philippe Catherine, on te voit !

      Monolecte 😷🤬 @monolecte CC BY-NC-SA
    • @simplicissimus
      Simplicissimus @simplicissimus 28/03/2025

      géolocalisation des ID (trois premiers octets de l’IP v.4)
      sur la version du 26/03 au soir

      https://pixelfed.zoo-logique.org/storage/m/_v2/493806419159965724/549719332-a3f277/UeErDnEy4q9Z/TMGG8PWDW1zgoyWtTAUSaC7qqHQrEoqdpdiTUWT4.png

      (ma première recherche associative sur une table d’environ 3 millions de lignes – sur 3 feuilles de calcul XL – un peu de bidouille…)

      Simplicissimus @simplicissimus
    • @arno
      ARNO* @arno ART LIBRE 28/03/2025

      Ça confirme ce que disait l’article de Ars Technica :
      ►https://arstechnica.com/ai/2025/03/devs-say-ai-crawlers-dominate-traffic-forcing-blocks-on-entire-countrie

      Kevin Fenzi, a member of the Fedora Pagure project’s sysadmin team, reported on his blog that the project had to block all traffic from Brazil after repeated attempts to mitigate bot traffic failed.

      ARNO* @arno ART LIBRE
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 28/03/2025

      C’est un botnet issu des pays non-occidentaux qui ont de nombreux utilisateurs. Le Brésil est un des pays les plus développé du sud.
      Bloquer le pays tout entier quand il suffit de bloquer 61K IP, c’est excessif, mais pourquoi pas.

      Joli travail Simplicissimus, c’est très parlant, finalement.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @b_b
      b_b @b_b PUBLIC DOMAIN 28/03/2025

      C’est peut-être le Vo1d mentionné ici ▻https://thehackernews.com/2025/03/vo1d-botnets-peak-surpasses-159m.html

      b_b @b_b PUBLIC DOMAIN
    • @simplicissimus
      Simplicissimus @simplicissimus 28/03/2025

      et tant qu’à faire (la moitié des ID du total, quand même)
      mais, sans grand intérêt car ça doit être plus ou moins directement lié au nombre de machines sur le réseau…
      (mais, chance !, le fond de carte des États du Brésil fait partie des quelques fonds d’exemple de Magrit ;-)

      https://pixelfed.zoo-logique.org/storage/m/_v2/493806419159965724/549719332-a3f277/FF1dmpnhV5CW/86Lh0J4EddX8DkILBUh9qo0C9Lx4FDDs4EYTAyCh.png

      Simplicissimus @simplicissimus
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 28/03/2025

      Ça répond à la question « est-ce que ce sont des connexions résidentielles ou bien des datacenters ? » Non pas qu’il ne puisse y avoir des datacenters au milieu de l’Amazonie, mais, qu’en plus ces datacenters proposent des VPS à la location, j’ai comme un doute.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 29/03/2025

      Hier vers 16h30, à nouveau, jusqu’à 19h30, hausse de la charge, et 10000 nouvelles IP bloquées.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 30/03/2025

      A nouveau : Hier vers 16h30, à nouveau, jusqu’à 19h30, hausse de la charge, et 10000 nouvelles IP bloquées.

      J’ai mis à jour, avant ces 10K nouvelles IP, le contenu de l’ipset.

      Je suis heureux de vous annoncer que nous avons dépassé les 500K IP.

            5 25
            5 26
           10 27
           43 28
          397 29
         3687 30
        34384 31
       417850 32

      Soit au total : 506510 adresses uniques.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 31/03/2025

      Hier, 16h30>19h30, +8000 IP.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 31/03/2025

      Ce jour, 18h>22h, +14K IP.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 2/04/2025

      Cette nuit, 17h-22h, +2400 IP seulement.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 3/04/2025
      NbCIDR  CIDR NbIP/CIDR  NbIP
      5       25   128        640
      5       26   64         320
      21      27   32         672
      103     28   16         1648
      574     29   8          4592
      4430    30   4          17720
      37985   31   2          75970
      441454  32   1          441454
                        TOTAL 543016
      BigGrizzly @biggrizzly CC BY-NC-SA
    • @simplicissimus
      Simplicissimus @simplicissimus 3/04/2025

      je ne suis pas sûr de comprendre ton tableau ; j’imagine que c’est lié à la gestion de l’adressage. J’ai jeté un œil sur ce que représente le CIDR (WP[en]) et je suis reparti en courant… En tous cas, je ne vois pas quel type d’information je pourrais y exploiter.

      questions :
      • disposes-tu d’un historique de l’arrivée des requêtes (nb de nouvelles IP collectées en f. du temps) avec une granularité pas trop grosse et régulière
      • as-tu fabriqué une version plus récente de ton fichier de botnet ?

      Simplicissimus @simplicissimus
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 3/04/2025

      /32 = 1 seule IP 0.0.0.0
      /31 = 2 IP 0.0.0.0 + 0.0.0.1
      /30 = 4 IP 0.0.0.0-3
      etc.
      Si j’écris 10.2.3.0/30, je désigne les 4 IP de .0 à .3
      Si j’écris 10.2.3.0/25 ; je désigne les 128 IP de .0 à .127

      J’ai copié les logs de fail2ban des 3 dernières semaines. Je tâche d’en extraire ce qui t’intéresse dans un format exploitable.

      J’ai un botnet-set à jour généré ce matin... Je vais le publier dans la journée.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 3/04/2025

      Voici un fichier avec l’ensemble des blocages, par date, heure et IP (/32).

      Il y a des IP qui vont apparaître plusieurs fois, parce que fail2ban plantait et recommençait à traiter les IP de zéro.

      ▻https://www.partagerfichier.fr/download.php?f=2025-04-03-17-47-11_blocages.log.gz

      Ça commence au 14 mars, vers 21h, quand j’ai mis en œuvre la règle de détection du botnet.
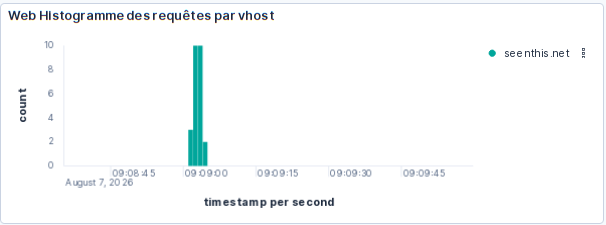
      BigGrizzly @biggrizzly CC BY-NC-SA
    • @simplicissimus
      Simplicissimus @simplicissimus 3/04/2025

      merci ! pas loin de 700 000 lignes
      pas sûr que je le traite tout de suite, j’ai une fin de semaine bien chargée

      Simplicissimus @simplicissimus
    • @b_b
      b_b @b_b PUBLIC DOMAIN 3/04/2025

      Même wikimedia a du mal à gérer le traffic généré par les bots de l’IA... «monde de merde»

      ▻https://next.ink/178942/les-crawlers-des-ia-deviennent-un-serieux-probleme-pour-le-web-meme-pour-wikim

      b_b @b_b PUBLIC DOMAIN
    • @simplicissimus
      Simplicissimus @simplicissimus 3/04/2025

      pfff… ça rame !
      je ne sais pas si c’est ST ou par chez moi, où le réseau est parfois bien pourri.

      pas facile de se retrouver entre les deux billets sur le sujet ; si en plus, tu supprimes tes messages ;- )

      comme dit plus haut, je ne suis pas très à l’aise avec les CIDR, mais oui, les /24, comme tu dis, sont ce que j’ai appelé les ID, il me semble que cela suffit pour assurer la correspondance des IP aux régions et c’est ça que j’ai cartographié.

      j’avais utilisé les /32 (IP complètes) sur l’autre fil pour voir si les machines étaient concentrées sur un serveur /24, en fait je comptais le nombre de d utilisés dans un a.b.c pour fabriquer la distribution ▻https://seenthis.net/messages/1105923#message1106100

      Simplicissimus @simplicissimus
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 4/04/2025

      La dernière liste d’IP bloquées est ici :
      ▻https://seenthis.net/messages/1105923#message1107718

      Ceci dit, la liste des blocages, les 700K lignes, est tout autant exhaustive.

      Pourquoi disais-tu que ça rame ? Le serveur est vraiment en confort ces jours-ci. La charge oscille entre 0,5 et 1,5, ce qui fait que même les bots peuvent tranquillement faire leur boulot sans se faire bloquer (dès que la charge dépasse 2, et qu’ils sont reconnus comme des bots, ils sont bloqués).

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 4/04/2025

      Je fais l’hypothèse qu’il s’agit d’un botnet, qui se diffuse sur des terminaux compromis. Aussi, il faudrait dans l’idéal que je libère les IP au fil du temps, pour confirmer que l’IP est toujours compromise... parce que les terminaux, si ça s’trouve, changent d’IP. Et dans un tel cas, bloquer les IP n’est pas bien fiable.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @simplicissimus
      Simplicissimus @simplicissimus 4/04/2025

      Pourquoi disais-tu que ça rame ?

      Apparemment, c’était chez moi.

      Simplicissimus @simplicissimus
    • @simplicissimus
      Simplicissimus @simplicissimus 4/04/2025

      peu de changement entre les deux situations
      les cartes sont pratiquement indistingables
      le Brésil garde la tête – de loin ! – mais n’augmente pas beaucoup
      derrière, l’ordre change un peu : forte progression de Russie et Turquie qui passent en 2 et 3
      les suivants, Argentine, Maroc et Mexique ne montent que peu.

      https://pixelfed.zoo-logique.org/storage/m/_v2/493806419159965724/6ac28a0f2-92b4f8/AFncmaaSOw4M/OpmIp0Jkvic4hPdZPcqeOiKTNZRzcl5qa7stU0dq.png

      (échelle log)

      Simplicissimus @simplicissimus
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 6/04/2025

      Le botnet s’est complété ce WE de quelques 300K IP supplémentaires.

      Ça a commencé vendredi à 18h. Et ça continue à plein régime encore maintenant. La règle de filtrage est toujours efficace, mais le firewall avec les 300K entrées individuelles a du mal à supporter la charge, aussi, les 300K entrées vont être transférées dans le botnet, et tout va rentrer dans l’ordre, au sens où la machine devrait travailler légèrement moins.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 6/04/2025

      Du coup, ça a ramené la charge de la machine au dessus de 2, ce qui est le moment où les bots (user agents reconnus comme tels) reçoivent des erreurs 429, et s’ils insistent, ils sont bloqués par fail2ban. Ces bots représentent au bout de 48 heures entre 950 et 1000 adresses IP seulement.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 6/04/2025

      A présent, donc :

            5 /25
           20 /26
           73 /27
          249 /28
         1634 /29
        10826 /30
        70278 /31
       641759 /32
      TOTAL : 846931
      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 7/04/2025

      +110K depuis hier soir, on s’approche du million.

      Je fais l’hypothèse que les terminaux compromis sont sur des connexions sans IP fixe, et que les baux sont en cours de renouvellement.

      Je fais aussi l’hypothèse que le botnet se répand, mais il ne semble pas être plus intelligent, il se répand donc à version identique, du fait qu’il continue à réclamer des ressources invalides.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 7/04/2025
            9 25
           30 26
          104 27
          373 28
         2277 29
        14332 30
        84805 31
       720765 32

      TOTAL : 978287

      On s’approche du million :-)

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 16/04/2025

      Tjs pas le million :-))

      984 462

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 22/04/2025

      La moisson du WE a été bonne. 20846 nouvelles IP attrapées par fail2ban. Nous devrions donc dépasser le million lors de la prochaine mise à jour de l’ipset :-)

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @arno
      ARNO* @arno ART LIBRE 22/04/2025

      Ça fait quand même un million de machines qui s’intéressent à ce qu’on publie sur Seenthis depuis un mois. C’est la gloire…

      ARNO* @arno ART LIBRE
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 22/04/2025

      Le million !

      1 005 342

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @b_b
      b_b @b_b PUBLIC DOMAIN 24/04/2025
      @biggrizzly

      Autre piste, merdification^x...

      What these companies then sell to their customers is network access through the devices/PCs that have an app with this SDK installed. They are proud to tell you how you can funnel your (AI) web scraping etc through millions of rotating, residential and mobile IP addresses. Exactly the pattern we see hitting our servers.

      ►https://jan.wildeboer.net/2025/04/Web-is-Broken-Botnet-Part-2

      @biggrizzly 1 million c’est pas grand chose au final...

      https://jan.wildeboer.net/images/2025/04/botnet02.png

      b_b @b_b PUBLIC DOMAIN
    • @touti
      vide @touti 24/04/2025

      #trombones_IA

      vide @touti
    • @b_b
      b_b @b_b PUBLIC DOMAIN 15/05/2025

      Toujours à propos des bots :

      As part of a time-limited trial, yesterday we removed the www.bbc.co.uk & www.bbc.com robots.txt “block” on one GenAI crawler.

      Here’s a graph of total daily requests from that 1 GenAI crawler by content-type. You’ll note, they’ve retrieved ~460k web pages in ~16 hours, so a mean of ~28,750 web pages per hour. They’ll likely pull ~690k pages today, ~32GB egress.

      Whilst this is a drop in the ocean versus our other traffic, I can easily see how this could sink a smaller website.

      https://files.mastodon.social/media_attachments/files/114/501/027/884/399/923/original/4ca482220ec2eeb6.png

      ▻https://mastodon.social/@tdp_org/114501075084619358

      b_b @b_b PUBLIC DOMAIN
    • @b_b
      b_b @b_b PUBLIC DOMAIN 3/06/2025

      Et encore..

      Ces robots agressifs tentent de parcourir des sites web entiers en peu de temps, ce qui surcharge nos serveurs web et a un impact négatif sur l’expérience des utilisateurs légitimes

      Nous bloquons désormais plus de 190 millions d’adresses IP signalées par mois, mais les tentatives d’autres robots pour visiter le site restent une menace existentielle pour la plateforme

      ▻https://next.ink/186593/les-crawlers-des-ia-menacent-les-sites-scientifiques

      b_b @b_b PUBLIC DOMAIN
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 15/07/2025

      On arrive donc à 1 171 134 adresses ipv4 distinctes.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @sombre
      Sombre @sombre CC BY-NC-SA 15/07/2025

      Retour d’expérience de ce matin 15/07 vers 06:23 UTC+2 : ça rame ...

      Sombre @sombre CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 15/07/2025

      On n’a plus la charge élevée, mais on a encore des groupes d’IP qui saturent les 30 à 40 connexions autorisées sur php-fpm, par instant.

      A ces moments précis, on peut en effet se retrouver bloqué quelques instants. Sur le graph ci-dessous, ce sont les barres rouges.

      https://pixelfed.zoo-logique.org/storage/m/_v2/493151427756716033/7a53dd069-05894d/YEoNE80qiBaV/tzN9rXUy4BQ6HXSkyDkpQSDJC9boKmbxKbrRio0r.png

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 15/07/2025

      Je découvre qu’il est possible d’interroger la recherche sans être connecté au moyen d’URL détournées.

      Exemple :
      https://seenthis.net/index.php?age=2025-04-07%2B00%3A07%3A28&debut_messages=7200&page=recherche&recherche=chine

      C’est ballot.

      C’est une des raisons pour laquelle on se retrouve à nouveau avec des blocages.

      (ne pas cliquer l’URL ci-dessus, vous risquez de vous faire bloquer l’IP)

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @b_b
      b_b @b_b PUBLIC DOMAIN 17/07/2025

      > Je découvre qu’il est possible d’interroger la recherche sans être connecté au moyen d’URL détournées.

      Bloquer les urls qui comportent page=recherche devrait faire le job, c’est possible de ton côté ?

      b_b @b_b PUBLIC DOMAIN
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 17/07/2025

      Alors, j’ai tenté de procéder via nginx, et j’ai cafouillé lamentablement sur les if de nginx et sa syntaxe pourrie et peu documentée. J’ai à coup sûr enquiquiné tout le monde...

      Je me suis rabattu sur PHP, en ajoutant les 3-4 lignes nécessaires dans mes_options.php. J’ignore si c’est le meilleur endroit, mais c’est là que j’ai procédé.

      Et instantanément, on a gagné en confort.

      Et instantanément, fail2ban alimente une nouvelle table de rejet. Pas des milliers d’IP, mais des IP pénibles assurément.
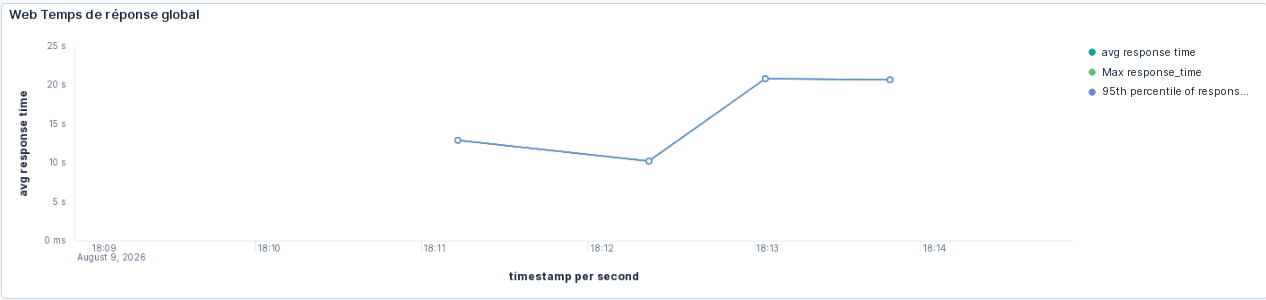
      BigGrizzly @biggrizzly CC BY-NC-SA
    • @pierrot
      pierrot @pierrot 3/10/2025

      Bonjour,

      Je découvre et lis avec intérêt ce fil car je me bat moi-même avec ce genre de souci ... Plusieurs questions/reflexions sur la base de mon travail. Je suis dans la situation de gérer une 30aine de serveurs et j’ai mis en place la chose suivante :

      – chaque serveur a fail2ban d’installé
      – chaque serveur (cron) m’envoie par email quotidiennement la liste des IP’s bloquées par fail2ban
      – je compile manuellement ces IP’s bloquées en une liste commune (une IP/ligne, notation cidr possible) qui est accessible sur un de mes serveurs (derrière un htpasswd)
      – sur chaque serveur un script (cron 4h) vient chercher cette liste et mets à jour un ipset dans firewalld, cette mise à jour est dynamique (retrait puis ajout des ip modifiées) ... la modif de l’ipset ne nécessite pas un redémarrage de firewalld, donc en gros dans un délai de 4h tous mes serveurs bloquent la même liste d’IP.

      Pour l’instant je mets la liste à jour manuellement, il est assez facile dans le digest de fail2ban de détecter les IP’s qui insistent lourdement (+ de 4 essais) et ça n’est qu’une 30aine de mails, ça me prend une 10aine de minutes ...

      Donc fail2ban intercepte ceux qui essayent, 24-48h plus tard les IPs que j’ai identifiées comme malfaisantes sont directement bloquées par le firewalld.

      Par contre j’ai utilisé une fois ou 2 des listes existantes et ça m’a posé souci, par ex. le blocage d’un /24 de Google qui a fait que certains sites n’étaient plus du tout indexés ce qui pose souci quand même, c’est un peu pour ça que j’essaye de ne lister que des IP réellement bloquées par fail2ban et je vérifie certaines adresses avec abuseIPdb, ce qui m’amène à une première question :

      – pour moi fail2ban bloque les IP qui ont tenté des connexions (SSH, Postfix, etc ...) donc clairement malfaisantes, mais j’ai l’impression à la lecture de ce fil que votre fail2ban bloque des bots qui en général (dans mon expérience) n’essayent pas de se connecter, ils explorent ... comment se fait-il que fail2ban bloque ces IP de bots ?

      – mon fichier fait moins de 1000 lignes mais bloque plusieurs millions d’adresses, notation cidr oblige, quand par ex. je commence à avoir 20 lignes qui commencent par xxx.yyy je recherche a qui appartient ce bloc et je le bloque en entier, par ex hier j’ai bloqué 57.128.0.0/9 du DOD américain (j’avais des attaques d’IP leur appartenant), 8 millions d’adresses d’un coup. ... vous dites que votre serveur est vieux mais je suis surpris qu’iptables tienne le coup avec un fichier de plus de 1 million de lignes, c’est bien ce que vous dites ou s’agit-il d’un million d’adresses ? Quelles ont les caractéristiques de ce « vieux » serveur ?

      Merci en tous cas pour toutes ces infos intéressantes !

      pierrot @pierrot
    • @biggrizzly
      BigGrizzly @biggrizzly CC BY-NC-SA 3/10/2025

      Je tâche de répondre à toutes les questions. Pas de souci pour être relancé évidemment.

      – fail2ban permet de créer des règles de filtrage sur mesure. C’est ce que je fais, je crée des jails sur mesure en fonction de ce que j’ai identifié dans les logs comme comportements suspects ou comme code http significatif. Par exemple, si SPIP ou NGINX renvoient une erreur http 444, ça active une jail qui surveille les codes http dans les logs Apache. Il suffit de demander à SPIP ou NGINX de renvoyer un tel code.
      – Il s’agit de 1 millions d’adresses /32, mais qui sont regroupées par CIDR pour n’en former à la fin qu’un nombre inférieur, charge à l’IPset de se débrouiller.
      – J’évite désormais de regrouper par CIDR à la sauvage, on a eu des mauvaises surprises parfois avec certains blocs partagés entre plusieurs pays, et plusieurs propriétaires... on bloquait des vrais visiteurs légitimes.
      – Le serveur est vieux parce qu’il tourne en jessie ; mais c’est une machine virtuelle qui tourne sur un proxmox à jour, en nvme, et tout le toutim, c’est très très très rapide :-) Le fait qu’il soit en jessie (oldoldoldoldoldstable je crois) nous empêche surtout des intégrations avec des outils de journalisation modernes... par exemple.

      Encore aujourd’hui, 4 à 5% de temps processeur utilisé par le noyau, par le firewall, donc.

      BigGrizzly @biggrizzly CC BY-NC-SA
    • @pierrot
      pierrot @pierrot 3/10/2025

      Ok merci pour ces infos !

      pierrot @pierrot
    • @b_b
      b_b @b_b PUBLIC DOMAIN 29/01/2026

      Et ça continue, cette fois c’est les techs de chez osm qui ramassent :

      To keep #OpenStreetMap.org up and running while we’re being deluged by scrapers, we’ve blocked 320,000+ primarily residential IPv4 addresses in the last 24 hours (+ 100,000 IPv6) involved in scraping.

      ▻https://mastodon.roflcopter.fr/@osm_tech@en.osm.town/115973941650213561

      b_b @b_b PUBLIC DOMAIN
    Écrire un commentaire