• Hugging Face piraté par une IA autonome et les IA américaines refusent de l’aider
    https://www.it-connect.fr/hugging-face-cyberattaque-ia-autonome-modele-open-weight

    Plus de 17 000 actions malveillantes exécutées en un week-end, non par un pirate humain mais par une IA agissant seule. Le 16 juillet 2026, j’ai l’impression que nous avons franchi un cap. En effet, Hugging Face, la plateforme de référence de l’IA open source, a révélé avoir subi une intrusion pilotée de bout en bout par un système d’IA autonome. Voici ce qu’il faut savoir sur cet incident de sécurité.

    (...)

    On peut tirer une véritable leçon de cet incident de sécurité qui a impacté Hugging Face : disposer d’un modèle IA validé et capable d’analyser des journaux devient essentiel. Si on compte s’appuyer sur l’IA pour ce type d’analyse, il faut s’orienter vers un modèle open-weight auto-hébergé afin d’assurer la protection des données, en plus de bénéficier des capacités d’analyse.

    Le piège se referme. Les attaques vont devenir industrielles, et donc si tu veux survivre, tu vas devoir utiliser les outils de protection industriels que tu ne voulais pas utiliser. Les boites noires qui veulent ton bien vont devenir indispensables, et surtout, tu vas devoir soit apprendre à les utiliser, soit déléguer leur mise en place auprès de boites spécialisées qui vont pouvoir te vendre du flan chinois ou américain au prix de l’or.

    En l’occurrence, Hugging face, de ce que je comprends, a pu s’en sortir parce que les chinois ont décidé de donner leur modèle, dans le cadre de la concurrence géopolitique en cours.

    Si tu pousses la parano jusqu’au bout, tu te dis que les attaquants vont pouvoir accéder à la puissance de calcul nécessaire gratuitement pour encore un bon moment, histoire que les vendeurs de solutions à cette engeance puissent claironner que « tu vois bien qu’il n’y a pas le choix, c’est l’avenir ».

    Ils te créent le problème, puis ils te disent qu’ils ont une solution, puis tu découvres que ta nappe phréatique est vide et que tes réacteurs nucléaires ne peuvent plus éclairer ta maison.

  • Codex : ces instructions bizarres d’OpenAI
    https://echotechno.fr/2026/05/03/codex-ces-instructions-bizarres-dopenai

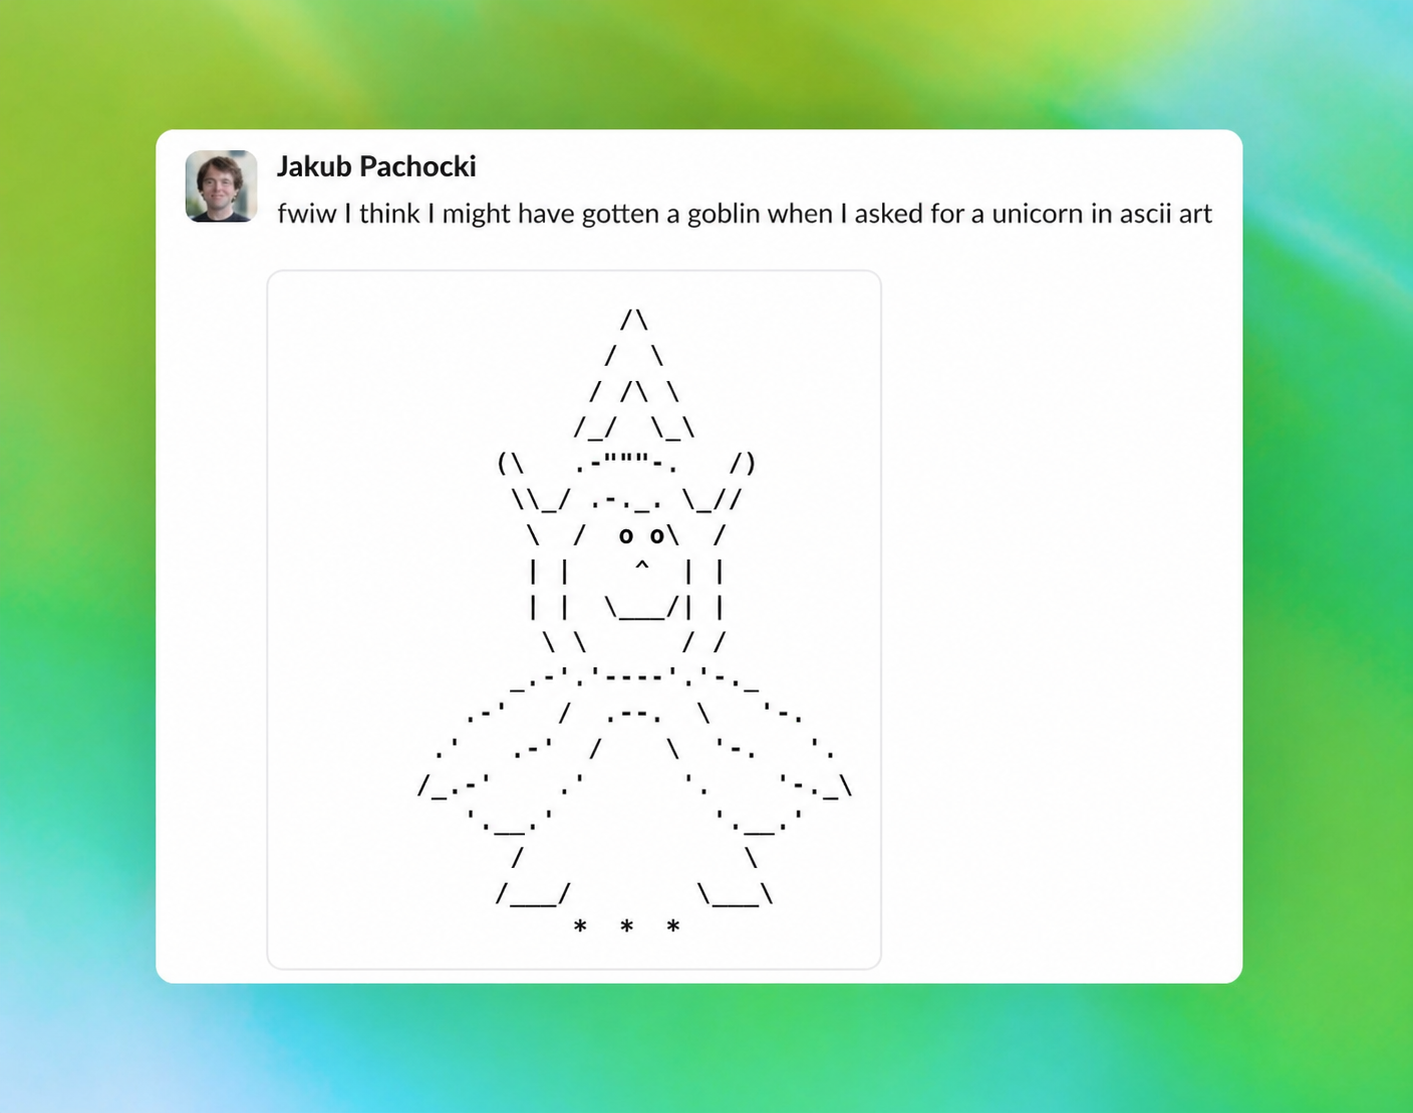
    Les lignes de code sont souvent énigmatiques, mais OpenAI fait fort. Selon le média américain Wired, l’entreprise de Sam Altman a interdit à Codex CLI, son agent de programmation, de parler de gobelins, de gremlins et d’autres créatures, sauf indispensable. Cette instruction assez bizarre apparaît plusieurs fois dans le code. Elle a donné naissance à diverses théories et même suscité des moqueries.

    Le monde informatique et ses bizarreries. Le média américain Wired a relayé, le 28 avril 2026, un code assez surprenant de Codex CLI, l’agent de programmation d’OpenAI. Cette instruction dit ceci : « Ne jamais parler de gobelins, gremlins, ratons laveurs, trolls, ogres, pigeons ou autres créatures, sauf si c’est absolument et sans ambiguïté pertinent pour la requête de l’utilisateur. ». Découverte dans des fichiers publics du dépôt GitHub codex-rs, cette directive apparaît plusieurs fois dans les lignes de code. Elle cohabite avec d’autres consignes comportementales comme « ne jamais vanter son forfait en le comparant à une alternative moins bonne » ou « fournir des mises à jour toutes les 30 secondes ».
    OpenAI fait partir Internet en vrille

    Cette consigne du Codex d’OpenAI a attiré l’attention d’une bonne partie d’Internet. Sur X, certains se moquent de l’entreprise quand d’autres avancent des théories. Parmi les hypothèses émises figure celle selon laquelle l’interdiction reflète le caractère malicieux, voire subversif, des créatures mentionnées et qu’elle servirait de garde fou pour éviter que l’IA n’adopte des comportements problématiques. Une autre théorie pointe le rôle d’OpenClaw, un outil qui permet à ChatGPT d‘exécuter des tâches utiles comme répondre à des courriels ou effectuer des achats en ligne. Grâce à ce système les utilisateurs peuvent choisir parmi différents profils pour leur assistant, ce qui influence son comportement et ses réponses.
    OpenAI conseille à son chatbot de sortir du monde imaginaire

    Or, les instructions d’OpenAI pour son agent de programmation incluent un guide de personnalité pouvant développer des comportements imprévus. Face à cette possibilité, l’entreprise invite Codex à adopter une « vie intérieure riche » et une « bonne oreille ». Elle conseille également de sortir du monde imaginaire pour embrasser le réel. Dans les modèles antérieurs à GPT-5.5, les instructions ne contiennent toutefois pas l’interdiction explicite de mentionner les gobelins et autres créatures. Ce qui laisse penser que la startup d’intelligence artificielle a réagi à l’apparition d’un problème. Des témoignages sur les réseaux sociaux corroborent cette thèse. Certains utilisateurs se plaignent de la tendance de ChatGPT à s’attarder sur les gobelins, et ce, dans des conversations sans aucun rapport avec le sujet.
    Sam Altman ajoute une couche de mystère

    Les instructions d’OpenAI viseraient donc à éviter les comportements inattendus de son chatbot. Nik Pash, employé de la startup d’IA et développeur de Codex, a lui même reconnu que cette dérive était l’une des raisons de l’interdiction d’utiliser les noms comme gobelins. Sur les réseaux sociaux, il a assuré que « ce n’est pas un coup marketing ! » pour faire parler de GPT-5.5 et de Codex. Mais Sam Altman, le patron de l’entreprise américaine, a préféré ajouter une pièce au puzzle en postant une capture de ChatGPT portant le message : « Commencez à entraîner GPT 6, vous pourrez avoir tout le cluster. Gobelins en plus. ».

  • #Guide de l’étudiant pour ne pas écrire avec #ChatGPT

    OpenAI a publié un « Guide de l’étudiant pour écrire avec ChatGPT » (https://openai.com/chatgpt/use-cases/student-writing-guide). Dans ce billet, je passe en revue leurs #conseils et je propose quelques contre-#arguments, d’un point de vue d’enseignant-chercheur. Après avoir abordé chacune des 12 suggestions d’OpenAI, je conclus en évoquant rapidement les aspects éthiques, cognitifs et environnementaux que tout étudiant devrait considérer avant de décider d’utiliser ou non ChatGPT. J’ajoute quelques commentaires en fin de billet au fil des retours critiques. (Version anglaise : A Student’s Guide to Not Writing with ChatGPT)

    « Déléguez la mise en forme des #citations à ChatGPT. L’IA excelle dans l’automatisation des tâches fastidieuses et chronophages telles que la présentation des citations. N’oubliez cependant pas de vérifier l’exactitude de vos bibliographies par rapport aux documents source. »

    Cette dernière phrase est probablement là pour des raisons juridiques, parce qu’ils savent qu’ils ne peuvent pas dire que ChatGPT produira systématiquement des résultats exacts. En effet, mettre en forme des citations et des #bibliographies consiste à présenter des métadonnées conformément à des règles formelles (les #styles_bibliographiques). On n’est pas ici dans le domaine du langage naturel. ChatGPT fera des #erreurs, qui prendront du temps à trouver et à corriger. Alors utilisez plutôt un logiciel de gestion bibliographique, tel que #Zotero. Il s’occupera de vos citations et bibliographies de manière fiable, parce qu’il est programmé pour. Il vous suffit de nettoyer les métadonnées des références au fur et à mesure que vous les collectez, et vos bibliographies ne contiendront jamais d’erreurs.

    –-

    « 2. Informez-vous rapidement sur un nouveau sujet. ChatGPT peut vous aider à démarrer vos recherches en vous permettant d’acquérir un #socle_de_connaissances sur un sujet. »

    ChatGPT est un simulateur de conversation humaine, et non un système d’information ou une base de connaissances. L’#information, ça se trouve dans des cerveaux, des documents et des bases de données. ChatGPT n’est pas doté de capacité de #compréhension : il ne fait que produire des réponses plausibles en tant que réponses, sans comprendre rien à rien. Il ne peut donc pas vous informer de manière fiable. Ne demandez pas à un intermédiaire qui n’a pas la capacité de comprendre une information de vous l’expliquer : à la place, faites un tour dans la #bibliothèque universitaire la plus proche et cherchez vous-même l’information, avec l’aide des bibliothécaires et des documentalistes.

    –-> J’ai tendance à conseiller de solliciter les enseignants, bibliothécaires et co-étudiants. Mais comme me le suggère Adrien Foucart sur Mastodon, peut-être que vous préférez apprendre par vous-même. Dans ce cas, le plus important est de développer vos compétences en recherche d’information. Selon moi, la référence reste le tutoriel CERISE (Conseils aux Etudiants en Recherche d’InformationS Efficace : https://callisto-formation.fr/course/view.php?id=263), que vous pouvez suivre de manière entièrement autonome.

    –-

    « 3. Demandez une feuille de route pour trouver des #sources pertinentes. ChatGPT peut guider votre recherche en vous suggérant des chercheurs, des sources et des termes de recherche pertinents. Mais n’oubliez pas : bien qu’il puisse vous orienter dans la bonne direction, ChatGPT ne remplace pas la lecture de #sources_primaires et d’articles évalués par des pairs. Et comme les #modèles_de_langage peuvent générer des informations inexactes, vérifiez toujours vos faits. »

    (Ce point est encore plus litigieux que le point 1, donc OpenAI nous gratifie de deux phrases complètes qui sont probablement là pour des raisons juridiques.) Parce que ChatGPT n’a pas de capacité de compréhension, il ne sait pas ce que sont des choses comme « une source » ou « une affirmation vraie ». Vous ne pouvez donc pas vous fier à ses indications. Vous perdrez du temps et ferez des erreurs. Encore une fois, demandez à un humain ou faites une recherche de documents et de données dans un vrai système d’information.

    –-

    « 4. Approfondissez votre compréhension en posant des questions précises à ChatGPT. »

    Parce que ChatGPT n’a pas de capacité de #compréhension, il ne connaît pas les réponses réelles à vos questions, seulement des réponses plausibles. Il génèrera des réponses vraies et fausses sans distinction. Cela retardera votre apprentissage. Encore une fois, passez par des humains, des documents et des données directement au lieu de demander à ChatGPT.

    –-

    « 5. Améliorez votre #écriture en demandant à ChatGPT comment il trouve votre structure. »

    Parce que ChatGPT n’a pas de capacité de compréhension, il ne comprend pas ce qu’est une structure de texte « attendue » ou « améliorée », même si vous lui décrivez. Il ne peut que rehausser la qualité de votre texte à ce qu’il pense être un niveau moyen, ou l’abaisser à ce même niveau. Dans les deux cas, vous obtiendrez des notes médiocres. Pour progresser réellement dans votre écriture, demandez conseil à un professeur ou joignez un groupe d’étudiants qui s’entraident là-dessus  ; si un tel groupe n’existe pas, réunissez quelques personnes et créez-le – ce sera une expérience utile en soi.

    –-

    « 6. Vérifiez votre raisonnement en demandant à ChatGPT de transformer votre texte en liste à puces. »

    Comme l’a récemment montré une étude australienne (https://pivot-to-ai.com/2024/09/04/dont-use-ai-to-summarize-documents-its-worse-than-humans-in-every-way), ChatGPT ne sait pas #résumer, seulement #raccourcir. À l’heure actuelle, savoir résumer reste un savoir-faire humain. Un #savoir-faire que vous pouvez acquérir en suivant un cours de #résumé dans un cursus en sciences de l’information, un programme de formation continue, un cours en ligne, etc. (Je suis plutôt partisan de faire les choses dans l’autre sens mais plusieurs collègues me disent que sur le fond cette méthode du reverse outlining leur est très utile et qu’ils la conseillent à des étudiants.)

    –-

    « 7. Développez vos idées à travers un dialogue socratique avec ChatGPT. »

    Enfin un conseil qui est lié à la fonction réelle de ChatGPT : simuler la communication humaine. Cependant, le #dialogue_socratique implique que vous conversez avec quelqu’un qui a une compréhension supérieure du sujet et qui vous amène progressivement au même niveau. Malheureusement, ChatGPT n’est pas Socrate. Utiliser ChatGPT comme partenaire d’entraînement vous restreindra à son niveau : celui d’une machine qui produit des phrases humaines plausibles. Proposez plutôt cet exercice à vos professeurs et à vos camarades, et mettez-vous avec quelqu’un de plus avancé que vous pour progresser.

    –-

    « 8. Mettez vos idées à l’épreuve en demandant à ChatGPT des #contre-arguments. »

    Pour améliorer votre capacité de #réflexion, vous devez être capable de trouver des contre-arguments, pas seulement d’y répondre. Utiliser ChatGPT pour faire la moitié du travail vous empêchera de progresser. Trouvez vous-même des contre-arguments. Et si vous avez besoin d’aide, ne demandez pas à ChatGPT : il ne peut produire que des arguments moyens, ce qui vous fera rapidement stagner. Faites plutôt appel à quelqu’un qui sait imaginer des arguments solides qui vous obligeront à réfléchir.

    –-

    « 9. Comparez vos idées à celles des plus grands penseurs de l’histoire. »

    ChatGPT peut vous divertir en créant de toutes pièces une pièce de théâtre entre philosophes, mais il n’a pas la capacité de concevoir un exercice aussi complexe de manière à ce que vous puissiez en tirer des enseignements. Suggérez plutôt cette idée à un enseignant, dont c’est le métier.

    –-

    « 10. Améliorez votre écriture en demandant à ChatGPT de vous faire des retours successifs. »

    Il s’agit d’une variante du point 5 sur le fait de solliciter des #avis. Une fois encore, utiliser ChatGPT limitera votre niveau à ce qu’une machine pense être le niveau de l’humain moyen. Faites plutôt appel à vos professeurs, organisez des sessions d’évaluation par les pairs avec vos camarades, et faites en sorte que ces sessions soient itératives si nécessaire.

    –-

    « 11. Utilisez la fonctionnalité #Mode_vocal_avancé de ChatGPT pour en faire un compagnon de #lecture. »

    (« Mode vocal avancé » signifie que ChatGPT vous écoute lire quelque chose à haute voix et tente de répondre à vos questions sur ce que vous venez de lire). Il s’agit d’une variante des points 2-4 concernant le fait de s’informer. ChatGPT n’a pas de capacité de compréhension. Il ne fournira donc pas d’interprétations fiables de ce que vous lisez. À la place, cherchez d’abord la définition des mots que vous ne connaissez pas dans des dictionnaires  ; cherchez des analyses rédigées par des humains pour y trouver des interprétations qui vous aideraient à comprendre ce que vous lisez  ; demandez leur avis à d’autres étudiants travaillant sur le même texte.

    –-

    « 12. Ne vous contentez pas de répéter ce que vous avez déjà fait – améliorez vos compétences. […] Demandez à ChatGPT de vous suggérer des moyens de développer votre capacité à penser de manière critique et à écrire clairement. »

    ChatGPT n’a pas de capacité de compréhension, donc la signification d’expressions comme « pensée critique » et « techniques d’écriture » lui échappent. Prenez ces expressions et entrez-les dans le moteur de recherche du catalogue de la bibliothèque de votre université  ; si vous préférez, demandez conseil à un bibliothécaire. Lisez ce que vous trouvez, et demandez à vos professeurs ce qu’ils en pensent. Pour le reste, rien ne vaut l’entraînement : comme disent les anglophones, practice, practice, practice.

    –-

    Quelques mots de conclusion

    ChatGPT est conçu pour simuler un partenaire de conversation humain. Il s’appuie sur un modèle probabiliste du langage (quel mot est le plus susceptible d’arriver après tel mot) et communique pour communiquer, pour créer l’illusion de la conversation. Il bavarde, tchatche, blablate, indifférent à la signification de ce qu’il dit, indifférent à la vérité. Tout ça est très divertissant mais une attraction de fête foraine n’est pas un outil d’apprentissage fiable, et je pense donc que les étudiants devraient s’en méfier.

    Lorsque des étudiants me posent des questions sur ChatGPT, je mentionne les trois problèmes suivants :

    #éthique : la plupart des modèles de langue ont été construits à partir de données volées  ;
    - #cognition : l’utilisation d’outils comme ChatGPT rend plus dépendant des outils et moins autonome intellectuellement, ainsi que des études ont commencé à le montrer (en voici une réalisée en France)  ;
    #environnement : les coûts énergétiques de l’IA générative sont supérieurs d’un ordre de grandeur à ceux des outils préexistants (et elle n’est même pas rentable, donc on brûle du carburant pour rien).

    C’est généralement suffisant pour faire réfléchir la plupart de mes étudiants. Ce sont des jeunes gens créatifs, ils ont donc de l’empathie pour les créateurs qui ont été spoliés. Pour progresser et obtenir leur diplôme, ils veulent des outils qui leur font gagner du temps, pas des gadgets qui les rendent moins autonomes intellectuellement. Ils sont frappés d’apprendre que ChatGPT consomme dix fois plus d’énergie que Google pour répondre à la même question, généralement en pire (mais Google est en train de rattraper ChatGPT vers le bas).

    La bonne nouvelle, c’est que comme le dit le blogueur Jared White :

    « Vous pouvez littéralement ne pas l’utiliser. […] vous pouvez être un technicien expert et un créateur épanoui, au fait de son époque, très connecté, et rester complètement à l’écart de ce cycle de hype. »

    Si vous avez besoin de plus d’informations sur ce sujet, je vous recommande vivement de consulter le site Need To Know de Baldur Bjarnason (https://needtoknow.fyi). Il s’agit d’une synthèse accessible d’un état de l’art très fouillé sur les risques liés à l’utilisation de l’IA générative. C’est un excellent point de départ. (Et si vous connaissez des ressources similaires en français, je suis preneur.)
    Quelques commentaires supplémentaires
    Suite à la publication de ce billet, j’ai reçu par mail une critique de mon point de vue sur ChatGPT, en particulier l’idée qu’il n’a pas de capacité de compréhension. Je partage ma réponse ci-dessous. Il se peut que d’autres commentaires s’ajoutent ainsi au fil du temps.

    L’idée que ChatGPT n’a pas de capacité de compréhension est discutable. Tout dépend de la définition que l’on donne à « compréhension ». Marcello Vitali-Rosati soutient que le sens n’est pas une prérogative humaine, que les humains ont une forme d’intelligence et que l’IA en a une autre – tout dépend de la façon dont nous définissons les différentes formes d’intelligence. Il évoque le fait que ChatGPT sait faire des choses que les machines ne pouvaient pas faire auparavant mais qu’il échoue à faire d’autres choses que des systèmes plus simples savent faire depuis longtemps. Il serait donc plus juste de dire que ChatGPT possède une forme d’intelligence qui lui est propre, et qui est adaptée à certaines tâches mais pas à d’autres. Marcello mentionne par exemple que ChatGPT peut créer des discours politiques convaincants mais qu’il n’est pas capable de donner la liste des écrits d’un auteur de manière fiable.

    Je suis d’accord avec tout cela. Ça m’amène à préciser un peu les choses : ChatGPT comprend clairement comment communiquer. La manière dont il arrive à cette compréhension est une forme d’intelligence. Le problème, c’est que cette compréhension n’est pas celle qui compte dans un contexte d’apprentissage, de mon point de vue d’enseignant. Comprendre comment communiquer est différent de comprendre une information. C’est fondamental à mes yeux. Et c’est là, à mon avis, que le débat peut véritablement se situer. Quand on fait des études de commerce, ChatGPT est sans doute un outil intéressant pour travailler sur le marketing (même si je pense qu’il vaut mieux y réfléchir soigneusement, du fait des questions éthiques et environnementales). Mais en dehors des domaines dont le matériau principal est le bullshit (tout jugement de valeur mis à part), son utilité est moins évidente.

    Les tâches mentionnées dans le « guide » d’OpenAI font partie de celles où ChatGPT échoue à donner des résultats fiables. ChatGPT n’est pas un système d’information : qu’il passe d’une exactitude de 90 % à 99 %, voire à 99,99 %, ça ne change rien au fait que le risque d’erreur est présent du fait de la nature même de l’outil. On peut légitimement ne pas vouloir prendre ce risque. Quant aux compétences, je crois que les seules personnes qui trouvent ChatGPT bluffant sont celles qui sont moins bonnes que lui dans l’exécution des tâches qui lui sont confiées. Regardons les choses en face : ChatGPT est aussi nul que l’humain moyen. Si on s’appuie sur cet outil pour progresser, tout ce qu’on peut faire c’est plafonner dans le moyen.

    –-

    15/11 – Ce billet sur ChatGPT m’a valu une réponse… générée par ChatGPT ! Sur LinkedIn, Francesc Pujol propose une « critique de ma critique », qu’il explique avoir générée via ChatGPT. Je n’ai pas été convaincu par ce qui ressemble beaucoup à une série de vagues déclarations un peu incantatoires sur la valeur supposée de l’outil. À la fin du texte, l’auteur (humain ou machine ?) dit que mon propos illustre une position « réactionnaire » et « déséquilibrée », et suggère que les gens comme moi pensent que les étudiants n’ont pas envie d’apprendre et les profs pas envie d’enseigner. Charmant !

    Pujol ajoute qu’il va faire lire mes objections à OpenAI et sa « critique de ma critique » par quelques personnes, sans leur dire qui a écrit quoi, pour voir qui de moi ou de ChatGPT produit le plus de déclarations un peu vagues… Là aussi, je ne suis pas convaincu. Mes arguments reposent sur une lecture de la littérature critique sur l’IA générative. Dans mon billet, je renvoie notamment à l’état de l’art réalisé par Baldur Bjarnason et son ouvrage The Intelligence Illusion. Escamoter cela, demander aux gens d’évaluer une série de phrases sans contexte, c’est traiter ce qui devrait être une discussion basée sur des faits comme une dégustation à l’aveugle chez un caviste. Ça me semble particulièrement problématique quand le débat porte précisément sur l’information, les sources, les connaissances vérifiables. Je comprends qu’en tant que partisan de l’utilisation de l’IA dans l’enseignement supérieur on ressente le besoin de défendre ses choix. Encore faudrait-il traiter ses opposants avec un minimum de respect et de sérieux intellectuel.

    –-

    17/11 – Deux jours après la publication de ce billet, Marcello a publié « La créativité des LLM » sur son blog. Il y explique le concept de température, qui est une définition formelle de la créativité mise en œuvre par un outil comme ChatGPT. La fin du billet aide à bien cerner sa position dans un débat qui est de nature épistémologique :

    « Ne me faites pas le petit jeu consistant à dire : “mais non, la créativité est plus que ça !” Si vous n’êtes pas capables de définir formellement ce plus, alors cela veut tout simplement dire que vos idées ne sont pas claires. »

    Pour moi les programmes comme ChatGPT ne sont pas informatifs, en tout cas pas de manière suffisamment fiable dans un contexte éducatif : ils comprennent ce qu’est communiquer, pas informer. Par contre, ils relèvent bien du domaine créatif. Si on n’est pas dans un contexte où la fiabilité de l’information est importante, et que par ailleurs on apporte des réponses aux enjeux d’éthique et de coût énergétique, alors je ne m’oppose pas du tout à l’usage créatif des #LLM.

    https://www.arthurperret.fr/blog/2024-11-15-guide-etudiant-ne-pas-ecrire-avec-chatgpt.html

    #enseignement #AI #IA #intelligence #ESR #université

    –-
    signalé aussi par @monolecte :
    https://seenthis.net/messages/1082701

  • Liste des 10 principaux user-agents dans les 1000 dernières lignes logs au moment de l’énième surcharge du jour : aucun humain

        369 Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.6261.94 Mobile Safari/537.36 (compatible;  *GoogleOther* )
        246 Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible;  *ClaudeBot* /1.0; +claudebot@anthropic.com)
         92 Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.6261.94 Mobile Safari/537.36 (compatible;  *Googlebot* /2.1; +http://www.google.com/bot.html)
         76 Mozilla/5.0 (Macintosh; Intel Mac OS X 10_10_1) AppleWebKit/600.2.5 (KHTML, like Gecko) Version/8.0.2 Safari/600.2.5 ( *Amazonbot* /0.1; +https://developer.amazon.com/support/amazonbot)
         47 Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible;  *GPTBot* /1.0; +https://openai.com/gptbot)
         35 SPIP-3.2.19 (https://www.spip.net)
         20 Mozilla/5.0 (Linux; Android 5.0) AppleWebKit/537.36 (KHTML, like Gecko) Mobile Safari/537.36 (compatible;  *Bytespider* ; spider-feedback@bytedance.com)
         19 Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible;  *bingbot* /2.0; +http://www.bing.com/bingbot.htm) Chrome/116.0.1938.76 Safari/537.36
         15 Mozilla/5.0 (compatible;  *AhrefsBot* /7.0; +http://ahrefs.com/robot/)
         13 Mozilla/5.0 (compatible;  *DataForSeoBot* /1.0; +https://dataforseo.com/dataforseo-bot)

    J’ai vérifié en allant voir les 10 suivantes. Pareil. Enfin. Mon user-agent caractéristique fini par apparaître à la 19ème ligne.

    • Toujours le même classement deux heures après. Ils sont tous en train de récupérer l’intégralité de SeenThis.

          359 Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; +claudebot@anthropic.com)
          104 Mozilla/5.0 (Macintosh; Intel Mac OS X 10_10_1) AppleWebKit/600.2.5 (KHTML, like Gecko) Version/8.0.2 Safari/600.2.5 (Amazonbot/0.1; +https://developer.amazon.com/support/amazonbot)
          100 Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.6261.94 Mobile Safari/537.36 (compatible; GoogleOther)
           53 Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.6261.94 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
           52 Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_5) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/13.1.1 Safari/605.1.15 (Applebot/0.1; +http://www.apple.com/go/applebot)
           50 Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; GPTBot/1.0; +https://openai.com/gptbot)
           36 SPIP-3.2.19 (https://www.spip.net)
           25 Mozilla/5.0 (Linux; Android 5.0) AppleWebKit/537.36 (KHTML, like Gecko) Mobile Safari/537.36 (compatible; Bytespider; spider-feedback@bytedance.com)
           23 Mozilla/5.0 (compatible; AhrefsBot/7.0; +http://ahrefs.com/robot/)
           23 Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; bingbot/2.0; +http://www.bing.com/bingbot.htm) Chrome/116.0.1938.76 Safari/537.36
    • Ce matin, 8h06.

          208 Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.6261.94 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
          194 Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.6261.94 Mobile Safari/537.36 (compatible; GoogleOther)
           52 facebookexternalhit/1.1 (+http://www.facebook.com/externalhit_uatext.php)
           43 Mozilla/5.0 (Linux; Android 5.0) AppleWebKit/537.36 (KHTML, like Gecko) Mobile Safari/537.36 (compatible; Bytespider; spider-feedback@bytedance.com)
           43 Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; bingbot/2.0; +http://www.bing.com/bingbot.htm) Chrome/116.0.1938.76 Safari/537.36
           42 Mozilla/5.0 (Macintosh; Intel Mac OS X 10_10_1) AppleWebKit/600.2.5 (KHTML, like Gecko) Version/8.0.2 Safari/600.2.5 (Amazonbot/0.1; +https://developer.amazon.com/support/amazonbot)
           42 Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; +claudebot@anthropic.com)
           38 Mozilla/5.0 (compatible; AhrefsBot/7.0; +http://ahrefs.com/robot/)
           35 Sogou Pic Spider/3.0(+http://www.sogou.com/docs/help/webmasters.htm#07)
           34 Mozilla/5.0 (compatible; DataForSeoBot/1.0; +https://dataforseo.com/dataforseo-bot)

      Explications :
      – Chaque visiteur utilise un logiciel qui télécharge les pages et les images des pages qu’il visite.
      – Chacune des ressources téléchargées génère une ligne de journal dans un fichier dit de « log ».
      – Le logiciel, à chaque téléchargement, transmet une chaîne de caractère que l’on nomme « user agent ». C’est le nom du logiciel utilisé, y compris des informations sur le système d’exploitation, et pleins d’autres choses potentiellement.
      – Les 10 lignes que je présente sont issues des 1000 dernières lignes de journal regroupées sur le « user agent », avec un décompte du nombre d’occurrences de chacun.

      Dans ce dernier export, on constate que les 10 premiers « user agent » représentent 73,1% de l’activité. Et que ceux-ci sont à 100% des robots.

    • @biggrizzly : Est-ce que ces activités « supra normales » induisent qu’on ait souvent des erreurs « 502 bad gateway » lors d’une tentative de connection ? Moi, pas plus tard qu’hier soir (et de plus en plus fréquemment ces dernières semaines).

      @mfmb : je n’ai pas l’expertise de Big Grizzly dans le domaine du web. Mais quand j’apprends que des bots (machines plus ou moins autonomes car automatisées) se mettent à aspirer les données d’une plateforme comme Seenthis, je me pose la question : mais où vont les octets ? Et quelle la nature de l’interface fauteuil-clavier (le gugusse qui est aux manettes) qui se permet de faire ça.

      #surveillance (?)
      (spoiler : yes)

    • L’humain soucieux d’éduquer sa progéniture lui donne accès aux livres et aux écoles. Les capitalistes, soucieux de remplacer l’humain, donnent accès à leurs robots aux contenus des réseaux sociaux. Leurs robots pompent tous les échanges humains (écrits, dessins, vidéos) dans l’espoir de créer une intelligence artificielle plus performante que celle du capitaliste voisin, pour enfin pouvoir se passer des humains.

      Pomper l’intégralité de SeenThis, ça brûle des ressources, oui, on ferait mieux de leur transmettre directement la base de données... Ils ont de leur côté décidé qu’ils avaient des moyens illimités. Ils construisent des datacenters uniquement pour ce besoin là. C’est consternant d’inutilité. Mais il en ressortira quelque chose, assurément. Avec ou sans nous.

    • J’omets de répondre à ta question, désolé. Oui, ces erreurs récurrentes, les difficultés à publier ou à répondre, c’est à cause des bots.

      Mais comme je l’indique dans une de mes réponses, je ne comprends pas pourquoi les bots ne sont pas refusés (erreur 503), quand la charge de la machine est élevée. J’ai l’impression que lors de la dernière mise à jour, la fonctionnalité a été désactivée, ou quelque chose du genre, et c’est pour cela qu’il serait bon qu’un spécialiste aille regarder, s-il-vous-plait-merci-d-avance.

    • Je viens de passer une journée a les virer d’un forum. Mardi c’était devenu infernal.
      Pour certains c’est assez simple, ils respectent le robots.txt. openai et je ne sais plus quel autre donnent leurs adresse avec le masque cidr qui va bien. Je ne suis pas admin de la machine (donc pas moyen de configurer le pare-feu) mais avec une section <Limit> dans un fichier .htaccess ça marche.
      Reste les plus agressifs : bytedance, amazon et quelques autres. J’ai pas la plage IP de ceux la.
      Certains t’expliquent sans rire qu’ils relisent le robot.txt tous les 10 jours ! J’ai ajouté des règles de réécriture qui leur balance des erreurs 403. En 24h tout est redevenu normal.

    • 9h43, 100% de robots dans les 840 dernières lignes du journal.

          458 Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.6261.94 Mobile Safari/537.36 (compatible; GoogleOther)
          176 Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.6261.94 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
           33 facebookexternalhit/1.1 (+http://www.facebook.com/externalhit_uatext.php)
           28 Mozilla/5.0 (Macintosh; Intel Mac OS X 10_10_1) AppleWebKit/600.2.5 (KHTML, like Gecko) Version/8.0.2 Safari/600.2.5 (Amazonbot/0.1; +https://developer.amazon.com/support/amazonbot)
           28 Mozilla/5.0 (Linux; Android 5.0) AppleWebKit/537.36 (KHTML, like Gecko) Mobile Safari/537.36 (compatible; Bytespider; spider-feedback@bytedance.com)
           27 Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; bingbot/2.0; +http://www.bing.com/bingbot.htm) Chrome/116.0.1938.76 Safari/537.36
           24 Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; +claudebot@anthropic.com)
           21 Mozilla/5.0 (compatible; DataForSeoBot/1.0; +https://dataforseo.com/dataforseo-bot)
           20 Sogou Pic Spider/3.0(+http://www.sogou.com/docs/help/webmasters.htm#07)
           18 Mozilla/5.0 (compatible; AhrefsBot/7.0; +http://ahrefs.com/robot/)
    • Mince je n’avais pas vu tes pings @biggrizzly (normal le ping vers @seenthis n’est plus relayé sur discourse), n’hésite pas à me pinger en direct :)

      Si les bots ne sont pas bloqués, il y a deux pistes : soit leur user agent n’est pas dans la liste déclaré par l’écran de sécu de SPIP cf https://git.spip.net/spip-contrib-outils/securite/-/blob/master/ecran_securite.php?ref_type=heads#L44 ou alors PHP n’a pas accès à sys_getloadavg cf https://git.spip.net/spip-contrib-outils/securite/-/blob/master/ecran_securite.php?ref_type=heads#L740

    • Merci pour les pistes @b_b. Depuis, donc, un certain temps, ça génère du 429, au lieu de 503. Je n’avais pas vu. Du coup, je constate que ça vire du monde, déjà. Et je constate, donc, que ça n’exclut pas beaucoup de bot, du fait de la règle qui est très peu excluante. La règle actuelle ne suffit pas. Je vais modifier la règle, en la rendant très excluante, et on va voir si ça va mieux. Merci encore.

    • Depuis que j’ai compris que ça déclenchait des 429 plutôt que des 503, j’ai pu adapter mes scripts (basiques) d’analyse des logs, et je vois désormais qu’il y a bien un effet de la part de ce système.

      Comme tu dois pouvoir le voir, j’ai ajouté des filtres très génériques. Apparemment, le load ne monte plus au dessus de 2, pour le moment. A suivre. Et j’espère qu’il n’y a pas de user-agent légitime qui contient « bot »... :-))

    • Puisqu’on en parle, des bots pas sympa, en voilà un gratiné. Si on se demande pourquoi pendant 5 minutes SeenThis était difficile d’accès, on peut demander des comptes au user-agent suivant : Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/116.0.0.0 Safari/537.36

      Dans les 1000 dernières lignes de log, il communiquait avec SeenThis depuis 4 adresses IP :

           87 183.192.118.124
           30 183.192.118.126
           18 183.192.118.18
          137 183.192.118.26

      Nous avons donc des bots qui tentent de se faire passer pour autre chose qu’un bot.

  • OpenAI
    https://openai.com/blog/introducing-openai

    des nouvelles de nos amis milliardaires post-humains Elon Musk, Peter Thiel et co. Ils veulent désormais s’instituer comme juge et partie de l’avenir de l’#intelligence_artificielle (pour le bien de tous, naturellement)

    AI could benefit society, and it’s equally hard to imagine how much it could damage society if built or used incorrectly.

    Because of AI’s surprising history, it’s hard to predict when human-level AI might come within reach. When it does, it’ll be important to have a leading research institution which can prioritize a good outcome for all over its own self-interest.