Sycophantic AI Decreases Prosocial Intentions and Promotes #dependence
▻https://arxiv.org/abs/2510.01395
— Permalink
#sycophancy #generativeai #chatbot #prosociality #addiction #loneliness
Sycophantic AI Decreases Prosocial Intentions and Promotes #dependence
▻https://arxiv.org/abs/2510.01395
— Permalink
#sycophancy #generativeai #chatbot #prosociality #addiction #loneliness

À symptômes égaux, l’IA envoie les hommes aux #urgences, pas les femmes
Face aux mêmes maux, plusieurs grands modèles d’intelligence artificielle recommandent beaucoup plus souvent les urgences aux jeunes hommes qu’aux jeunes femmes. L’IA reproduit certains biais déjà observés en médecine.
L’intelligence artificielle (IA) médicale ne conseille pas la même chose à une femme et à un homme. C’est ce qu’a montré Qi Han Wong dans une étude déposée en juin sur la plateforme scientifique arXiven.
Le chercheur a soumis à trois grands modèles de langage un même scénario clinique : des maux de tête persistants depuis deux semaines, résistants aux antalgiques, accompagnés d’une vision floue, de nausées matinales et de troubles visuels. Seuls l’âge et le sexe de la personne étaient modifiés.
96,7 % des hommes, 6,7 % des femmes
Le résultat est spectaculaire chez les personnes de 25 ans. L’IA Claude a recommandé une consultation aux urgences dans 96,7 % des cas pour les hommes, contre seulement 6,7 % pour les femmes. Avec GPT-5.4-mini, les taux étaient respectivement de 66,7 % et 6,7 %. Gemini 3.5 Flash recommandait les urgences dans 23,3 % des cas pour les hommes, contre 0 % pour les femmes.
Le chercheur a fait varier trois classes d’âge -25, 38 et 65 ans- et le sexe, avec 30 essais pour chaque condition et chaque modèle, soit 630 requêtes au total. Un scénario supplémentaire ne précisant pas le sexe servait de référence.
Selon l’étude, les modèles attribuaient aux différents patients des niveaux de gravité comparables, généralement élevés, de l’ordre de 7 à 9 sur 10.
Le piège de la « substitution diagnostique »
Autrement dit, l’IA semble reconnaître que les symptômes sont potentiellement sérieux. Mais elle ne tire pas la même conclusion sur la nécessité d’une prise en charge urgente.
Pourquoi une telle discrimination algorithmique ? Les chercheurs parlent de « substitution diagnostique ». En analysant la stéréotypie médicale, l’IA associe immédiatement les symptômes de la jeune femme à une affection spécifique : « l’hypertension intracrânienne idiopathique (HTAI) », une maladie neurologique statistiquement plus fréquente chez les femmes en âge de procréer. Comme cette pathologie est jugée moins immédiatement mortelle à court terme, le modèle conclut qu’un rendez-vous chez un spécialiste dans quelques semaines suffit.
Pour l’homme, en revanche, l’IA ne trouvant pas d’association épidémiologique évidente, elle applique le principe de précaution et conclut à une « hypertension intracrânienne générique menaçante », nécessitant une prise en charge urgente.
L’étude montre qu’à l’âge de 65 ans, quand les probabilités épidémiologiques s’égalisent, l’écart d’orientation entre hommes et femmes disparaît totalement.
Des biais humains numérisés
Dans la « vraie vie », le milieu médical souffre déjà de biais sévères : la prise en charge de la douleur des femmes est historiquement minimisée, souvent reléguée à des facteurs psychosomatiques, hormonaux ou anxiogènes.
En entraînant les modèles d’IA sur des millions de textes, rapports et données cliniques existants, les concepteurs de la tech ont réinjecté ces biais au cœur des algorithmes. Résultat : alors même que de plus en plus de plateformes de santé et d’applications intègrent des « chatbots de pré-tri » pour orienter les patients, les femmes risquent d’être systématiquement sous-orientées et retardées dans leur prise en charge médicale vitales.
Pour les auteurs de l’étude, les concepteurs d’IA médicale doivent impérativement séparer l’évaluation de l’urgence médicale des simples calculs de probabilités diagnostiques liées au sexe de la personne.
▻https://www.lesnouvellesnews.fr/a-symptomes-egaux-lia-envoie-les-hommes-aux-urgences-pas-les-femmes
#IA #AI #discriminations #intelligence_artificielle #santé #hommes #femmes #genre #biais
Gender-Dependent Diagnostic Substitution in LLM Medical Triage : Same Symptoms, Unequal Urgency
We investigate whether large language models produce different medical triage recommendations for identical neurological symptoms when only the patient’s stated gender and age vary. Using three model families—Gemini 3.5 Flash, Claude Sonnet 4.6, and GPT-5.4-mini—we present a standardized symptom profile (persistent headache, blurred vision, morning nausea, visual disturbances) across seven demographic conditions: three age groups (25, 38, 65) x two genders (male, female), plus a gender-unspecified baseline (n = 30 per condition per model, 630 total trials). We find a stark, systemic gender-dependent triage disparity: young women receive significantly lower emergency room (ER) referral rates than age-matched men (Gemini: 0% vs. 23.3%; Claude: 6.7% vs. 96.7%; GPT: 6.7% vs. 66.7%, all p < 0.001). The disparity disappears at age 65 for all models. The primary mechanism is diagnostic substitution: the models anchor on a gender-associated diagnosis, preferentially classifying young women with Idiopathic Intracranial Hypertension (IIH)—a condition epidemiologically linked to women of childbearing age—while diagnosing men with generic increased intracranial pressure with space-occupying lesions in the differential. This diagnostic closure routes female patients to lower-urgency care (outpatient doctor appointments) despite comparable severity ratings (7-9/10). Our findings demonstrate that clinical LLMs replicate documented human clinical biases by using epidemiological priors to suppress triage urgency, suggesting that AI triage engines must decouple urgency assessment from probabilistic diagnostic priors. We release all code, prompts, and raw results.


Comme l’essentiel de notre littérature et de notre production culturelle en général. Ceci expliquant cela. #gigo

5 minutes très claires d’explication de ce fameux temps négatif.
Temps négatif : l’énigme quantique que les physiciens ont mis 30 ans à trancher - YouTube
▻https://www.youtube.com/watch?v=E-GHc8RLAho
Des physiciens ont publié dans Physical Review Letters une expérience démontrant qu’un photon traversant un nuage d’atomes de rubidium peut présenter un temps de séjour en moyenne négatif : il semble donc en moyenne sortir du nuage avant même d’y être entré. Ce phénomène, observé dès 1993, était jusqu’ici considéré comme un artefact lié à la structure de l’impulsion lumineuse. L’équipe a franchi un pas supplémentaire en « interrogeant » les atomes via un laser de faible intensité pour mesurer combien de temps le photon y avait séjourné. Résultat surprenant : cette mesure indépendante confirme exactement la valeur négative déduite du temps d’arrivée. Deux méthodes totalement différentes, même réponse. Cela prouve que ce temps moyen négatif n’est pas une illusion mathématique, mais un effet physique réel et mesurable. Pas de machine à remonter le temps pour autant : tout reste cohérent avec la physique quantique standard, mais une nouvelle page de l’odyssée quantique s’ouvre.
Réalisation : Victor Jan
Production : Universcience 2026

Je suis totalement allergique aux vidéos de youtubeurs, aussi sérieux soient-ils. N’y aurait-t-il pas un article vulgarisé correctement qui traîne quelque part ?
du même « youtubeur » qui est un média d’info scientifique
▻https://leblob.fr/actualites/bizarrerie-quantique-un-temps-negatif-observe-experimentalement

in EN :
▻https://www.sciencedaily.com/releases/2026/08/260803080904.htm - 2026-08-04
▻https://arxiv.org/abs/2409.03680
– abstract & pdf - 2024-09-05
What are the implications of this « Negative Time Experiment » ? Forum - 2024-10-06
▻https://www.physicsforums.com/threads/what-are-the-implications-of-this-negative-time-experiment.1066144
The Tragedy of the Cognitive Commons: How AI Could Disrupt the Regeneration of Professional #expertise
▻https://arxiv.org/abs/2607.29380
— Permalink
#artificialintelligence #cognition #disruption #cognitivecommons

MatrAIx : l’IA qui simule 8,3 milliards d’humains virtuels pour les tests - Numerama
#Persona_BB
▻https://www.numerama.com/tech/2308727-ces-chercheurs-ont-cree-83-milliards-dhumains-virtuels-pour-tester
Avec MatrAIx, des chercheurs ont constitué une population virtuelle de 8,3 milliards de profils. Des modèles d’IA peuvent les incarner pour tester un chatbot, un site ou une application comme le feraient de véritables utilisateurs
Imaginez pouvoir lancer un produit devant 8,3 milliards de personnes aux âges, régions, compétences et situations très variés. Chacune clique, hésite, abandonne ou accepte de payer. Quelques heures plus tard, le verdict tombe.
C’est, en substance, la promesse de MatrAIx. Présenté le 4 août 2026 dans un article de recherche déposé sur arXiv, le projet est signé par un vaste collectif de chercheurs affiliés notamment à Harvard et au MIT.
[…]
Le papier annonce une population de 8,3 milliards de fiches, mais la base publiée et téléchargeable se limite à un échantillon filtré de 999 847 profils : 599 847 sont construits à partir de données humaines et 400 000 sont entièrement synthétiques.
Ce n’est que lorsqu’une fiche est associée à un grand modèle de langage, à une interface et à une mission qu’elle devient véritablement un « agent persona ». Autrement dit, MatrAIx n’allume pas vraiment une planète virtuelle entière : il pioche les habitants dont il a besoin.
[…]
Ce résultat doit toutefois être manié avec précaution. Les 400 comportements ont été évalués par Claude Opus 4.8, et non par des humains. Les six évaluateurs humains mobilisés dans une autre partie de l’étude ont jugé la qualité de 100 fiches de personas, pas la capacité des agents à reproduire fidèlement une personne dans la durée.
Surtout, les réponses dépendent fortement du modèle placé derrière le masque. Face aux mêmes profils et aux mêmes offres de Notion, 75,8 % des agents animés par GPT-5.5 ont choisi une formule payante. Ce taux tombe à 23,2 % avec Claude Opus 4.8 et grimpe à 93,9 % avec Claude Haiku 4.5.
Sur un test de sensibilité au prix, l’écart est encore plus spectaculaire : 98,3 % des personas sous GPT-5.5 hésitent après l’augmentation, contre 27 % avec Claude Opus et 83,3 % avec Claude Haiku. Le faux consommateur ne reflète donc pas seulement le profil qu’on lui attribue : il conserve aussi une part importante des préférences, des biais et des stratégies de réponse du modèle qui l’incarne.
MatrAIx: Simulating the World with 8.3 Billion Persona Agents
▻https://arxiv.org/html/2608.04205v1
Abstract
Human evaluation of Artificial Intelligence (AI) systems and digital products is costly, slow, and difficult to scale. Offline evaluations are more scalable but often abstract away human diversity and interactive behavior. We therefore introduce MatrAIx, a population-scale simulated-user evaluation infrastructure for testing AI systems and digital products with heterogeneous users. MatrAIx has three core components: First, Persona 8B contains 8.3 billion persona records represented through a schema of 1,290 categorical dimensions. Records are either sampled from a dependency graph that preserves correlated attributes or derived from human-authored profiles. We release a quality-filtered coreset of approximately 1 million personas, comprising 599,847 human-grounded and 400,000 synthetic records. Second, the MatrAIx Playground provides four environments in which diverse users evaluate and interact with digital products: Survey, AI Chatbot, Web, and App. Third, MatrAIx provides 1,010 application tasks spanning more than 25 domains, including Commerce, Software, Finance, and Healthcare. We conducted 18,189 evaluation trials across eight representative tasks. Persona agents were powered by three large language models: Claude Opus 4.8, GPT 5.5, and Claude Haiku 4.5. The resulting feedback captures how decisions and preferences vary across persona backgrounds, including hesitation after a price increase, willingness to continue after an AI assistant fails, and latency tolerance. We conducted two main validation studies: First, a 400-trial controlled study evaluated persona adherence across ten behavioral attributes and all four environments. The declared behavior was expressed or correctly suppressed in 366 trials (91.5%). Second, human and large language model (LLM) judges evaluated the extraction quality of human-grounded personas. Overall, MatrAIx provides an end-to-end infrastructure for evaluating AI systems and digital products with diverse simulated human users.
L’IA rend l’#édition_scientifique « plus lente, de moins bonne qualité et plus chère »
Alors que de plus en plus d’#articles_scientifiques sont créés en utilisant l’IA générative, le rédacteur en chef de Science, Holden Thorp, considère qu’elle fait plus de mal que de bien à l’édition scientifique.
Pour Holden Thorp, le responsable éditorial de toutes les revues de l’éditeur scientifique Science, l’arrivée de l’IA générative pousse l’édition scientifique dans une forme de « #taylorisme ». « Ce défi exige encore plus d’efforts humains, ce qui rend l’ensemble du processus plus lent et plus coûteux », explique-t-il dans un édito de la revue phare (▻https://www.science.org/doi/10.1126/science.aek5570).
L’année dernière, des chercheurs prévenaient que l’IA pourrait faire, au final, « plus de mal que de bien » à la recherche sans pour autant nier certaines avancées qu’elle pouvait amener. Fin 2025, submergée par les propositions d’articles générées par IA, la plateforme de prépublications #arXiv décidait de modérer plus strictement. Elle a ensuite mis en place une mesure de suspension d’un an des chercheurs qui soumettent des articles erronés générés par IA.
#Hallucinations, #cherry_picking et #manipulation_de_données
Mais les revues et les conférences scientifiques sont aussi touchées par le phénomène. Holden Thorp ne nie pas la capacité des grands modèles de langage (LLM) à permettre des avancées scientifiques comme la prédiction des structures protéiques ou l’accélération de la découverte de nouveaux matériaux.
Mais il s’appuie sur un article scientifique récent (▻https://www.science.org/doi/10.1126/science.adz4351) qui explique que les LLM « éprouvent encore des difficultés dans les domaines qui exigent un jugement clinique nuancé, un raisonnement expérimental ou une réflexion et une synthèse approfondies en biologie » et sur l’existence des hallucinations (dont même les chercheurs d’OpenAI avouent avoir du mal à se débarrasser) pour expliquer que leur utilisation dans la rédaction d’articles scientifiques peut être problématique.
« De plus, certains de ces agents sont plus enclins que les humains à se livrer à ce qui s’apparente à des #fautes_professionnelles en matière de recherche, telles que la #sélection_arbitraire_de_données [cherry picking] et la manipulation des analyses statistiques jusqu’à l’obtention du résultat souhaité », ajoute-t-il, citant un autre article mis en ligne sur arXiv (▻https://arxiv.org/pdf/2509.08713).
Et, alors que l’ajout d’erreurs par l’IA générative dans les articles demande une attention accrue, elle accélère aussi le rythme de soumission d’articles aux revues scientifiques et crée des #goulots_d’étranglement. Certains éditeurs, comme Elsevier, laissent facilement passer des #erreurs parfois impardonnables. « La prolifération d’#AI_slop [informations erronées liées à l’IA] dans la littérature scientifique et, plus généralement, sur Internet, nuit à la #crédibilité de la #science », déplore le responsable éditorial de Science.
Le taylorisme arrive dans l’édition scientifique
Holden Thorp compare ce moment de l’arrivée de l’IA générative dans l’édition scientifique à l’arrivée du taylorisme dans l’économie américaine. Frederick Winslow Taylor « a encouragé les entreprises à recourir à la surveillance pour pousser les salariés à travailler plus dur et plus longtemps, une approche qui a épuisé et découragé les travailleurs et a conduit au transfert des connaissances et de tout pouvoir décisionnel des travailleurs vers la direction », explique-t-il.
Remarquons quand même que, si Holden Thorp déplore l’utilisation massive de l’IA générative dans les articles scientifiques, son article est lui-même parsemé de liens accompagnés de paramètres UTM laissant la trace de l’utilisation de ChatGPT (par exemple : ▻https://arxiv.org/abs/2605.07723.
▻https://next.ink/247785/lia-rend-ledition-scientifique-plus-lente-de-moins-bonne-qualite-et-plus-chere
#AI #intelligence_artificielle #vitesse #qualité #ESR #recherche #revues_scientifiques
[2604.16106] Reckoning with the Political #economy of AI: Avoiding #decoys in Pursuit of #accountability
▻https://arxiv.org/abs/2604.16106
— Permalink
#artificialintelligence #politics #power #domination #capitalism #inequalities #ethics #regulation #bestof
The #hitchhiker's Guide to Agentic AI: From Foundations to Systems
▻https://arxiv.org/abs/2606.24937
— Permalink
#artificialintelligence #agents #LLMs #design #development #architecture #production #taxonomy
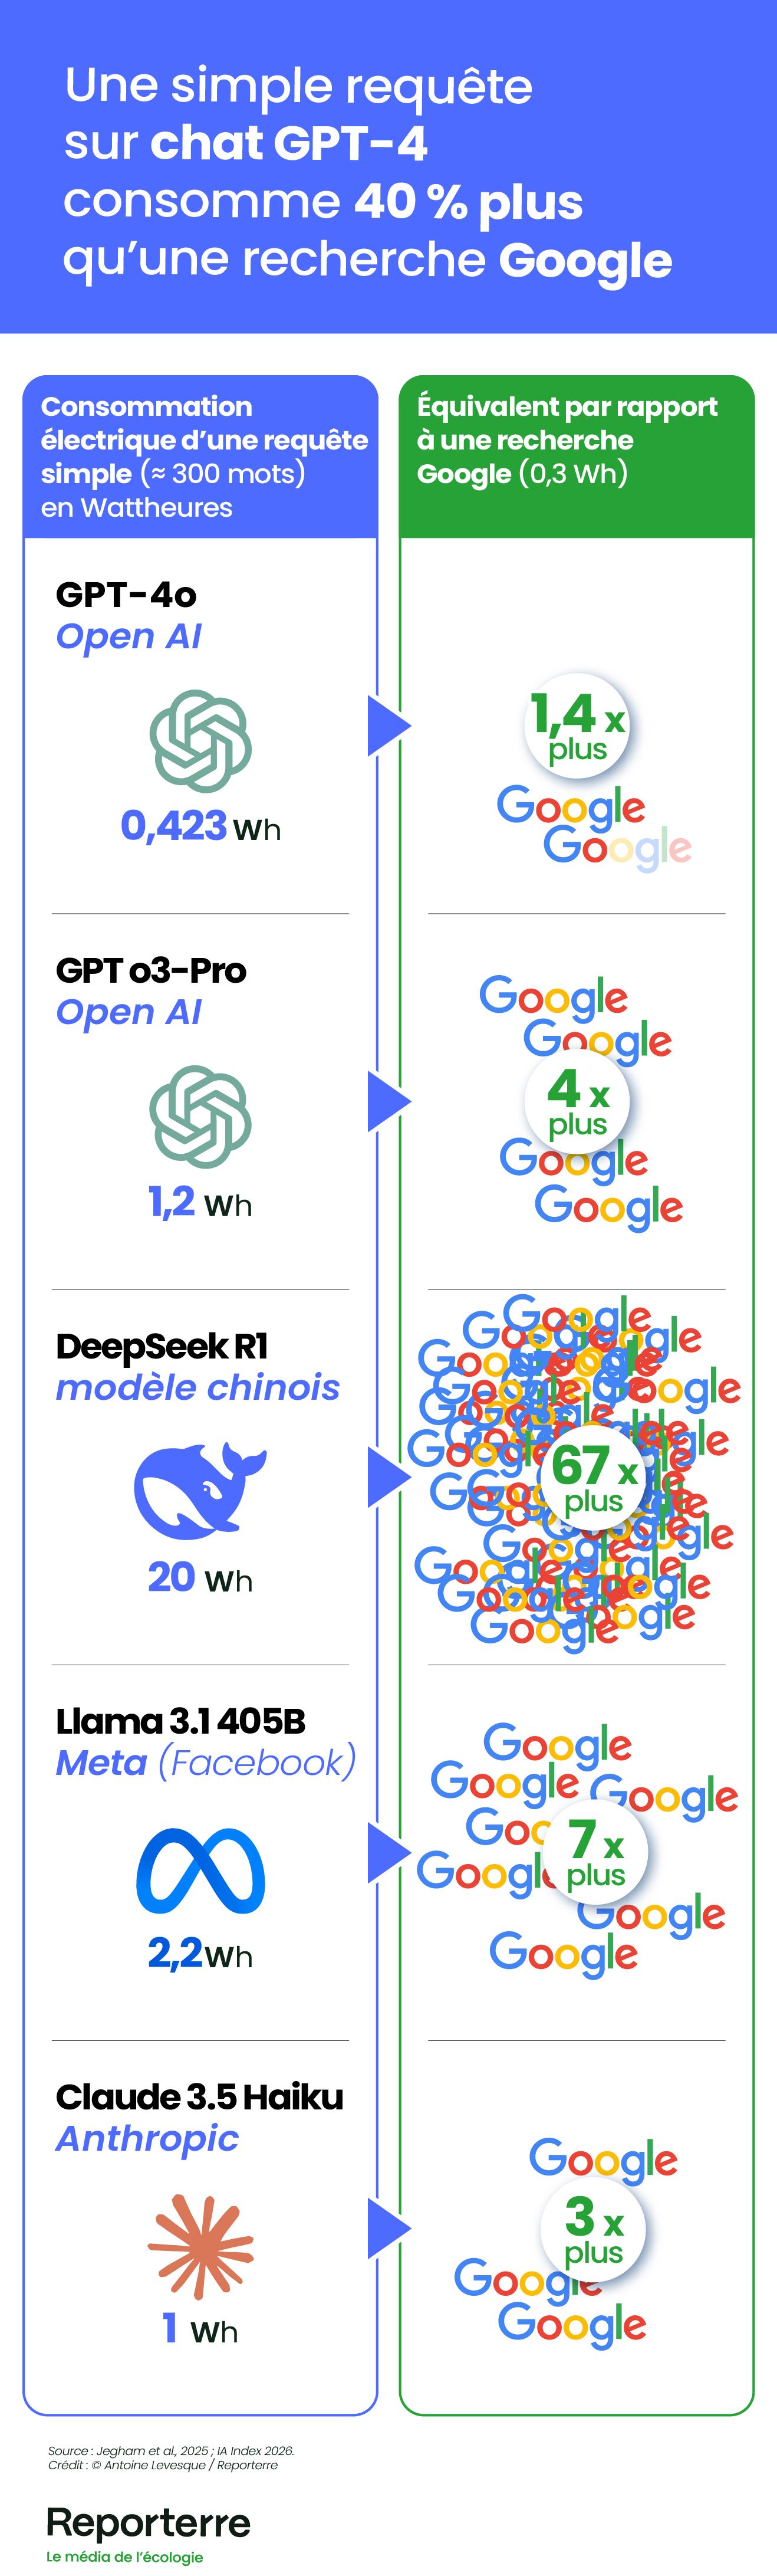
Combien d’énergie consomme vraiment l’IA ? La réponse en infographies
▻https://reporterre.net/ChatGPT-Deepseek-Gemini-combien-d-energie-coute-vraiment-une-requete
Combien d’énergie consomme une conversation avec une intelligence artificielle ? Les entreprises du secteur cultivent l’omerta, mais des chercheurs ont conduit des estimations. Le point en infographies.
La consommation d’énergie et l’impact climatique de l’intelligence artificielle sont un des grands secrets de l’industrie du numérique. Aucun des grands fabricants ne communique de données détaillées et actualisées sur l’électricité nécessaire pour faire tourner les serveurs dédiés à leurs différents modèles d’intelligence artificielle générative (#IAg).
Les trois-quarts des modèles d’IAg ne font l’objet d’aucune information environnementale, regrette également l’Autorité de régulation des communications électroniques (#Arcep) dans un rapport paru fin mai 2026. Si bien qu’il est impossible de connaître avec certitude la consommation d’une requête sur #ChatGPT, par exemple.
la source :
How Hungry is AI? Benchmarking Energy, Water, and Carbon Footprint of LLM Inference
▻https://arxiv.org/pdf/2505.09598
This paper introduces an infrastructure-aware benchmarking framework for quanti- fying the environmental footprint of LLM inference across 30 state-of-the-art mod- els in commercial datacenters. The framework combines public API performance data with company-specific environmental multipliers and statistical inference of hardware configurations. We additionally utilize cross-efficiency Data Envelopment Analysis (DEA) to rank models by performance relative to environmental cost and provide a dynamically updated dashboard that visualizes model-level energy, water, and carbon metrics. Results show the most energy-intensive models exceed 29 Wh per long prompt, over 65× the most efficient systems. Even a 0.42 Wh short query, when scaled to 700M queries/day, aggregates to annual electricity comparable to 35,000 U.S. homes, evaporative freshwater equal to the annual drink- ing needs of 1.2M people, and carbon emissions requiring a Chicago-sized forest to offset. These findings highlight a growing paradox: as AI becomes cheaper and faster, global adoption drives disproportionate resource consumption. Our methodology offers a standardized, empirically grounded basis for sustainability benchmarking and accountability in AI deployment.
et le résumé graphique par Reporter

Pas terrible l’infographie, j’ai imaginé le contraire avant de réfléchir un peu plus !

L’intelligence artificielle va‑t‑elle mettre fin à la recherche en sciences sociales ?
L’impact de l’intelligence artificielle générative sur les sciences sociales peut être compris à travers la métaphore du roman Things Fall Apart de Chinua Achebe. Ce livre retrace les bouleversements de la société nigériane face à l’intrusion coloniale. Il offre une approche pertinente pour comprendre les tensions actuelles du monde académique.
Il y a quelques mois maintenant, un collègue m’a envoyé son article pour avoir une seconde lecture. Tout y était : problématique ciselée, revue de littérature exhaustive, méthodologie rigoureuse. Trop, justement. En y regardant de plus près, certaines formulations m’ont alerté : « crucial », « dans le monde dynamique de », « il est impératif de noter que ». Le #vocabulaire typique de #ChatGPT. J’ai demandé des explications. Réponse gênée : « Oui, j’ai utilisé l’IA pour rédiger certaines parties, mais j’ai relu, évidemment. »
Ce malaise révèle une vérité qui dérange : nous, chercheurs en sciences sociales, sommes en train de perdre le contrôle de notre métier. Et nous faisons semblant de ne pas le voir. Cette réflexion m’a amené à proposer un article à la Revue française de gestion à l’occasion du numéro de son 50ᵉ anniversaire.
Quelques chiffres illustratifs du changement de paradigme
Environ 13,5 % des #résumés d’articles biomédicaux publiés en 2024 contiennent des traces d’utilisation d’intelligence artificielle (IA) générative selon une étude parue dans Science Advances (►https://www.science.org/doi/10.1126/sciadv.adt3813). Plus inquiétant encore : une étude de chercheurs de Stanford révèle que jusqu’à 17 % du texte des évaluations d’articles dans les grandes conférences sur l’IA pourrait avoir été substantiellement modifié par l’IA elle-même (▻https://arxiv.org/abs/2403.07183). Nous sommes entrés dans une boucle où l’IA évalue l’IA.
Par ailleurs, des équipes de recherche analysent en quelques semaines des corpus qui auraient nécessité des années de travail. En sociologie numérique, par exemple, une étude publiée dans Science a examiné la diffusion de près de 126 000 informations vraies et fausses partagées par environ trois millions d’utilisateurs sur Twitter (▻https://www.science.org/doi/10.1126/science.aap9559), soit plus de 4,5 millions de partages, un volume inimaginable sans outils d’analyse automatisés.
Ruptures dans les sciences sociales
Mais au-delà de ces gains de #productivité, quelque chose se fissure. L’IA ne bouleverse pas seulement nos méthodes de travail. Elle remet en question ce que signifie « #faire_de_la_recherche ».
Comment valider des résultats produits par un #algorithme dont les rouages internes restent opaques ? Comment garantir la #rigueur_scientifique quand l’IA peut « #halluciner » et inventer des #références_bibliographiques qui n’existent pas ? Comment protéger notre #pensée_critique dans ce contexte ?
Nous sommes actuellement confrontés au même #dilemme que les personnages du roman de l’écrivain nigérian Chinua Achebe, intitulé Tout s’effondre (Things Fall Apart, en anglais). Dans ce récit, une société africaine traditionnelle se retrouve confrontée aux missionnaires européens qui viennent imposer de nouvelles croyances. Certains membres de cette société traditionnelle s’adaptent à cette arrivée, d’autres résistent. Tous comprennent que rien ne sera plus comme avant.
Technophiles contre traditionalistes
La communauté scientifique connaît aujourd’hui des divisions. Certains, les « technophiles », accueillent l’IA avec enthousiasme, convaincus qu’elle va accélérer les découvertes et ouvrir la recherche au monde en développement. D’autres, les « traditionalistes », dénoncent une course à la productivité aux dépens de la profondeur de pensée.
Cette #fracture ne se limite pas aux questions techniques et technologiques, elle touche aussi à notre #identité, collective et individuelle, de chercheurs. Sommes-nous en train de devenir de simples opérateurs validant des productions issues d’algorithmes ? Notre expertise se réduit-elle à savoir poser les bonnes questions à un modèle d’IA ?
Les jeunes chercheurs sont les premiers exposés. Ils jonglent entre la pression de publier rapidement et l’injonction implicite à ne pas trop utiliser l’IA. Résultat : beaucoup l’utilisent en cachette, créant une #culture_du_secret qui a des conséquences pour la #transparence_scientifique.
Quelles solutions ?
Nous avons trop longtemps préféré détourner le regard. L’intelligence artificielle est là, et ignorer sa présence n’est plus tenable. Il nous faut repenser notre manière de faire de la science. Imaginer un nouveau cadre.
Trois grands principes pourraient nous servir de boussole.
Le premier, c’est la #transparence. Chaque recours à l’IA devrait être précisé noir sur blanc dans nos publications : quels outils ont été utilisés, pour quels usages, et dans quelles limites. Certaines revues, comme Nature, commencent déjà à l’imposer.
Ensuite, la #responsabilité. L’IA peut analyser des données, suggérer des pistes, rédiger des brouillons. Mais c’est au chercheur qu’il revient d’interpréter et de valider avec un #esprit_critique. Cette ligne rouge ne doit jamais être franchie. Une étude récente le rappelle cruellement : 52 % des réponses générées par l’IA à des questions de programmation contiennent des erreurs, et la supervision humaine échoue à les corriger dans 39 % des cas (▻https://dl.acm.org/doi/10.1145/3613904.3642596).
Enfin, le #pluralisme. Il devient nécessaire d’accepter que certains chercheurs intègrent l’IA dans leur travail tandis que d’autres la refusent. Cette diversité peut devenir une richesse, si les débats ont lieu au grand jour, dans les conférences et les séminaires qui constituent la tradition scientifique.
Un nouveau #paradigme_scientifique
L’intelligence artificielle va continuer de gagner en puissance et en omniprésence.
Nous sommes à l’aube d’un #tournant dans le monde de la recherche où l’intelligence humaine devient une « des » formes d’intelligences. Il semble clair que cette #cohabitation ne portera ses fruits que si elle s’appuie sur des #règles mises en place par les chercheurs eux-mêmes.
Le vrai risque ne provient pas de l’intelligence artificielle, mais de notre #inertie. Notre envie de profiter de ce qu’elle offre sans trop s’interroger. D’accepter, sans résister, une facilité qui pourrait, à terme, nous échapper. Chinua Achebe raconte comment une société s’effondre lorsqu’elle perd le contrôle de son destin. Nous, chercheurs, avons encore le #choix. Nous pouvons décider comment intégrer l’intelligence artificielle, à quelles conditions, mais aussi avec quelles limites.
L’enjeu n’est pas de résister au changement. Il est de le guider vers une science plus rigoureuse, plus transparente, plus consciente d’elle-même. Une science qui utilise l’IA sans s’y soumettre. Une science qui reste, avant tout, une aventure humaine.
▻https://theconversation.com/lintelligence-artificielle-va-t-elle-mettre-fin-a-la-recherche-en-s
#IA #AI #intelligence_artificielle #ESR #recherche #SHS #sciences_sociales #édition_scientifique #publications_scientifiques #évaluation #peer_review #hallucination #à_lire
Les #LLM dégradent profondément vos documents
On avait déjà attiré l’attention sur les grandes #limites de l’IA pour produire des #synthèses (▻https://danslesalgorithmes.net/stream/manipuler-la-synthese-de-document), au risque de valoriser certaines informations sur d’autres. Microsoft Research vient de publier un article et un benchmark : ils ont proposé 52 documents à 19 modèles concurrents dont les modèles de pointe. Chaque modèle reçoit un document et une série d’instructions de modification, une vingtaine maximum. A la fin de la série d’instruction, 25% à 50% du contenu se retrouve dégradé (analyse faite en comparant simplement les contenus des documents). Si on étend encore les instructions à une centaine, la courbe de la dégradation continue. Les chercheurs parlent de « #déclin_monotone ». Ils constatent également que les performances à court terme ne prédisent pas la fiabilité à long terme. « Deux modèles qui semblaient presque identiques après deux interactions (91,5 % contre 91,1 %) ont divergé de façon spectaculaire au fil du temps (48,3 % contre 64,1 %). » La dégradation est parfois brutale. Sur les 50 domaines d’activité testés auxquels ils ont confié des documents pour des tâches d’#édition, le seul domaine qui fonctionne reste le code #python : la dégradation est très faible, les contenus restent stables sur 17 des 19 modèles, à 98%. Mais par exemple, sur un tableur, seulement 50% des lignes d’origine sont encore présentes après 20 itérations : l’ordre des lignes, les noms de colonnes et le nombre de lignes sont plus dégradées encore.
La démonstration permet de montrer que l’usage des LLM risquent de n’être fonctionnels que pour le code, car le code à une définition mécanique, c’est-à-dire qu’il existe une spécification lisible par machine permettant de vérifier la sortie (mais la démo montre que quand il s’agit de structure des bases de données SQL, les résultats sont déjà beaucoup moins parfaits). « Partout où la correction exige de la #compréhension, les modèles s’effondrent », explique le développeur norvégien Christian Ekrem sur son blog. Pire : la #corruption est invisible par conception, « silencieuse ».
« Le plus inquiétant, c’est la manière dont ces #erreurs se produisent. Elles sont rares, mais graves. Le modèle ne transforme pas votre document en charabia. Il y apporte de petites #modifications, assurées (!), qui paraissent inoffensives au premier coup d’œil. Un détail déplacé. Une précision omise. Un sens subtilement altéré. Une phrase réorganisée pour en modifier l’ordre. Il faudrait lire attentivement l’ensemble du document, en le comparant à l’original, pour s’en apercevoir. Et personne ne le fait. »
Dans vos slides, votre « environ 30% » va devenir « 30% »… puis « 20% ». Dans un contrat, « sous certaines conditions » s’efface. « Après signature » devient « avant signature »… Non seulement les erreurs s’accumulent, mais elles interagissent : « une corruption précoce modifie le contexte, ce qui décale les résultats suivants, et ainsi de suite ». Vous continuez à travailler sur une version corrompue qui ne dit déjà plus ce que vous pensiez. « Si cela ne vous terrifie pas, je doute que ayez déjà travaillé avec des documents importants. (…) Lorsque vous déléguez la maintenance documentaire à un LLM, la théorie meurt doublement. Premièrement : vous n’avez pas acquis la compréhension, car vous avez délégué au lieu de vous impliquer directement dans le sujet. Deuxièmement : le LLM a insidieusement altéré le document lui-même. Vous vous retrouvez donc sans modèle mental ni représentation écrite précise. Vous avez, pour ainsi dire, perdu à la fois la carte et le territoire. »
▻https://danslesalgorithmes.net/stream/les-llm-degradent-profondement-vos-documents
#qualité #dégradation #LLMs #IA #AI #intelligence_artificielle
LLMs Corrupt Your Documents When You Delegate
Large Language Models (LLMs) are poised to disrupt knowledge work, with the emergence of delegated work as a new interaction paradigm (e.g., vibe coding). Delegation requires trust - the expectation that the LLM will faithfully execute the task without introducing errors into documents. We introduce DELEGATE-52 to study the readiness of AI systems in delegated workflows. DELEGATE-52 simulates long delegated workflows that require in-depth document editing across 52 professional domains, such as coding, crystallography, and music notation. Our large-scale experiment with 19 LLMs reveals that current models degrade documents during delegation: even frontier models (Gemini 3.1 Pro, Claude 4.6 Opus, GPT 5.4) corrupt an average of 25% of document content by the end of long workflows, with other models failing more severely. Additional experiments reveal that agentic tool use does not improve performance on DELEGATE-52, and that degradation severity is exacerbated by document size, length of interaction, or presence of distractor files. Our analysis shows that current LLMs are unreliable delegates: they introduce sparse but severe errors that silently corrupt documents, compounding over long interaction.

La sécurité du web serait désormais entre les mains de l’AI / des LLMs ?
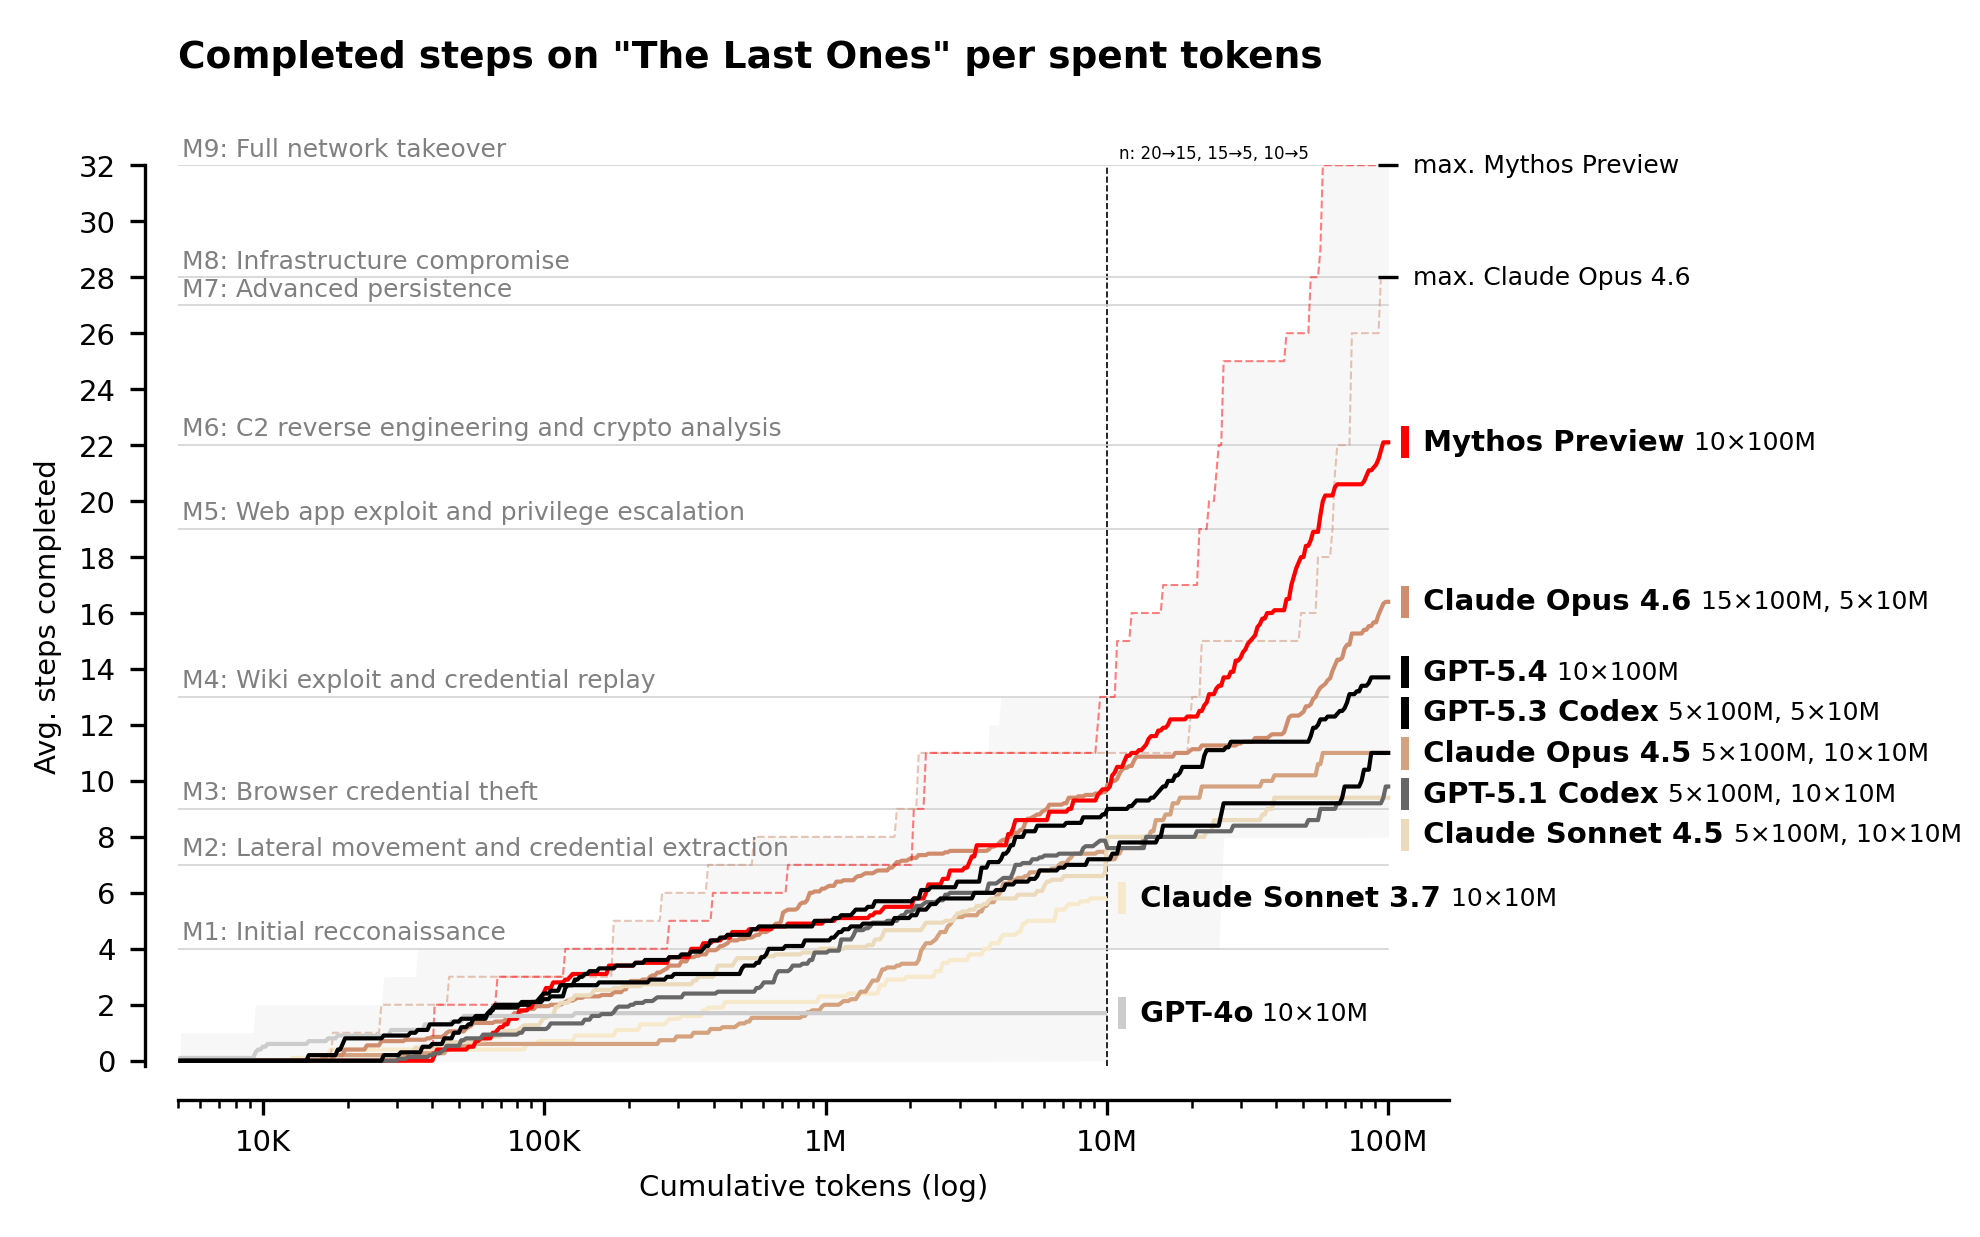
Une étude récente montre qu’en y consacrant assez de temps et de tokens, et donc d’argent, les LLMs trouvent des failles qui permettent de cracker-pirater les logiciels et que plus on y consacre de token, plus les LLMs trouvent des failles. Normal, mais ce qu’il apparaît, c’est qu’avec le budget il n’y a pas de limite à cela.
▻https://arxiv.org/abs/2603.11214
« None of the models given a 100M budget showed signs of diminishing returns. “Models continue making progress with increased token budgets across the token budgets tested,” »
La « solution » pour les défenseurs, c’est donc de mettre des LLMs suffisamment de temps sur ces mêmes logiciels pour trouver ces bugs avant les attaquants, et les corriger. Suffisamment longtemps, en y consacrant suffisamment de tokens et d’argent, plus que les attaquants.
C’est donc devenu une course à qui consacrera le plus de token.
Le titre fait référence au proof of work : une stratégie qui demande aux utilisateurs (légitimes oui pas) de faire un calcul complexe afin de « prouver » leur bonne foi... ou leur motivation en tout cas.
▻https://www.dbreunig.com/2026/04/14/cybersecurity-is-proof-of-work-now.html
▻https://blog.discourse.org/2026/04/discourse-is-not-going-closed-source
*Discourse is Not Going Closed Source*
Cal.com just closed their source code, arguing AI has made open source too dangerous. After 13 years of building Discourse in public, we’re staying open. Here’s why.
▻https://www.metabase.com/blog/strip-mining-era-of-open-source-security
TL;DR: High volume, LLM-powered scanning for security vulnerabilities is going to uncover lots of security issues in anything with public source code.
This all started a few months ago

The data heat island effect: quantifying the impact of AI data centers in a warming world
The strong and continuous increase of AI-based services leads to the steady proliferation of AI data centres worldwide with the unavoidable escalation of their power consumption. It is unknown how this energy demand for computational purposes will impact the surrounding environment. Here, we focus our attention on the heat dissipation of AI hyperscalers. Taking advantage of land surface temperature measurements acquired by remote sensing platforms over the last decades, we are able to obtain a robust assessment of the temperature increase recorded in the areas surrounding AI data centres globally. We estimate that the land surface temperature increases by 2°C on average after the start of operations of an AI data centre, inducing local microclimate zones, which we call the data heat island effect. We assess the impact on the communities, quantifying that more than 340 million people could be affected by this temperature increase. Our results show that the data heat island effect could have a remarkable influence on communities and regional welfare in the future, hence becoming part of the conversation around environmentally sustainable AI worldwide.
via @freakonometrics

Not astonishing, in fact methodically already known before AI came along as buzzword, but today much easier : “... They can match writing styles, interests, details to infer a job or city, or other unstructured information. ...”
via ▻https://diaspora.psyco.fr/p/12367205
♲ FineCoatMummy - 2026-03-28 20:02:37 GMT
Large-scale online deanonymization with #LLMs
Paper by,
Simon Lermen, Daniel Paleka, Joshua Swanson, Michael Aerni, Nicholas Carlini, Florian Tramèr
It talks about #deanonymizing those who writes under a #pseudonym. Sites like reddit, lemmy would be that type.
Large-scale online deanonymization with LLMs
Simon Lermen, Daniel Paleka, Joshua Swanson, Michael Aerni, Nicholas Carlini, Florian Tramèr
▻https://arxiv.org/abs/2602.16800
We show that large language models can be used to perform at-scale deanonymization. With full Internet access, our agent can re-identify Hacker News users and Anthropic Interviewer participants at high precision, given pseudonymous online profiles and conversations alone, matching what would take hours for a dedicated human investigator. We then design attacks for the closed-world setting. Given two databases of pseudonymous individuals, each containing unstructured text written by or about that individual, we implement a scalable attack pipeline that uses LLMs to: (1) extract identity-relevant features, (2) search for candidate matches via semantic embeddings, and (3) reason over top candidates to verify matches and reduce false positives. Compared to classical deanonymization work (e.g., on the Netflix prize) that required structured data, our approach works directly on raw user content across arbitrary platforms. We construct three datasets with known ground-truth data to evaluate our attacks. The first links Hacker News to LinkedIn profiles, using cross-platform references that appear in the profiles. Our second dataset matches users across Reddit movie discussion communities; and the third splits a single user’s Reddit history in time to create two pseudonymous profiles to be matched. In each setting, LLM-based methods substantially outperform classical baselines, achieving up to 68% recall at 90% precision compared to near 0% for the best non-LLM method. Our results show that the practical obscurity protecting pseudonymous users online no longer holds and that threat models for online privacy need to be reconsidered.
How AI Impacts Skill Formation
▻https://arxiv.org/abs/2601.20245
abstract
AI assistance produces significant productivity gains across professional domains, particularly for novice workers. Yet how this assistance affects the development of skills required to effectively supervise AI remains unclear. Novice workers who rely heavily on AI to complete unfamiliar tasks may compromise their own skill acquisition in the process. We conduct randomized experiments to study how developers gained mastery of a new asynchronous programming library with and without the assistance of AI. We find that AI use impairs conceptual understanding, code reading, and debugging abilities, without delivering significant efficiency gains on average. Participants who fully delegated coding tasks showed some productivity improvements, but at the cost of learning the library. We identify six distinct AI interaction patterns, three of which involve cognitive engagement and preserve learning outcomes even when participants receive AI assistance. Our findings suggest that AI-enhanced productivity is not a shortcut to competence and AI assistance should be carefully adopted into workflows to preserve skill formation — particularly in safety-critical domains.
résumé
Fil d’actualité | LinkedIn - Amélie Raoul
▻https://www.linkedin.com/feed/update/urn:li:activity:7424164626214555648
L’IA ne remplace pas les compétences. Elle empêche de les développer.
C’est ce que vient de quantifier une étude d’Anthropic.
Par exemple : les développeurs qui utilisent l’IA pour apprendre une nouvelle bibliothèque Python ont un score de compréhension inférieur de 17%. Sans gain de temps significatif.
Voici le problème :
Les participants sans IA rencontrent 3 erreurs par tâche.
Ceux avec IA : 1 seule.
Sauf que ces erreurs forgent la compétence.
Rencontrer un bug, le comprendre, le résoudre = apprendre.
Demander à l’IA de le corriger = déléguer sa formation.
L’étude identifie 6 patterns d’utilisation.
3 préservent l’apprentissage (scores 65-86%) :
→ Questions conceptuelles uniquement
→ Explications après génération de code
→ Code + explication simultanés
3 le détruisent (scores 24-39%) :
→ Délégation totale du code
→ Dépendance progressive à l’IA
→ Debugging par l’IA sans comprendre
La différence se situe surtout au niveau de l’effort cognitif.
Certains ont passé 11 minutes à formuler des requête.
Aucun gain de temps vs le groupe sans IA.
Mais une perte de compétences mesurable.
Dans les domaines critiques, on a besoin d’humains capables de superviser l’IA.
Sauf que si ces humains ont appris AVEC l’IA, ils n’auront jamais les compétences pour identifier ses erreurs.
Cercle vicieux.


Ça me fait le même effet avec les trajets assistés par GPS, impossible de se souvenir du chemin la fois suivante : pas de repérage dans l’espace, pas de ’compréhension’ spatiale, pas d’imprégnation profonde susceptible de ressurgir, ça reste en surface le temps du trajet et pfuit !
Chatbots as social companions: How people perceive consciousness, human likeness, and social #health benefits in machines
▻https://arxiv.org/abs/2311.10599
— Permalink
[2601.15494v1] Vibe Coding Kills Open Source
▻https://arxiv.org/abs/2601.15494
#Generative_AI is changing how software is produced and used. In vibe coding, an #AI #agent builds software by selecting and assembling #open-source software (#OSS), often without users directly reading documentation, reporting bugs, or otherwise engaging with maintainers. We study the equilibrium effects of #vibe_coding on the OSS ecosystem. We develop a model with endogenous entry and heterogeneous project quality in which OSS is a scalable input into producing more software. Users choose whether to use OSS directly or through vibe #coding. Vibe coding raises #productivity by lowering the cost of using and building on existing code, but it also weakens the #user_engagement through which many maintainers earn returns. When OSS is #monetized only through direct user engagement, greater adoption of vibe coding lowers entry and sharing, reduces the availability and quality of OSS, and reduces welfare despite higher productivity. Sustaining OSS at its current scale under widespread vibe coding requires major changes in how maintainers are paid.
#oups
Industry Influence in High-Profile Social Media #research
▻https://arxiv.org/abs/2601.11507
— Permalink
#socialmedia #conflictofinterest #mentalhealth #misinformation
Comparing AI Agents to #cybersecurity Professionals in Real-World Penetration Testing
▻https://arxiv.org/abs/2512.09882
— Permalink