• Car harm: A global review of automobility’s harm to people and the environment

    Despite the widespread harm caused by cars and automobility, governments, corporations, and individuals continue to facilitate it by expanding roads, manufacturing larger vehicles, and subsidising parking, electric cars, and resource extraction. This literature review synthesises the negative consequences of automobility, or car harm, which we have grouped into four categories: violence, ill health, social injustice, and environmental damage. We find that, since their invention, cars and automobility have killed 60–80 million people and injured at least 2 billion. Currently, 1 in 34 deaths are caused by automobility. Cars have exacerbated social inequities and damaged ecosystems in every global region, including in remote car-free places. While some people benefit from automobility, nearly everyone—whether or not they drive—is harmed by it. Slowing automobility’s violence and pollution will be impracticable without the replacement of policies that encourage car harm with policies that reduce it. To that end, the paper briefly summarises interventions that are ready for implementation.

    https://www.sciencedirect.com/science/article/pii/S0966692324000267

    #voitures #trafic_routier #automobiles #santé #environnement #santé_publique #statistiques #chiffres #violence #injustices_sociales #dégâts #mortalité #blessés #blessures #pollution #article_scientifique

    signalé aussi par @sombre
    https://seenthis.net/messages/1043079

  • L’IA rend l’#édition_scientifique « plus lente, de moins bonne qualité et plus chère »

    Alors que de plus en plus d’#articles_scientifiques sont créés en utilisant l’IA générative, le rédacteur en chef de Science, Holden Thorp, considère qu’elle fait plus de mal que de bien à l’édition scientifique.

    Pour Holden Thorp, le responsable éditorial de toutes les revues de l’éditeur scientifique Science, l’arrivée de l’IA générative pousse l’édition scientifique dans une forme de « #taylorisme ». « Ce défi exige encore plus d’efforts humains, ce qui rend l’ensemble du processus plus lent et plus coûteux », explique-t-il dans un édito de la revue phare (https://www.science.org/doi/10.1126/science.aek5570).

    L’année dernière, des chercheurs prévenaient que l’IA pourrait faire, au final, « plus de mal que de bien » à la recherche sans pour autant nier certaines avancées qu’elle pouvait amener. Fin 2025, submergée par les propositions d’articles générées par IA, la plateforme de prépublications #arXiv décidait de modérer plus strictement. Elle a ensuite mis en place une mesure de suspension d’un an des chercheurs qui soumettent des articles erronés générés par IA.

    #Hallucinations, #cherry_picking et #manipulation_de_données

    Mais les revues et les conférences scientifiques sont aussi touchées par le phénomène. Holden Thorp ne nie pas la capacité des grands modèles de langage (LLM) à permettre des avancées scientifiques comme la prédiction des structures protéiques ou l’accélération de la découverte de nouveaux matériaux.

    Mais il s’appuie sur un article scientifique récent (https://www.science.org/doi/10.1126/science.adz4351) qui explique que les LLM « éprouvent encore des difficultés dans les domaines qui exigent un jugement clinique nuancé, un raisonnement expérimental ou une réflexion et une synthèse approfondies en biologie » et sur l’existence des hallucinations (dont même les chercheurs d’OpenAI avouent avoir du mal à se débarrasser) pour expliquer que leur utilisation dans la rédaction d’articles scientifiques peut être problématique.

    « De plus, certains de ces agents sont plus enclins que les humains à se livrer à ce qui s’apparente à des #fautes_professionnelles en matière de recherche, telles que la #sélection_arbitraire_de_données [cherry picking] et la manipulation des analyses statistiques jusqu’à l’obtention du résultat souhaité », ajoute-t-il, citant un autre article mis en ligne sur arXiv (https://arxiv.org/pdf/2509.08713).

    Et, alors que l’ajout d’erreurs par l’IA générative dans les articles demande une attention accrue, elle accélère aussi le rythme de soumission d’articles aux revues scientifiques et crée des #goulots_d’étranglement. Certains éditeurs, comme Elsevier, laissent facilement passer des #erreurs parfois impardonnables. « La prolifération d’#AI_slop [informations erronées liées à l’IA] dans la littérature scientifique et, plus généralement, sur Internet, nuit à la #crédibilité de la #science », déplore le responsable éditorial de Science.

    Le taylorisme arrive dans l’édition scientifique

    Holden Thorp compare ce moment de l’arrivée de l’IA générative dans l’édition scientifique à l’arrivée du taylorisme dans l’économie américaine. Frederick Winslow Taylor « a encouragé les entreprises à recourir à la surveillance pour pousser les salariés à travailler plus dur et plus longtemps, une approche qui a épuisé et découragé les travailleurs et a conduit au transfert des connaissances et de tout pouvoir décisionnel des travailleurs vers la direction », explique-t-il.

    Remarquons quand même que, si Holden Thorp déplore l’utilisation massive de l’IA générative dans les articles scientifiques, son article est lui-même parsemé de liens accompagnés de paramètres UTM laissant la trace de l’utilisation de ChatGPT (par exemple : https://arxiv.org/abs/2605.07723.

    https://next.ink/247785/lia-rend-ledition-scientifique-plus-lente-de-moins-bonne-qualite-et-plus-chere
    #AI #intelligence_artificielle #vitesse #qualité #ESR #recherche #revues_scientifiques

  • Des #Enjeux de nos données de santé (2/2) : les données plutôt que le soin
    https://www.internetactu.net/2021/11/16/des-enjeux-de-nos-donnees-de-sante-2-2-les-donnees-plutot-que-le-soin

    Suite de notre tentative à saisir les transformations en cours du système de santé en regardant les enjeux que posent l’exploitation des données de santé. S’affranchir de notre consentement ? La confidentialité des données de santé est toujours critique, rappelions-nous. Le problème ou le risque, c’est que pour que les acteurs (...)

    #Articles #données_publiques #intelligence_artificielle #politiques_publiques #Santé

  • L’apprentissage automatique peut-il changer notre compréhension du monde ?
    https://www.internetactu.net/2021/11/30/lapprentissage-automatique-peut-il-changer-notre-comprehension-du-mond

    Le journaliste philosophe David Weinberger (@dweinberger, blog) étudie depuis longtemps les effets d’internet sur la connaissance. Il est actuellement écrivain en résidence (« à temps partiel et temporaire ») chez Google (et il tient un autre blog sur le sujet de l’apprentissage automatisé, lié à sa résidence). Pour le magazine Aeon (@aeonmag), (...)

    #Articles #Enjeux #complexité #intelligence_artificielle

  • Nous défaire de nos imaginaires statistiques
    https://www.internetactu.net/2021/12/16/nous-defaire-de-nos-imaginaires-statistiques

    331 449 281, telle est la population totale des États-Unis au 1er avril 2020 selon le bureau du recensement américain. Le recensement de la population produit depuis longtemps un chiffre, toujours précis. Précis, mais par nature inexact. C’est pour la chercheuse danah boyd (@zephoria), chercheuse associée chez Microsoft et fondatrice (...)

    #Articles #Technologies #démocratie #données_publiques #ouverture_des_données #statistique

  • L’IA vise à accélérer la décision, bien plus qu’à l’améliorer !
    https://www.internetactu.net/2022/01/06/lia-vise-a-accelerer-la-decision-bien-plus-qua-lameliorer

    « Les gens ne prennent pas de meilleures décisions lorsqu’ils disposent de plus de données, alors pourquoi supposer que l’Intelligence artificielle, elle, le fera ? », interroge l’ingénieure et anthropologue Marianne Bellotti (blog, @bellmar) dans un article pour OneZero. Bellotti, longtemps responsable technique des Services numériques des États-Unis (@USDS), est désormais responsable du (...)

    #Articles #Technologies #biais_cognitifs #évaluation #intelligence_artificielle #nossystemes

  • Reprendre, démanteler, communiser
    https://communaux.cc/2023/05/reprendredemanteler-communiser

    Éléments pour une politique terrestre des soulèvements. « Seul un basculement radical — un soulèvement — pourrait permettre d’enrayer le réchauffement climatique et la 6ème extinction massive des espèces déjà en cours. Au fond, nous le savons, il ne nous reste aujourd’hui plus d’autre voie que de mettre toutes nos forces dans la bataille pour enrayer le désastre en cours, et abattre le système économique dévorant qui l’engendre. »

    #Articles #Tribunes #communaux #communs #démanteler_les_réseaux #écologie #faire_commune #sabotages #terres_urbaines

  • Explosion des data centers en France : une trajectoire hors de contrôle

    La #loi_de_simplification_de_la_vie_économique, à travers son #article_15, assouplit le #droit de l’#urbanisme et de l’#environnement pour favoriser l’émergence de sites dits #hyperscaler – d’une surface de 40 ha minimum, soit l’équivalent de 55 terrains de foot.

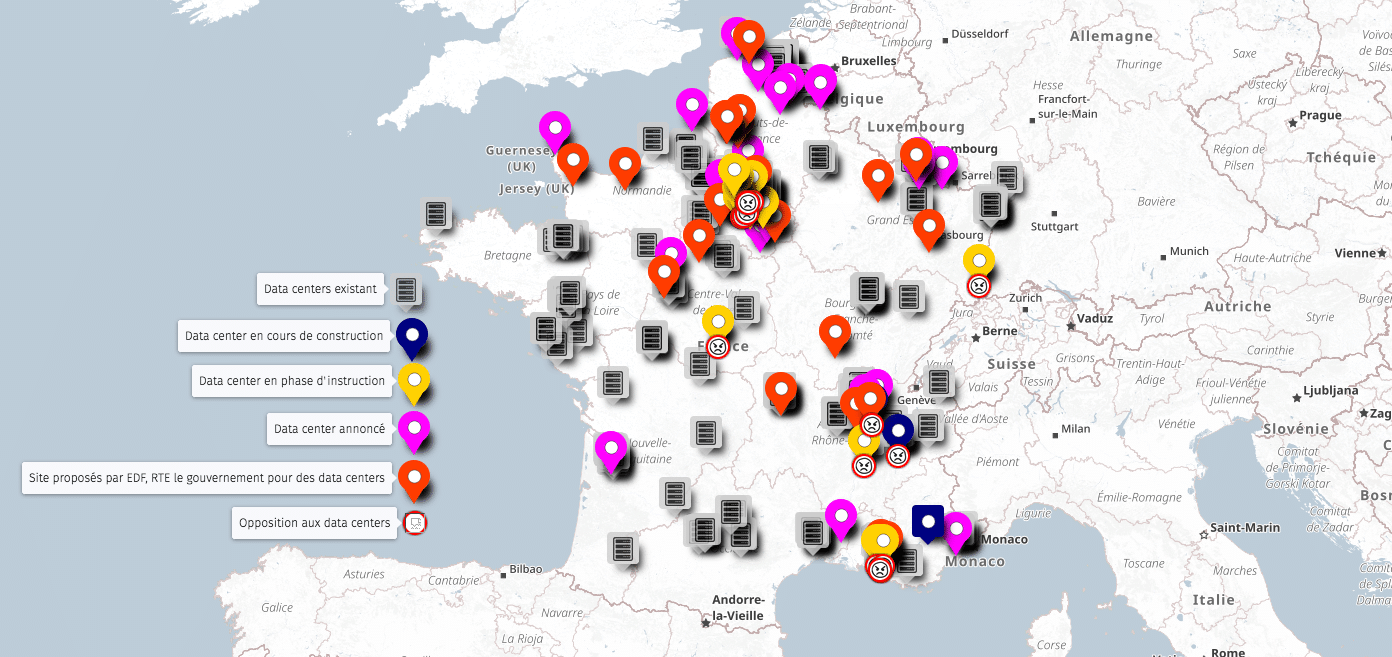
    En France, la multiplication de data centers s’accélère à un rythme effréné, portée par une #volonté_politique assumée de faire du territoire un hub stratégique du #numérique. Face à cette #fuite_en_avant, le collectif #Le_nuage_était_sous_nos_pieds vient de lancer son site internet, accompagné d’une cartographie participative recensant les data centers, actuels et futurs. Un outil pensé pour rendre visible une industrie opaque et alimenter les résistances face à l’expansion incontrôlée des infrastructures numériques.

    Le secteur du numérique connaît actuellement une expansion internationale fulgurante, qui s’explique notamment par l’essor de l’Intelligence Artificielle (IA) et son utilisation, devenue régulière pour deux tiers de la population mondiale.

    La France fait partie des têtes de file dans la course effrénée au développement de l’IA et du tout numérique, passant de la 13ème place en 2023 à la 5ème place en 2024 dans le Global AI Index – un indice qui évalue les pays en fonction de leurs investissements et de leurs innovations relatifs à l’IA.
    La cartographie comme outil politique

    Dans ce contexte, le collectif Le nuage était sous nos pieds a lancé son site internet avec, notamment, la mise en ligne d’une cartographie participative afin de répertorier les data centers en France.

    « Nous avons cartographié 350 data centers déjà existants et 47 data centers en cours de déploiement à travers la France : 28 annoncés, 11 en cours d’instruction par les services de l’état et 8 en cours de construction », peut-on lire sur leur site.

    Si cette comptabilisation n’est pas complète – à cause du manque de transparence de l’industrie – elle rend toutefois compte de l’importance de la croissance du secteur dans l’Hexagone.

    « Les objectifs du collectif : politiser les infrastructures du numérique, les visibiliser, les mettre au cœur du débat public et en faire un objet de lutte », explique Antoine, l’un des membres du collectif.

    Loin d’un simple travail de recensement, la cartographie du collectif s’attaque frontalement à l’opacité d’une industrie dont le développement échappe largement au débat public, et fournit par la même occasion un outil d’enquête citoyenne indispensable pour engager un rapport de force avec l’État et les géants du numérique.

    Une expansion organisée et encouragée par l’État

    Si cette initiative voit le jour aujourd’hui, ce n’est pas un hasard. Le développement des data centers en France connaît une accélération brutale, encouragée par les pouvoirs publics. Depuis le sommet international sur l’intelligence artificielle organisé à Paris en février 2025, l’exécutif affiche sa volonté d’investir massivement dans l’IA et ses infrastructures, au nom de la compétitivité et de la souveraineté numérique.

    À cette occasion, 109 milliards d’euros d’investissement privés – majoritairement étrangers – avaient été annoncés pour accélérer cette expansion, s’ajoutant aux 400 millions d’euros de subventions annoncés par l’ancien Premier ministre, François Bayrou, et aux 10 milliards d’investissement de la BPIFrance.

    Cette stratégie se traduit concrètement par une série de mesures facilitant l’implantation des data centers. La loi de simplification de la vie économique, à travers son article 15, assouplit le droit de l’urbanisme et de l’environnement pour favoriser l’émergence de sites dits hyperscaler – d’une surface de 40 ha minimum, soit l’équivalent de 55 terrains de foot.

    L’État, en lien avec EDF et RTE, a également identifié 63 sites “clés en main”, directement raccordés et proposés aux investisseurs pour faciliter l’implantation et la construction de nouveaux data centers, accentuant davantage la responsabilité des pouvoirs publics dans cette course au gigantisme.
    L’ADEME alerte sur une trajectoire hors de contrôle

    Le 6 janvier 2026, l’ADEME a publié un rapport dans lequel l’agence avance des estimations de l’évolution du secteur jusqu’à 2060 en fonction de cinq scénarios :

    – Tendanciel : une poursuite des dynamiques actuelles qui se traduit par une explosion des usages numériques, un développement massif de l’IA, et une bascule vers des data centers hyperscaler.
    - Génération frugale : un scénario de sobriété forte reposant sur une dénumérisation partielle des usages, un moratoire sur les nouveaux data centers et des politiques publiques contraignantes.
    – Coopérations territoriales : un développement encadré des data centers, en concertation avec les territoires et sous contraintes environnementales, avec une priorité aux usages socialement utiles et une recherche de synergies locales, notamment pour limiter les tensions sur l’eau, l’énergie et le foncier.
    – Technologies vertes : les data centers deviennent des leviers de la transition écologique, soutenus par l’État au nom de la souveraineté et du mix électrique français.
    – Pari réparateur : une trajectoire qui se traduit par une confiance dans l’innovation pour compenser les impacts du numérique, avec une régulation allégée et une forte croissance des usages.

    À travers ces cinq scénarios, l’agence estime alors la consommation électrique des data centers ainsi que leurs émissions de gaz à effet de serre sur les 35 années à venir.

    « Le rapport de l’ADEME montre très clairement que la tendance actuelle est insoutenable, et qu’on va dans le mur en termes de poursuite de nos objectifs climatiques », analyse Lou Welgryn, secrétaire générale de Data for Good, pour La Relève et La Peste.

    Accaparement des ressources et tensions locales

    Derrière ces chiffres et ces estimations, des conflits très concrets se manifestent. Les data centers sont extrêmement gourmands en électricité et en eau, deux ressources déjà sous tension.

    Selon les estimations de l’ADEME, si rien n’est fait, la consommation électrique de ces infrastructures pourrait être multipliée par 3,7 d’ici à 2035, passant de 9,91 TWh/an à 36,73 TWh/an, soit près de 7% de la production actuelle d’électricité en France.

    L’implantation rapide de ces infrastructures fait émerger des conflits d’usage, comme à Marseille, qui accueille un certain nombre de data centers du fait de l’arrivée de dix-huit câbles intercontinentaux dans la cité phocéenne. Sur place, l’électricité consommée par les centres de données entre en concurrence directe avec l’électrification des ferrys et des transports locaux.

    Une problématique que la chercheuse et la professeure Anne Pasek résume ainsi : « Si nous ne faisons qu’augmenter les capacités du réseau électrique dans le seul but de répondre à une demande toujours plus croissante [des data centers], nous ne parviendrons pas à atteindre nos objectifs de décarbonation ».
    Contre-pouvoir face au techno-capitalisme

    Face à cette dynamique, la cartographie du collectif vise à « fabriquer une réflexion autour des data centers » et à « favoriser l’émergence de nouvelles contestations ». Par ce biais, elle s’inscrit dans une stratégie plus large de surveillance citoyenne, de plaidoyer et de politisation des enjeux liés aux infrastructures numériques.

    En parallèle, les associations en lutte multiplient les alertes sur les impacts du numérique et de l’IA.

    « Mettre en lumière ces problématiques et briser l’opacité permet de placer ce sujet au cœur du débat démocratique », rappelle Noémie Levain, juriste à La Quadrature du Net, pour La Relève et La Peste

    Les collectifs portent également une critique plus profonde de la trajectoire numérique empruntée actuellement, en la replaçant dans une lecture décroissante. Ils interrogent quant aux besoins réels, à la dépendance aux technologies et la compatibilité du tout-numérique avec les objectifs climatiques.

    « Il faut se poser la question : pourquoi construit-on autant de centres de données et pourquoi aurait-on besoin d’autant de puissances de calcul ? », insiste Lou Welgryn.

    En rendant visibles les infrastructures, la cartographie force le débat politique et rappelle que derrière l’IA se joue un choix de société aux conséquences durables sur les ressources, les territoires et les personnes qui les habitent.

    https://lareleveetlapeste.fr/explosion-des-data-centers-en-france-une-trajectoire-hors-de-contr

    #liste #data_centers #centres_de_données #IA #AI #France #intelligence_artificielle #infrastructure #carte #visualisation #cartographie #cartographie_participative #recensement #opacité #expansion #ressources #électricité #eau #conflits #tensions_locales #contre-pouvoir #techno-capitalisme

    ping @reka

    • Carte des data centers, des projets et des contestations en France

      Nous publions une carte participative répertoriant les data centers existants, les projets et les oppositions qui s’organisent en France autour de ces infrastructures. Notre objectif est de favoriser l’émergence ou la consolidation de contestations partout où ces bases du numérique dominant se prévoient.
      Nous avons cartographié 351 data centers déjà existants et 67 data centers actuellement en cours de déploiement à travers la France : 43 annoncés, 16 en cours d’instruction par les services de l’état et 8 en cours de construction.
      À cela il faut ajouter les 63 sites « clés-en-main » proposés par le gouvernement aux industriels de la tech pour faciliter l’implantation et la construction de nouveaux data centers - dont seulement 26 localisations précises sont publiques à ce jour. RTE et EDF mettent également 8 sites à disposition des promoteurs avec des procédures de raccordement électrique accéléré.
      Il est important de noter que le nombre de data centers ne permet pas de se faire une idée adéquate de l’accroissement des infrastructures. Les technologies impliquées sont en forte mutation, et la consommation énergétique des data centers ou le nombre de serveurs qu’ils abritent donne une indication plus ajustée des évolutions du secteur. Ainsi, les data centers actuels peuvent avoir une consommation énergétique jusqu’à plusieurs milliers de fois plus importante que les data centers historiques. Et les serveurs qu’ils abritent sont toujours plus nombreux et intenses en technologies.
      Nous avons recensés une vingtaine d’oppositions locales à ces déploiements, menées par des collectifs, des individus ou des associations.

      https://lenuageetaitsousnospieds.org/articles/2025-12-11-carte-des-data-centers-des-projets-et-des-conte
      #opposition #résistance

    • Prospective d’évolution des consommations des data centers à court, moyen et long terme de 2024 à 2060

      Cette étude de l’ADEME répond à 3 objectifs :
      1. Dresser l’état des lieux de la consommation électrique actuelle des centres de données en France ;
      2. Proposer un modèle prospectif détaillé permettant de modéliser des scénarios d’évolution des consommations des centres de données dans le temps ;
      3. Modéliser et analyser 5 scénarios prospectifs jusqu’à 2060 : un scénario tendanciel et 4 scénarios envisageant les 4 chemins possibles de transition écologique.

      Cette étude a considéré les émissions de gaz à effet de serre engendrées, la pression sur les ressources en eau, l’artificialisation des sols, la concurrence avec les d’autres usages de l’électricité, ou encore les enjeux de souveraineté numérique et distingue les consommations en France des consommations à l’étranger pour un usage français.

      https://librairie.ademe.fr/energies/8910-prospective-d-evolution-des-consommations-des-data-centers-a-co
      #ADEME #rapport

  • De l’esprit du #Capitalisme
    https://ecologiesocialeetcommunalisme.org/2026/05/04/de-lesprit-du-capitalisme

    Réflexion 30 avril 2026 #Andrea_Zhok Les analyses d’inspiration marxiste restent les plus efficaces pour interpréter la société contemporaine, les plus aptes à expliquer et à anticiper ses dynamiques sous-jacentes. Cependant, elles pèchent souvent par un manque d’intuition et de perspective figurative. Si l’on explique à quelqu’un que ses actions, indépendamment de ce qu’il pense […] L’article De l’esprit du capitalisme est apparu en premier sur Atelier d’Écologie Sociale et Communalisme.

    #Articles_d'intérêt_et_liens_divers #El_Viejo_Topo #l'Interferenza

  • #Antiéconomie (sortir de l’Économie)
    https://ecologiesocialeetcommunalisme.org/2026/04/27/antieconomie-sortir-de-leconomie

    À rebours des critiques classiques du capitalisme, qui cherchent à réorganiser ou moraliser l’économie, ce texte issu de la critique de la valeur propose une rupture plus radicale : sortir de l’économie elle-même comme forme sociale. En écho aux perspectives de l’écologie sociale communaliste — qui visent à réinscrire la production dans des communautés démocratiques […] L’article Antiéconomie (sortir de l’Économie) est apparu en premier sur Atelier d’Écologie Sociale et Communalisme.

    #Articles_d'intérêt_et_liens_divers #Critique_du_capitalisme_et_de_l'Etat #Dictionnaire_Wertkritik #Paliim-PSAO #Post-capitalisme

  • Schooling undersiege in Sarajevo
    https://www.visionscarto.net/schooling-undersiege-in-sarajevo

    Sarajevo, 4th of April 1992. The city is under siege, and it is extremely dangerous to go to school. But teachers and students find an alternative to the classrooms on the lines of fire. A mesh of safe locations, punkts, is woven in the city fabric and students are able to attend class in their vicinity. Sarajevo is unique in that sense; not only for conducting class during wartime, which is something that already happened in other cities — Beirut, Pristina, Warsaw in the Jewish ghetto — but (…) Articles

    #Articles_

  • L’imbécile et l’impossible délivrance contre l’autonomie
    https://ecologiesocialeetcommunalisme.org/2026/03/04/limbecile-et-limpossible-delivrance-contre-lautonomie

    Pourquoi publier ce texte de Nicolas Caseaux sur L’Atelier ? Ce texte fait écho aux analyses que nous développons à L’Atelier à partir d’une écologie sociale communaliste vivante, orientée vers la reconstruction de Communes libres et confédérées. En opposant le « #Fantasme_de_délivrance » à la quête d’autonomie, Nicolas Caseaux – dans le sillage […] L’article L’imbécile et l’impossible délivrance contre l’autonomie est apparu en premier sur Atelier d’Écologie Sociale et Communalisme.

    #Articles_d'intérêt_et_liens_divers #Aurélien_Berlan #Autonomie #Commualisme #Ecologie_sociale #Nicolas_Casaux

  • Numérique : en quête de sens
    https://www.curseurs.be/numeros/numero-5/article/numerique-en-quete-de-sens

    Alors que le numérique s’impose partout, il est plus que jamais nécessaire d’en questionner les effets et les affects. Dans ce texte proposé à Curseurs, Khrys, rédactrice du « Khrys’presso On peut aussi considérer que cette nouvelle révolution n’est qu’un prolongement de la première, une simple étape dans l’automatisation toujours plus poussée des tâches et de la machinisation de nos vies.]], est littéralement vendue comme une facilitation de la vie quotidienne, elle apparaît (...) #Numéro_5

    / #OK, #Articles

  • L’œuf du serpent
    https://ecologiesocialeetcommunalisme.org/2025/12/15/loeuf-du-serpent

    — la vague ultra comme symptôme de la dégradation du capital INVITATION À LIRE CE TEXTE D’ALFREDO APILÁÑEZ Ce texte que nous fournit Alfredo Apiláñez vous semblera sans doute d’emblée un peu long mais qu’à celà en tienne, une fois entamé il vous plongera de façon captivante dans les méandres de notre monde brouillé et […] L’article L’œuf du serpent est apparu en premier sur Atelier d’Écologie Sociale et Communalisme.

    #Articles_d'intérêt_et_liens_divers #Alfredo_Apilánez #Capitalisme #Extrême-Droite #Ultra-Droite

  • A Case for a Tri-Globe Projection
    https://www.visionscarto.net/a-case-for-a-tri-globe-projection

    Mapping terrestrial space in its entirety is an equation with no solution, as the comic book by Jean Leveugle and Emmanuelle Vagnon — Geographia, l’odyssée cartographique de Ptolémée — evokes with as much erudition as humor. Generations of geographers have attempted to achieve the “perfect projection,” with little success so far. The issue remains relevant, especially when one seeks the “most comprehensive possible forms” for representing the geo-historical processes of globalization that (…) Articles

    #Articles_

  • #Décoder

    La #Recherche pour tous
    https://www.youtube.com/watch?v=Q1y1l7PJyF0


    La connaissance n’a pas de prix et doit être accessible librement. Toutefois, le grand public a rarement l’occasion de questionner les résultats issus de la recherche, de demander des précisions, de pouvoir exprimer sa critique à l’égard de ces travaux.
    Face à ce problème, nous avons imaginé un #journal pluridisciplinaire dans lequel des chercheur.e.s pourraient publier leurs articles dans une version « vulgarisée », en accès libre. Ces #articles_vulgarisés seraient ensuite validés après un travail de relecture de collégien.ne.s, et/ou lycéen.ne.s mis.e.s en contact avec le.la chercheur.e.

    Et ce journal, comme nous étions motivé.e.s, nous l’avons créé.

    https://journal-decoder.fr
    #vulgarisation #enfants #science #articles_scientifiques #lycée #collègue #éducation #revue

  • Retrospective and prospective study of the evolution of #APC costs and electronic subscriptions for French institutions

    A journal article dataset has been developed with metadata of articles by France-based authors in the period 2013-2020. The purpose of this dataset was to form a basis for the retrospective and prospective analyses of the total costs of APCs paid by French institutions. APCs are the article processing charges (APCs) that researchers must pay to have their articles published in some open access journals. The main results of the retrospective analysis of the dataset regarding the numbers of APC-paid articles with a France-based corresponding author: - the total cost of APCs has tripled in the period 2013-2020. The major driver is the growth of articles in Gold OA journals, i.e. fully open access journals with APCs (without this growth, the APC cost would have been multiplied by 1,69 instead of 3) - the journal publishers and dissemination platforms have been categorised in four tiers, each publishing between 20% and 32% of all articles with a French co-author in 2020: tier 1 with the top publisher (Elsevier), tier 2 with three publishers, tier 3 with 16 publishers and tier 4 with the long tail of publishers (n=1995). The highest growth rate of APC-paid articles by France-based corresponding authors is seen in journals published by tier 2 publishers (Springer Nature, Wiley and MDPI) - more than three quarters of the APC-paid articles by France-based corresponding authors are in the fields of biology and medical research. The main observation regarding the price evolution of the APCs is that the APC-level for HybridOA articles started in 2013 at a high level (2 453 € in average) but have been stable over the years with 2 488 € in average in 2020. The APC-level for articles in Gold journals started considerably lower with an average APC in 2013 of 1 395 €. However, a rapid increase in the level of APCs for Gold OA articles has been observed, with an average APC of 1 745 € in 2020. This has led to a calculation of the total cost of APCs paid by French institutions between 2013 and 2020. In addition to the above-mentioned article dataset, 2019 and 2020 data from the ERE survey by Couperin (the national consortium of research performing organizations that negotiates with publishers the prices and conditions of access to research publications for the benefit of its members) were analysed in order to assess the total subscription costs of journal packages for French institutions. This data was compiled in Microsoft Power BI with additional information about the categories of the products, the publisher tiers, and the respondents to both surveys. This resulted in an estimate of ca. 87,5 M€ for the total expenditure on journal packages by all Couperin members in 2020. An analysis by Couperin of the ERE surveys 2014-2021 showed that the price increases per year in this period varied between -1,95% and +7,22% with an average price increase of 1,76% per year. The evolution of the total journal subscription costs based on this average annual growth rate results in an estimated 97,5 M€ in 2030. Using known and trusted data from our dataset (i.e. excluding articles for which the country of the corresponding author could not be determined, or whose APC price could not be precisely estimated), we developed mixed-effects models of APC prices as a function of other articles’ features. These models were used to predict the evolution of the total cost of APCs for the period 2021-2030, in various situations,: - under the assumption of continuing and unchanged trends. The predicted cost of APCs in 2030 is 50,6 M€, whereas the total expenditure on journal subscriptions would be 97,5 M€ - for a scenario with an acceleration towards Gold OA, the predicted cost of APCs in 2030 is 68,7 M€; - and for a scenario with increase of Green OA and a transition from HybridOA towards Gold, the predicted cost of APCs in 2030 is 38,5 M€. Finally, a situation was simulated where 90% of all articles by France-based corresponding authors would be Gold OA (and 10% would be published in Diamond OA journals) in order to assess the cost ceiling of such a 100% open access situation. In this case the predicted cost of APCs in 2030 is 168,7 M€.

    https://hal-lara.archives-ouvertes.fr/hal-03909068v1
    #édition_scientifique #recherche #coûts #France #ESR #recherche #université #article_processing_charges (#APC)

    –-

    ajouté à la métaliste sur la #publication_scientifique:
    https://seenthis.net/messages/1036396

  • 06 – 11 -25 🦭 #artic_storm 🦭
    https://radioblackout.org/podcast/06-11-25-%f0%9f%a6%ad-artic-storm-%f0%9f%a6%ad

    Honningswag – 6 Novembre 2025 “la tempesta spazza i vetri dello studuo e la ricevente vibra, sferzata dagli artigli di ghiaccio del vento. Carella intuisce distante il profilo tarchiato di Archangelo, duemila kilometri di invisibili piste tracciate sulla neve.Gli ospiti che tentano ogni settimana la sfida della connessione, fluttuano nella nebbia sensoriale; il feedback telefonico […]

    #impro #le_grandi_dirette_del_900 #noise #telefono_smerdato #viaggi
    https://radioblackout.org/wp-content/uploads/2025/11/6112025_tempesta-artica-escopost.mp3

  • Dessine-moi ta cour !
    https://www.imagomundi.fr/article111.html

    Dans le cadre du Festival International de Géographie (FIG) de 2025, l’école primaire des Trois Hameaux de Moyenmoutier dont les classes de cycle 3 sont situées dans le hameau Saint-Blaise (Vosges) s’est essayée à la cartographie. Intitulé « Dessine-moi ta cour ! », un atelier a réuni 38 élèves de la classe de CE1/CE2 de Marjorie Gully et les élèves de ma classe de CM1/CM2. Ce travail était accompagné par Nepthys Zwer et David Goeury. Voici quelques premières réflexions sur une expérience (…) #Articles

    https://fig.saint-die-des-vosges.fr
    https://laclassecooperative.com

  • Lutte pour le #Commun de l’eau et recul de l’État en #Bolivie
    https://ecologiesocialeetcommunalisme.org/2025/10/08/lutte-pour-le-commun-de-leau-et-recul-de-letat-en-bol

    Par #Pierre_Sauvêtre. Depuis les années 1990 et l’établissement de l’hégémonie mondiale des politiques néolibérales, l’objectif pour faire de l’eau un « bien commun » a été récurrent dans les mouvements sociaux. En 2011, les italiens ont réussi à faire annuler un décret du gouvernement Berlusconi sur la privatisation de l’eau, et le mouvement italien […] L’article Lutte pour le commun de l’eau et recul de l’État en Bolivie est apparu en premier sur Atelier d’Écologie Sociale et Communalisme.

    #Articles_d'intérêt_et_liens_divers #Eau #Etat

  • Science journalists find #ChatGPT is bad at summarizing scientific papers

    Summarizing complex scientific findings for a non-expert audience is one of the most important things a science journalist does from day to day. Generating summaries of complex writing has also been frequently mentioned as one of the best use cases for large language models (despite some prominent counterexamples).

    With all that in mind, the team at the American Association for the Advancement of Science (AAAS) ran an informal year-long study to determine whether ChatGPT could produce the kind of “news brief” paper summaries that its “SciPak” team routinely writes for the journal Science and services like EurekAlert. These SciPak articles are designed to follow a specific and simplified format that conveys crucial information, such as the study’s premise, methods, and context, to other journalists who might want to write about it.

    Now, in a new blog post and white paper discussing their findings, the AAAS journalists have concluded that ChatGPT can “passably emulate the structure of a SciPak-style brief,” but with prose that “tended to sacrifice accuracy for simplicity” and which “required rigorous fact-checking by SciPak writers.”

    “These technologies may have potential as helpful tools for science writers, but they are not ready for ’prime time,’ at this point for the SciPak team,” AAAS writer Abigail Eisenstadt said.
    Where’s the human touch?

    From December 2023 to December 2024, AAAS researchers selected up to two papers per week for ChatGPT to summarize using three different prompts of varying specificity. The team focused on papers with difficult elements like technical jargon, controversial insights, groundbreaking discoveries, human subjects, or non-traditional formats. The tests used the “Plus” version of the latest publicly available GPT models available through the study period, which generally spanned the eras of GPT-4 and GPT-4o.

    In total, 64 papers were summarized, and those summaries were evaluated both quantitatively and qualitatively by the same SciPak writers who had briefed those papers for the AAAS. The researchers note that this design “could not account for human biases,” which we’d argue might be significant among journalists evaluating a tool that was threatening to take over one of their core job functions.

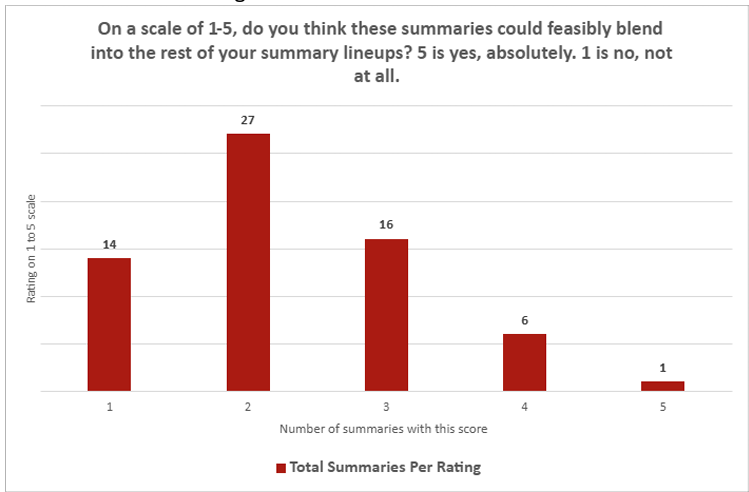
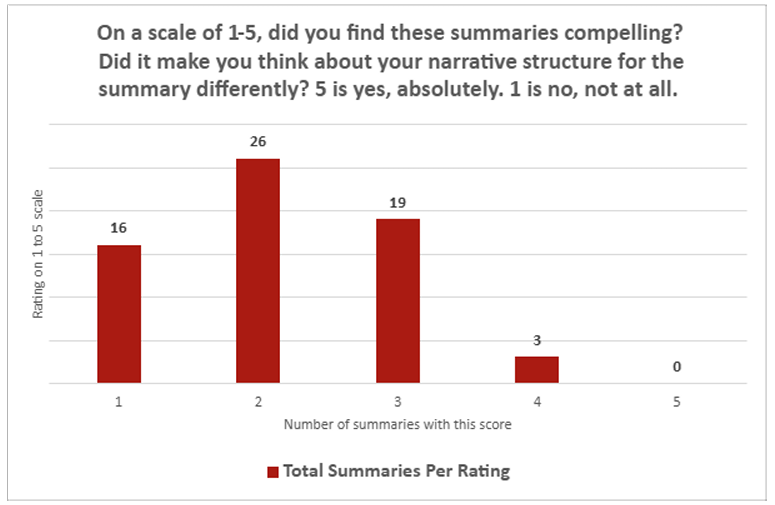
    Still, the quantitative survey results among those journalists were pretty one-sided. On the question of whether the ChatGPT summaries "could feasibly blend into the rest of your summary lineups, the average summary rated a score of just 2.26 on a scale of 1 ("no, not at all") to 5 ("absolutely"). On the question of whether the summaries were “compelling,” the LLM summaries averaged just 2.14 on the same scale. Across both questions, only a single summary earned a “5” from the human evaluator on either question, compared to 30 ratings of “1.”
    Not up to standards

    Writers were also asked to write out more qualitative assessments of the individual summaries they evaluated. In these, the writers complained that ChatGPT often conflated correlation and causation, failed to provide context (e.g., that soft actuators tend to be very slow), and tended to overhype results by overusing words like “groundbreaking” and “novel” (though this last behavior went away when the prompts specifically addressed it).

    Overall, the researchers found that ChatGPT was usually good at “transcribing” what was written in a scientific paper, especially if that paper didn’t have much nuance to it. But the LLM was weak at “translating” those findings by diving into methodologies, limitations, or big picture implications. Those weaknesses were especially true for papers that offered multiple differing results, or when the LLM was asked to summarize two related papers into one brief.

    While the tone and style of ChatGPT summaries were often a good match for human-authored content, “concerns about the factual accuracy in LLM-authored content” were prevalent, the journalists wrote. Even using ChatGPT summaries as a “starting point” for human editing “would require just as much, if not more, effort as drafting summaries themselves from scratch” due to the need for “extensive fact-checking,” they added.

    These results might not be too surprising given previous studies that have shown AI search engines citing incorrect news sources a full 60 percent of the time. Still, the specific weaknesses are all the more glaring when discussing scientific papers, where accuracy and clarity of communication are paramount.

    In the end, the AAAS journalists concluded that ChatGPT “does not meet the style and standards for briefs in the SciPak press package.” But the white paper did allow that it might be worth running the experiment again if ChatGPT “experiences a major update.” For what it’s worth, GPT-5 was introduced to the public in August.

    https://arstechnica.com/ai/2025/09/science-journalists-find-chatgpt-is-bad-at-summarizing-scientific-paper
    #résumés #AI #IA #intelligence_artificielle #articles_scientifiques #recherche_scientifique #SciPak #journalisme #médias #presse

  • La machine à ranger le monde
    https://www.curseurs.be/numeros/numero-5/article/la-machine-a-ranger-le-monde

    Aujourd’hui, l’ordinateur, sans toujours être nommé, se retrouve sur nos bureaux, dans nos salons, nos chambres, dans nos sacs, nos poches et des objets du quotidien. Nappé de l’internet dont il motorise tous les rouages, il est omniprésent. Mais pourquoi l’appelle-t-on ordinateur en français ? Comment l’appelle-t-on dans d’autres langues ? Cet article explore le mot ordinateur, ses traductions et les notions qu’il évoque. En décembre 1982, le Monde publiait : « Il a une soixantaine (...) #Numéro_5

    / #Articles