• L’IA dans les formations supérieures : beaucoup d’effets délétères et peu d’apports positifs

    D’après l’enquête IA et enseignement supérieur réalisée par le MESR en juin 2025 (https://mission-ia-sup.forge.apps.education.fr), les usages pédagogiques de l’IAG (Intelligence Artificielle Générative) largement dominants dans les universités sont de l’aide à la rédaction (44% des usages pour les enseignant·es et 62% pour les étudiant·es) et la recherche d’information (75% pour les étudiant·es). En termes d’outils d’IA souhaités, la recherche d’information arrive en rang 1 avec 60% des étudiant·es, à quoi s’ajoutent 50% de recherche de sources diversifiées (rang 4) et 50% de vérification d’informations (rang 2). Le rang 3 est occupé par l’assistance à la rédaction. Il n’y a donc pour l’instant aucun doute sur les usages actuels de l’IA et leur avenir proche par les étudiant·es. Pour les enseignant·es il s’agit surtout d’aides à l’évaluation (les 5 premiers rangs, supérieurs à 50%).

    Réaliser soi-même la recherche d’information et de rédaction est essentiel dans une formation supérieure

    Or ces usages touchent au coeur même des activités d’#apprentissage, fondé, dans le supérieur, sur des méthodes rigoureuses issues de la #recherche_scientifique (Voir aussi : https://www.polytechnique-insights.com/tribunes/digital/lia-generative-bouleverse-t-elle-les-pratiques-pedagogiques). Il est crucial d’apprendre à chercher et identifier les #sources, les vérifier, les comparer, les valider. Les étudiant·es demandent la plupart du temps à l’IAG de faire ce travail à leur place, n’apprenant donc pas à le faire. Pire : l’IAG est un intermédiaire qui masque les sources, d’autant que les outils d’IA gratuits qu’utilisent les étudiant·es offrent des possibilités limitées. On voit ainsi souvent des #bibliographies fictives, où une IA a associé des noms d’auteurs et d’autrices réels avec des titres d’ouvrages réels ou probables chez des éditions vraisemblables sauf que ces ouvrages n’existent pas : l’IAG a combiné des éléments probables. Exemple vécu : dans une #bibliographie de 25 titres d’un projet de mémoire de master en juin 2025, 23 étaient inventés.

    Même chose pour la #rédaction. Rédiger, ce n’est pas seulement livrer un produit fini, c’est surtout un processus à fonction cognitive qui concrétise la #pensée dans un #discours_organisé, et renvoie à la personne qui écrit son propre #discours à lire, la pousse à s’interroger sur les #termes justes et les #formulations nuancées. Quand on fait produire un texte à une #IAG, cette activité disparaît. On a du mal à identifier quels textes déjà disponibles en ligne l’IAG a pillés, mélangés, vidés de leurs spécificités, et donc à vérifier leur #cohérence et leur #validité. Or l’apprentissage de méthodes à usage autonome, c’est l’objectif majeur d’une formation supérieure. Et quand on utilise une IAG « seulement » pour « améliorer » la forme d’un texte, ce qu’elle sait plutôt bien faire, on court plusieurs #risques qui ne valent pas la #surconsommation_énergétique : perdre en cohérence entre le discours et la pensée qui l’a produit, donner la primauté à la forme sur le fond, uniformiser les modalités d’expression par l’application de #modèles_automatisés... L’une des constatations de l’enquête de 2025, c’est que « l’usage direct et sans encadrement d’une IAG est néfaste sur les apprentissages » (p.24).

    Cela ne signifie pas qu’aucun usage pédagogique pertinent ne puisse être fait d’une IAG, selon les domaines et de manière tutorée, notamment dans les domaines où l’IA fournit une #aide_technique de beaucoup plus haut niveau que ce que faisaient déjà des outils informatiques comme, par exemple, des tableurs ou des visions augmentées (télescopes ou microscopes). Mais, dès lors qu’il s’agit de contenus produits par la #pensée_humaine et utiles pour son développement, de domaines de connaissances où les textes occupent une place importante pour contextualiser dans la complexité du monde et produire prioritairement du #sens, la délégation à une machine crée davantage de manques qu’elle ne viendrait en combler.

    Exemple d’une soutenance de master

    Lors d’une soutenance de Master en Esthétique et Théorie des arts, sur l’insistance du jury, le candidat a admis avoir fait usage de l’IAG pour rédiger son mémoire. Le mémoire de 180 pages était rédigé sans la moindre erreur orthographique. Au niveau formel, rien à redire. Mais l’IAG compile, elle ne pense pas. Elle a en effet combiné des éléments probables d’information sans jamais attiser le désir de les vérifier, en entretenant l’#illusion_de_la_vérité. Elle a conduit à asséner des #généralités dont pas une ne pouvait résister à l’#esprit_critique. Pourtant, il n’y a que sur les pires chaînes de télévision que la compilation d’éléments information est donnée comme équivalente à un #argumentaire bien ficelé.

    Ainsi, pour développer et mettre en travail le concept d’habitus de P. Bourdieu, pourtant l’un des plus travaillés au monde, l’IA a proposé un falot manuel de sociologie pour débutant·es. Lorsque G. Bataille est cité, la référence de l’ouvrage ne comporte pas de numéro de page, l’IAG ne s’embarrassant pas de ces détails. Il fut donc impossible de vérifier s’il parlait effectivement (en 1957) de « ruptures des frontières corporelles dans la danse », ce qui serait très étonnant. L’IAG aura transformé la moindre idée porteuse de sens en #discours_indigent. Avec elle, la pensée propre à l’étudiant et son potentiel à problématiser ont cédé la place à la #banalité.

    Que faudrait-il changer face aux usages risqués de l’IA côté enseignement ? (Voir aussi : UNESCO, 2023, Guide pour l’IA générative dans l’éducation et la recherche : https://unesdoc.unesco.org/ark:/48223/pf0000389901)

    Malgré tout cela, il semble déjà difficile d’empêcher l’usage de l’AI par les étudiant·es.

    Auparavant, on était bien souvent dans une forme de dispositifs d’apprentissage implicites, avec des « raccourcis » grossiers dans la pertinence des évaluations (au risque d’ailleurs d’entraîner l’échec de tous les étudiant·es différent·es de la norme, sans les codes, etc.). La faute à la (non ?) formation à la pédagogie des enseignant·es du supérieur, mais aussi au manque de moyens. Également au déficit, dans l’évaluation de la carrière des E-C, de reconnaissance de l’expertise en enseignement, face à l’importance accordée aux activités de recherche.

    Si on veut garder un niveau d’apprentissage sérieux, relatif à ce qui peut s’ancrer durablement dans l’esprit de nos étudiant·es, on est donc face à la nécessité d’adapter nos #méthodes_pédagogiques. Le remède n’est pas forcément inaccessible. On doit s’assurer en détail que les étudiant·es travaillent pour de bon l’élaboration progressive d’une maîtrise des diverses #compétences et de leur articulation. On est donc forcés de faire une mesure plus fine de l’authenticité, des progressions dans le temps, plutôt que la simple #évaluation d’un résultat final. Tout cela va avoir un coût humain et logistique : organiser par exemple beaucoup plus de soutenances à l’oral, en présentiel et synchrone. Et devoir préciser et vérifier à chaque étape si l’IAG est acceptée ou non. Et si oui comment elle est utilisée...

    Il faudrait en somme mieux appliquer les pratiques adéquates standards de la pédagogie, comme l’alignement des dispositifs d’évaluation, par exemple. Tout cela requiert beaucoup d’efforts de la part des enseignant·es, et de moyens, des formations, un taux d’encadrement nettement plus massif. Il faut remettre plus d’humain dans la boucle. Hélas, ce n’est pas la tendance politique du moment. L’IAG porte la promesse magique de la #productivité — et il n’y a pas ou que peu d’alternatives puisque le marché en fourgue partout dans nos appareils et nos logiciels. Pourtant, si on veut former à l’#effort dans un monde de facilité, ça va coûter plus cher.

    https://cgt.fercsup.net/l-echo-du-sup/echo-du-sup-numero-11-juin-2026-l-ia-dans-l-esr-ou-l-esr-dans-l-ia/article/l-ia-dans-les-formations-superieures-beaucoup-d-effets-deleteres-et-peu
    #IA #AI #intelligence_artificielle #ESR #enseignement_supérieur #université #facs #pédagogie #à_lire
    • L’IA générative bouleverse-t-elle les pratiques pédagogiques ?

      En bref

      – Rendu public par OpenAI en 2023, GPT-4 a atteint des niveaux de performance comparables à ceux d’étudiants de second cycle sur des exercices de logique, de mathématiques et de rédaction académique.
      – Les #modèles_de_langage modifient la manière dont les étudiants mobilisent leur raisonnement et leur capacité analytique, ce qui peut mener à une fragilisation de leur plasticité cérébrale et de leur densification des réseaux neuronaux.
      – Lorsque assisté par l’IA, l’acquisition des connaissances peut être affaiblie dès qu’elle remplace systématiquement l’#effort_intellectuel : les productions écrites, le #travail_autonome et les modalités d’évaluation.
      – De nombreuses questions sur l’équilibre entre assistance algorithmique et #effort_cognitif humain sont soulevées, d’autant par la rapide évolution des modèles d’IA.
      – Des cadres commencent à émerger où l’IA n’est ni absente ni centrale, mais intégrée de manière différenciée selon les objectifs cognitifs poursuivis.

      **

      L’irruption de l’intelligence artificielle générative dans les systèmes éducatifs marque un tournant technologique. Contrairement aux plateformes d’apprentissage en ligne ou aux outils d’assistance pédagogique des années 2000 et 2010, les modèles de langage de grande taille produisent désormais des raisonnements structurés, synthétisent des corpus complexes et interagissent avec les apprenants de manière adaptative.

      GPT‑4, rendu public par OpenAI en 2023, a atteint des niveaux de performance comparables à ceux d’étudiants de second cycle sur des exercices de logique, de mathématiques et de rédaction académique1. D’autres architectures comme Claude d’Anthropic ou LLaMA de Meta confirment cette dynamique tout en explorant des stratégies de gouvernance des sorties génératives et de réduction des biais2.

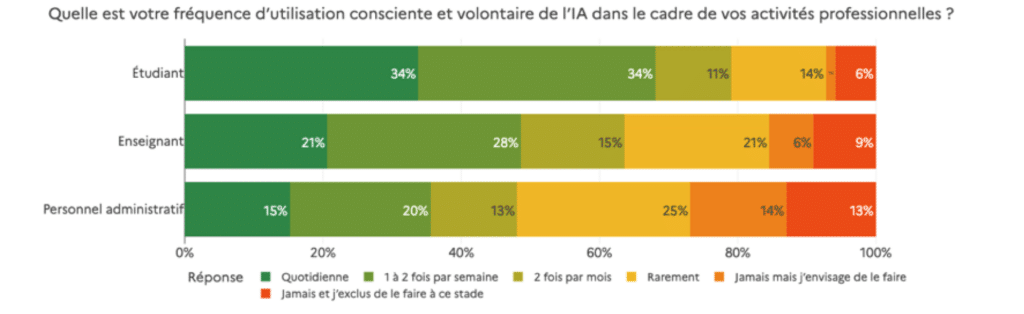
      Ces avancées offrent de nouvelles opportunités pour personnaliser les parcours, renforcer le tutorat individualisé et élargir l’accès aux ressources pédagogiques. Elles soulèvent toutefois des interrogations sur les fréquences d’utilisations (voir figure 1) et les conditions cognitives de l’apprentissage assisté par IA, car certaines dimensions de l’acquisition des connaissances peuvent être fragilisées lorsque cette technologie remplace systématiquement l’effort intellectuel3.

      Ces enjeux touchent directement des dispositifs clés de l’enseignement supérieur, tels que la production écrite, le travail autonome et les modalités d’évaluation. De plus, ces transformations appellent une approche combinant recherche académique et observation des pratiques pédagogiques.
      L’effort cognitif à l’épreuve des modèles génératifs

      Les modèles de langage de grande taille modifient la manière dont les étudiants mobilisent leur raisonnement et leur capacité analytique. GPT‑4, par exemple, atteint des performances comparables à celles d’étudiants de second cycle sur des exercices de logique, de mathématiques et de synthèse textuelle5. Cette portée soulève des questions sur l’équilibre entre assistance algorithmique et effort cognitif humain.

      « Le problème, dans le champ éducatif, apparaît lorsque l’étudiant utilise systématiquement l’IA pour réaliser un exposé, un mémoire, une dissertation ou même pour apprendre une notion » affirme Michel Barabel, maître de conférences à l’Université Paris-Est dont les travaux portent sur la transformation des organisations, en particulier la gestion des compétences, la formation professionnelle et les cultures apprenantes. La sous-traitance systématique peut nuire au développement de capacités cognitives essentielles. « Les travaux de recherche montrent que dans ce cas, le coût de l’effort cognitif augmente rapidement et que faire seul devient de plus en plus difficile ».

      Les cadres théoriques de la psychologie cognitive permettent d’éclairer ce phénomène. Les distinctions de Daniel Kahneman entre le cerveau de type 1, analytique et paresseux, et le cerveau de type 2, créatif et mobilisé dans la résolution de situations inédites, servent de référence. Barabel observe que « la grande promesse de l’IA est précisément de sous-traiter les tâches relevant du cerveau de type 1, simples et répétitives, afin de libérer du temps pour des activités de type 2 ». Son usage répété dans des tâches fondamentales du type 1 peut ainsi limiter la densification des réseaux neuronaux nécessaires à la créativité et à la pensée critique.

      Une comparaison avec d’autres usages technologiques illustre ce risque. « Cette dépendance pose une question centrale, celle d’un appauvrissement progressif des capacités cognitives », explique Barabel, faisant référence à des exemples observés dans d’autres contextes, comme la navigation des chauffeurs de taxi londoniens devenue dépendante du GPS. Les travaux en neurosciences montrent que l’apprentissage reposant sur un engagement cognitif actif favorise la plasticité cérébrale et la densification des réseaux neuronaux, tandis qu’une réduction durable de l’effort analytique limite ces mécanismes et fragilise la mobilisation des compétences dans des situations complexes6. « Or, on sait qu’il est très difficile de faire émerger une créativité authentique sans ce socle d’effort cognitif préalable », ajoute l’expert.

      Cette réflexion sur l’effort cognitif souligne que les effets de l’IA générative dépendent moins de la technologie que des modalités d’usage. L’usage réfléchi et régulé peut soutenir la créativité et la productivité, tandis qu’un usage passif peut compromettre le développement de compétences intellectuelles essentielles.
      Des recours pédagogiques en recomposition progressive

      La diffusion rapide des outils d’IA générative a rendu visibles des usages déjà largement installés chez les étudiants, souvent en dehors de tout cadre institutionnel. Plusieurs travaux montrent que ces outils sont mobilisés pour rédiger des exposés, structurer des mémoires ou préparer des évaluations, sans que les dispositifs pédagogiques aient été conçus pour en tenir compte7. Cette situation a conduit certains établissements à repenser non pas seulement la régulation, mais la nature même des activités proposées.

      D’après Michel Barabel, « la question ne peut se réduire à une opposition entre autorisation et interdiction. Le problème ne doit pas être posé en ces termes ». Il stipule que l’IA combine des potentialités pédagogiques fortes et des limites réelles. Dans les dispositifs qu’il observe, l’enjeu consiste à distinguer plusieurs formes d’activités selon le rôle attribué à la machine. « Certaines activités peuvent être totalement confiées à l’IA sans régulation particulière », notamment lorsqu’il s’agit de procédures ou d’aide méthodologique, tandis que d’autres doivent rester exclusivement humaines. « L’usage de l’IA y est interdit afin de préserver la relation pédagogique, le travail du cerveau de type 1 et la créativité et l’esprit critique ».

      Cette différenciation se traduit concrètement par des dispositifs de transparence. « À Sciences Po et à l’IAE Paris-Est, les étudiants doivent expliciter leur usage de l’IA dans une annexe dédiée. Nous autorisons son exploitation, mais nous imposons une annexe IA dans tous les travaux », précise Barabel. Cette exigence permet de déplacer l’évaluation du seul résultat vers le processus intellectuel mobilisé. « Le nouveau plagiat, pour nous, n’est pas d’utiliser l’IA, mais de l’utiliser sans le déclarer », ajoute-t-il.

      Les modalités d’évaluation ont également été ajustées pour tenir compte de ces pratiques. Barabel observe qu’« un exposé à rendre pour la semaine suivante a aujourd’hui une probabilité très élevée d’être produit à 60, 70, voire 90 % à l’aide de l’IA ». Dans ce contexte, « là où l’écrit pesait auparavant davantage, l’oral est désormais majoritaire », afin de vérifier la compréhension, l’appropriation des concepts et la faculté de l’étudiant à défendre son raisonnement.

      Entre délégation, assistance et augmentation, les applications pédagogiques se structurent ainsi autour d’un principe d’articulation. « Il existe des situations où l’IA assiste l’étudiant », note Barabel, tandis que dans d’autres configurations, « l’étudiant produit une première version et l’IA l’aide à l’améliorer par questionnement et suggestions ». Ces expérimentations dessinent progressivement un cadre où cette technologie n’est ni absente ni centrale, mais intégrée de manière différenciée selon les objectifs cognitifs poursuivis.
      Entre promesses d’augmentation et risques de fragmentation

      Les limites actuelles de l’IA générative en contexte éducatif tiennent moins à ses performances techniques qu’aux effets systémiques qu’elle induit sur les trajectoires d’apprentissage. Les bénéfices cognitifs observés dépendent fortement des conditions d’emploi, avec des résultats parfois contradictoires selon les protocoles expérimentaux[8]. Michel Barabel invite ainsi à la prudence dans l’interprétation des premières données disponibles. « Certaines études, notamment du MIT, ont montré une baisse rapide de certaines capacités cognitives, mais sur des échantillons très réduits et avec des protocoles discutables », rappelle-t-il, tout en notant que d’autres travaux mettent en évidence des effets positifs sur certaines compétences.

      Cette hétérogénéité des résultats renvoie à une question centrale, celle de l’intensité et surtout de la nature des utilisations. « Il pas certain qu’il existe un seuil universel », précise Barabel, en soulignant que « le problème réside davantage dans l’organisation des activités que dans le volume d’interaction avec l’IA ». Il propose un équilibre théorique dans lequel « le 100 % humain devrait représenter au moins 20 % des activités », afin de préserver les fonctions cognitives fondamentales liées à l’effort, à la réflexion autonome et à la construction du jugement.

      Au-delà des effets individuels, les chercheurs s’inquiètent de dynamiques d’inégalités susceptibles d’être amplifiées par les systèmes intelligents. Les écarts d’accès aux versions les plus performantes des modèles, souvent conditionnés par des abonnements payants, constituent un premier facteur de différenciation[9]. Barabel met en évidence le fait que « le capital économique des familles pourrait conditionner l’accès à des IA plus performantes, utilisées dans un cadre privé », créant un avantage cumulatif pour certains étudiants. À cela s’ajoutent les disparités institutionnelles. « Certains établissements disposent des moyens financiers et pédagogiques pour déployer des IA, former les enseignants et mettre en place des chartes éthiques. D’autres non ».

      Ces écarts matériels se doublent d’inégalités culturelles et cognitives. « Le risque majeur est alors l’accroissement des écarts entre étudiants », pointe Barabel, distinguant ceux qui utilisent l’IA de manière stratégique, ceux qui en font un usage mécanique et ceux qui réinvestissent le temps libéré dans des activités à forte valeur cognitive. Les recherches en sociologie de l’éducation montrent que ces mécanismes d’appropriation différenciée jouent un rôle déterminant dans la reproduction ou la transformation des hiérarchies scolaires8.

      Enfin, la rapidité d’évolution des technologies pose un défi structurel aux institutions éducatives. « Ce que nous disons aujourd’hui peut être remis en cause dans quelques mois par une nouvelle génération d’IA », signale Barabel. Cette instabilité technologique interroge la capacité des systèmes éducatifs à articuler innovation, équité et développement des compétences humaines fondamentales, dans un contexte où la production et la transmission des savoirs sont elles-mêmes en profonde recomposition.

      https://www.polytechnique-insights.com/tribunes/digital/lia-generative-bouleverse-t-elle-les-pratiques-pedagogiques

    • Le plus grand danger de l’IA à l’université n’est pas la triche, c’est l’érosion de l’apprentissage lui‑même

      L’intelligence artificielle promet de « libérer du temps » et d’optimiser l’apprentissage. Mais en déléguant aux machines les tâches qui formaient étudiants et jeunes chercheurs, les universités risquent d’éroder les conditions mêmes de l’expertise.

      Dans le débat public sur l’intelligence artificielle (IA) à l’université, une inquiétude revient en boucle : la tricherie. Les étudiants vont-ils confier leurs #dissertations à des #chatbots ? Les enseignants sauront-ils les démasquer ? Faut-il interdire ces outils sur les campus, ou au contraire les intégrer aux pratiques pédagogiques ?

      Ces questions sont légitimes. Mais à force de réduire le sujet à la #fraude_académique, on passe à côté de l’essentiel : une transformation beaucoup plus profonde est déjà à l’œuvre, qui dépasse largement les seuls comportements des étudiants – et même le cadre de la salle de classe.

      Les universités déploient désormais l’IA dans de nombreux aspects de leur fonctionnement. Certaines applications restent largement invisibles : des systèmes qui aident à répartir les ressources, à repérer les étudiants « à risque », à optimiser les emplois du temps ou à automatiser des décisions administratives routinières.

      D’autres usages sont, eux, beaucoup plus visibles. Les étudiants s’appuient sur des outils d’IA pour résumer des cours et réviser. Les enseignants les utilisent pour élaborer des sujets d’évaluation, préparer des syllabus. Les chercheurs s’en servent pour écrire du code, passer en revue la littérature scientifique ou condenser en quelques minutes des tâches fastidieuses qui prenaient auparavant des heures.

      On peut bien sûr utiliser l’IA pour tricher ou se soustraire à un devoir. Mais la multiplication de ses usages dans l’enseignement supérieur – et les bouleversements qu’ils annoncent – posent une question bien plus fondamentale : à mesure que les machines deviennent capables d’assumer une part croissante du travail de recherche et d’apprentissage, que devient l’université ? À quoi sert-elle encore ?

      Depuis huit ans, nous étudions les implications morales d’un recours massif à l’IA dans le cadre d’un projet de recherche conjoint entre le Applied Ethics Center at UMass Boston et l’Institute for Ethics and Emerging Technologies. Dans un livre blanc récent, nous soutenons qu’à mesure que les systèmes d’IA gagnent en autonomie, les enjeux éthiques de leur utilisation dans l’enseignement supérieur s’intensifient – tout comme les conséquences potentielles qui en découlent.

      À mesure que ces technologies deviennent plus performantes dans la production de travaux intellectuels – concevoir des cours, rédiger des articles, proposer des protocoles expérimentaux ou résumer des textes complexes – elles ne se contentent pas d’accroître la productivité des universités. Elles risquent aussi de vider de sa substance l’écosystème d’apprentissage et de mentorat sur lequel ces institutions sont fondées – et dont elles dépendent pour exister.
      IA non autonomes

      On peut distinguer trois types de systèmes d’IA et leurs effets respectifs sur la vie universitaire.

      Des logiciels alimentés par l’IA sont déjà utilisés dans l’enseignement supérieur pour l’examen des candidatures, les achats, l’accompagnement pédagogique des étudiants ou encore l’évaluation des risques institutionnels.

      On parle ici de systèmes « non autonomes » : ils automatisent certaines tâches, mais un humain reste « dans la boucle » et les utilise comme de simples outils.

      Ces technologies peuvent faire peser un risque sur la vie privée et la sécurité des données des étudiants. Elles peuvent aussi être biaisées. Et elles manquent souvent de transparence, ce qui rend difficile l’identification de l’origine de ces problèmes. Qui a accès aux données ? Comment sont calculés les « indices prédictifs de décrochage ou d’échec » ? Comment éviter que ces systèmes ne reproduisent des inégalités ou ne traitent certains étudiants comme de simples cas problématiques à gérer ?

      Ces questions sont sérieuses. Mais, au moins dans le champ de l’informatique, elles ne sont pas fondamentalement nouvelles. Les universités disposent en général de services de conformité, de comités d’éthique de la recherche et de mécanismes de gouvernance pensés pour anticiper ou limiter ces risques – même si, dans les faits, ils n’atteignent pas toujours pleinement ces objectifs.
      IA hybrides

      Les systèmes hybrides regroupent toute une gamme d’outils, parmi lesquels des bots conversationnels assistés par l’IA, des dispositifs de feedback personnalisé ou encore des aides automatisées à l’écriture. Ils reposent souvent sur des technologies d’IA générative, notamment sur de grands modèles de langage, les LLM. Si les utilisateurs humains fixent les objectifs généraux, les étapes intermédiaires que le système mobilise pour les atteindre ne sont, elles, généralement pas spécifiées.

      Ces systèmes hybrides façonnent de plus en plus le travail académique au quotidien. Les étudiants les utilisent comme compagnons d’écriture, tuteurs, partenaires de réflexion ou outils d’explication à la demande. Les enseignants s’en servent pour élaborer des grilles d’évaluation, préparer des cours ou concevoir des plans de syllabus. Les chercheurs les mobilisent pour résumer des articles, commenter des versions préliminaires, imaginer des protocoles expérimentaux ou générer du code.

      C’est ici que le débat sur la « tricherie » trouve véritablement sa place. Alors qu’étudiants et enseignants s’appuient de plus en plus sur ces outils pour se faire aider, il est légitime de s’interroger sur les formes d’apprentissage qui risquent de se perdre en chemin. Mais les systèmes hybrides soulèvent aussi des questions éthiques plus complexes.

      L’une d’elles concerne la transparence. Les chatbots d’IA proposent des interfaces en langage naturel qui rendent difficile de savoir si l’on échange avec un humain ou avec un agent automatisé. Cette ambiguïté peut être déstabilisante et source de distraction. Un étudiant qui révise pour un examen doit pouvoir savoir s’il s’adresse à son chargé de travaux dirigés ou à un robot. De même, un étudiant qui lit les commentaires sur son mémoire doit pouvoir identifier clairement s’ils proviennent de son enseignant.

      Tout manque de transparence dans ces situations risque d’aliéner les personnes concernées et de déplacer l’attention des interactions académiques : au lieu de se concentrer sur l’apprentissage, on se focalise sur les outils ou la technologie qui le médiatisent. Des chercheurs de l’Université de Pittsburgh ont montré que ces dynamiques suscitent chez les étudiants des sentiments d’incertitude, d’anxiété et de méfiance. Des effets loin d’être anodins.

      Une deuxième question éthique touche à la responsabilité et au crédit intellectuel. Si un enseignant utilise l’IA pour rédiger un sujet et qu’un étudiant s’appuie lui aussi sur l’IA pour produire sa réponse, qui évalue qui – et qu’est-ce qui est réellement évalué ? Si les retours sont en partie générés par une machine, qui est responsable lorsqu’ils induisent en erreur, découragent ou intègrent des présupposés invisibles ? Et lorsque l’IA contribue de manière substantielle à une synthèse de recherche ou à la rédaction d’un article, les universités devront établir des normes plus claires en matière d’autorat et de responsabilité – pas seulement pour les étudiants, mais aussi pour les enseignants-chercheurs.

      Enfin se pose la question cruciale de la « décharge cognitive ». L’IA peut réduire les tâches fastidieuses, et cela n’a rien de problématique en soi. Mais elle peut aussi détourner les utilisateurs des étapes de l’apprentissage qui construisent réellement les compétences : formuler des idées, traverser des moments de confusion, retravailler un brouillon maladroit, apprendre à repérer ses propres erreurs.
      Agents autonomes

      Les transformations les plus profondes pourraient venir de systèmes qui ressemblent moins à des assistants qu’à de véritables agents. Si les technologies pleinement autonomes relèvent encore en partie de l’aspiration, l’idée d’un « chercheur en boîte » – un système d’IA agentique capable de mener des études de manière indépendante – devient de plus en plus crédible.

      Ces outils dits agentiques sont présentés comme susceptibles de « libérer du temps » pour des activités mobilisant davantage des capacités humaines, comme l’empathie ou la résolution de problèmes. Dans l’enseignement, cela pourrait signifier que les enseignants continuent d’assurer les cours au sens formel, mais que la majeure partie du travail pédagogique quotidien soit déléguée à des systèmes optimisés pour l’efficacité et le passage à l’échelle. En recherche, l’avenir semble appartenir aux systèmes capables d’automatiser toujours davantage le cycle scientifique. Dans certains domaines, cela prend déjà la forme de laboratoires robotisés fonctionnant en continu, capables d’automatiser une grande partie des expérimentations et même de sélectionner de nouveaux tests à partir des résultats précédents.

      À première vue, cela peut sembler être un gain intéressant de productivité. Mais les universités ne sont pas des usines à produire de l’information : ce sont des communautés de pratique. Elles reposent sur un vivier de doctorants et de jeunes chercheurs qui apprennent à enseigner et à faire de la recherche en participant eux-mêmes à ces activités. Si des agents autonomes absorbent une part croissante des tâches « routinières » qui constituaient historiquement des portes d’entrée dans la carrière académique, l’université pourra continuer à produire des cours et des publications – tout en fragilisant silencieusement les structures d’apprentissage qui permettent, dans la durée, de former l’expertise.

      La même dynamique touche les étudiants de premier cycle, sous une forme différente. Lorsque des systèmes d’IA peuvent fournir à la demande des explications, des brouillons, des solutions ou des plans de révision, la tentation est grande de déléguer les aspects les plus exigeants de l’apprentissage. Pour l’industrie qui promeut l’IA dans les universités, ce type d’effort peut apparaître comme « inefficace » – et l’on pourrait penser que les étudiants gagneraient à laisser la machine s’en charger. Mais c’est précisément dans cette confrontation à la difficulté que se construit une compréhension durable. La psychologie cognitive a montré que les étudiants progressent intellectuellement en rédigeant, en révisant, en échouant, en recommençant, en affrontant la confusion et en retravaillant des arguments faibles. C’est cela, apprendre à apprendre.

      Pris ensemble, ces évolutions suggèrent que le principal risque lié à l’automatisation dans l’enseignement supérieur ne réside pas seulement dans le remplacement de certaines tâches par des machines, mais dans l’érosion plus profonde de l’écosystème de pratiques qui, depuis longtemps, soutient l’enseignement, la recherche et l’apprentissage.
      Un tournant risqué

      À quoi servent les universités dans un monde où le travail intellectuel est de plus en plus automatisé ?

      Une première réponse consiste à voir l’université avant tout comme une machine à produire des diplômes et des connaissances. Dans cette logique, la question centrale devient celle des résultats : les étudiants obtiennent-ils leurs diplômes ? Des articles sont-ils produits ? Fait-on des découvertes ? Si des systèmes autonomes peuvent générer ces résultats plus efficacement, alors l’institution a toutes les raisons de les adopter.

      Mais une autre réponse considère l’université comme bien davantage qu’une simple machine à produire des résultats. Elle reconnaît que la valeur de l’enseignement supérieur réside en partie dans l’écosystème lui-même : le continuum d’opportunités grâce auquel les novices deviennent experts, les structures de mentorat au sein desquelles se forment le jugement et le sens des responsabilités, et une conception pédagogique qui valorise l’effort et la confrontation à la difficulté plutôt que leur élimination au nom de l’efficacité.

      Dans cette perspective, l’enjeu n’est pas seulement de savoir si des connaissances et des diplômes sont produits, mais comment ils le sont – et quels types de personnes, de compétences et de communautés se construisent au passage. L’université y apparaît comme un écosystème dont la mission est, ni plus ni moins, de former durablement l’expertise et le discernement humains.

      Dans un monde où le travail intellectuel est lui-même de plus en plus automatisé, les universités doivent, selon nous, s’interroger sur ce qu’elles doivent à leurs étudiants, à leurs jeunes chercheurs et à la société qu’elles servent. Les réponses à ces questions détermineront non seulement la manière dont l’IA sera intégrée, mais aussi ce que deviendra l’université contemporaine.

      https://theconversation.com/le-plus-grand-danger-de-lia-a-luniversite-nest-pas-la-triche-cest-l
      #tricherie

  • L’#université à l’épreuve des machines

    Les #IA génératives n’ouvrent pas seulement un nouveau chapitre de la #fraude_académique. Elles déstabilisent plus profondément le #régime_de_preuve sur lequel l’université s’est longtemps reposée : nous avons pris des textes finis pour des signes d’#apprentissage. Lorsque des réponses plausibles deviennent triviales à produire, l’enjeu n’est plus de protéger des devoirs, mais de former et d’éprouver le #jugement.

    À l’été 1956, à Dartmouth, un petit groupe de chercheurs se réunit autour d’une hypothèse que beaucoup tenaient pour de la science-fiction : tout aspect de l’apprentissage pourrait, en principe, être décrit avec une précision suffisante pour être simulé par une machine. C’est là que fut forgée l’expression « #intelligence_artificielle ». Près de soixante-dix ans plus tard, les descendants de ce pari composent des textes, du code et des argumentaires avec une aisance qui peut passer, au premier regard, pour celle d’un esprit cultivé. La question qu’ils posent à l’université n’est pas seulement technique. Elle est institutionnelle : que certifions-nous au juste lorsque nous disons qu’un étudiant a appris ?

    On affirme volontiers que l’intelligence artificielle a créé une crise de l’#éducation. C’est inexact. Elle a surtout rendu impossible à dissimuler une confusion beaucoup plus ancienne. Pendant des années, les universités ont récompensé la #fluidité plus que la #compréhension, le poli plus que la profondeur, la #performance plus que le #jugement. Tant que produire un texte cohérent demandait du #temps, de l’#effort et une #compétence relativement rare, l’illusion tenait. Elle ne tient plus. Lorsqu’un étudiant peut obtenir en quelques minutes une #dissertation propre, structurée et plausible en donnant quelques consignes à un #modèle_de_langage, la vraie question n’est plus seulement celle de la #fraude. Elle est de savoir ce que nos exercices mesuraient réellement.

    J’en ai eu récemment une illustration simple. Un étudiant me présente un brouillon impeccable : phrases nettes, transitions soignées, argumentation apparemment maîtrisée. Je lui demande pourquoi une proposition découle de la précédente. Il hésite, puis se met à décrire le texte comme on décrirait un objet : ce qu’il contient, l’effet qu’il produit, l’usage qu’on peut en faire. Le #texte avait été généré avec l’aide d’un modèle, puis retouché. Il était correct. Il n’était pas habité. Ce qui frappait n’était pas l’usage de l’outil, mais la dissociation entre l’#aisance_verbale et le #travail_de_la_pensée. Le problème n’était pas seulement l’#auctorialité du texte ; c’était l’effondrement du lien entre la #production_d’un_écrit et la #preuve_d’un_apprentissage.

    Produire un résultat, former un jugement

    C’est ce lien que l’IA fragilise. L’université moderne a longtemps traité la #production_finie comme l’indice suffisant d’un travail intérieur : un devoir rendu, un commentaire composé, une note de synthèse, un mémoire. Or produire un résultat n’est pas former un jugement. Certaines opérations peuvent être déléguées parce qu’elles visent un objet extérieur : mettre en forme, résumer, reformuler, ordonner des matériaux. D’autres changent de nature dès qu’on prétend les déléguer : remarquer ce qui résiste, identifier une faille, peser une objection, décider qu’une conclusion ne suit pas, répondre de ce que l’on avance. Ces actes n’ont d’effet que si une personne les accomplit. Leur fin n’est pas seulement de produire un énoncé ; elle est de former celui qui l’énonce.

    Formulé autrement, le problème n’est pas d’abord qu’un texte généré puisse ressembler à un texte d’étudiant. Il est que l’institution ait peu à peu cessé de distinguer entre un artefact verbal convaincant et une pensée véritablement éprouvée. Ce que l’IA met en crise, ce n’est donc pas seulement l’#authenticité des copies ; c’est le type d’épreuve à partir duquel l’université prétend reconnaître une formation.

    Le cas français est ici instructif à condition de ne pas le mythifier. Certaines de ses formes les plus exigeantes – dissertation, khôlle, soutenance, oral de concours – ont longtemps reposé sur une intuition simple : un texte ne suffit pas, encore faut-il qu’un sujet en réponde. Mais la #massification_universitaire, la #bureaucratisation de l’#évaluation et la multiplication des #livrables ont, là aussi, restauré le règne du produit fini. L’intérêt de ces traditions n’est donc pas de fournir un refuge nostalgique. Il est de rappeler qu’une #épreuve_intellectuelle est d’abord un dispositif de mise en #responsabilité.

    On aurait tort d’y voir le privilège de quelques filières d’élite. La logique qui importe n’est pas sociale ; elle est épistémique : rendre visible, dans un échange, ce qu’aucun livrable ne montre à lui seul.

    L’ignorance de qualité

    Ce point vaut aussi pour la recherche. Le scientifique ne travaille pas seulement avec du #savoir_établi ; il travaille avec des #problèmes. Ou, selon la formule du biologiste Stuart Firestein, avec de « l’#ignorance_de_qualité » : une conscience disciplinée de ce qui #manque, de ce qui ne tient pas encore, de la question qui n’a pas trouvé sa forme définitive. L’image est celle d’un cercle qui s’élargit : plus le savoir croît, plus sa circonférence – c’est-à-dire la frontière avec ce que nous ne comprenons pas encore – s’étend. La #découverte ne vit pas au centre du cercle, dans l’archive stabilisée de ce qui a été établi. Elle vit à la périphérie, là où les #certitudes se dissolvent et où les #questions n’ont pas encore reçu de réponse.

    Je le vois au quotidien dans ma propre discipline, la biologie mathématique. Formuler une hypothèse féconde n’est pas un exercice de combinatoire sur ce qui est déjà publié. C’est un acte qui commence par une perception : quelque chose ne colle pas dans les données, un résultat établi n’est pas aussi robuste qu’on le croit, une question importante se dissimule derrière des formulations convenues. Cet acte de perception précède la méthode. Il suppose qu’un esprit ait séjourné assez longtemps dans l’#incertitude pour sentir, presque physiquement, où se trouve le problème digne d’être posé. C’est un travail de longue haleine, qui ne se transmet pas par simple énonciation.

    Les grands modèles de langage opèrent avec une virtuosité remarquable dans le domaine du déjà-dit. Ils synthétisent, recombinent, prolongent l’archive. Lorsqu’ils paraissent proposer une hypothèse nouvelle, ils remontent en réalité une hypothèse connue ou oubliée depuis l’intérieur de leurs données d’entraînement. Ils ne séjournent pas dans l’incertitude comme le fait un esprit engagé dans une #enquête. Ils ne sentent pas, de l’intérieur, qu’un raisonnement est creux malgré sa correction apparente. Ils peuvent étendre le discours ; ils ne peuvent pas assumer la responsabilité de la #vérité. Former des chercheurs, c’est former des esprits capables de se tenir à la circonférence du cercle. Ce n’est pas seulement leur transmettre ce qui est su ; c’est leur apprendre à habiter ce qui ne l’est pas.

    C’est pourquoi la #recherche n’est pas un supplément prestigieux à la mission pédagogique de l’université. Un enseignant qui travaille lui-même à la frontière du connu n’apporte pas seulement un stock de contenus : il introduit les étudiants à une certaine manière d’habiter l’incertitude, de formuler une objection, d’accepter qu’une bonne question vaille davantage qu’une réponse prématurée. L’université commence à perdre sa raison d’être lorsqu’elle sépare trop nettement #transmission, recherche et #jugement. Cette proximité avec la recherche n’est pas un luxe réservé à quelques-uns ; elle est la condition d’une université qui ne se contente pas d’administrer des connaissances.

    Les deux fausses sorties

    D’où l’insuffisance des deux réponses les plus répandues. La première est l’#interdiction : détecteurs, surveillance, inflation réglementaire. Elle est vouée à l’épuisement. Ces outils sont déjà trop présents pour être tenus durablement hors des salles de cours, et il serait absurde de former des diplômés condamnés à ignorer la technologie la plus structurante de leur époque. La seconde est la #capitulation_managériale : réduire l’université à une école d’adaptation où l’on apprend surtout à rédiger de bonnes consignes et à exploiter plus vite les outils. L’étudiant devient alors un opérateur. Dans les deux cas, on présuppose que la mission de l’université consiste avant tout à produire des réponses. C’est précisément ce que l’IA nous oblige à réexaminer.

    La bonne réponse est plus exigeante. Elle consiste moins à inventer une mission nouvelle qu’à rendre à l’université sa tâche propre : former le jugement en mettant les esprits à l’épreuve. Cela suppose davantage d’écriture en présence, davantage de défense orale des arguments, davantage de séminaires organisés autour de questions réelles plutôt que de réponses attendues. Une conversation de dix minutes suffit souvent à distinguer une idée comprise d’une idée seulement produite. Si l’étudiant utilise l’IA, qu’il le dise, qu’il en montre les traces, qu’il explique ce qu’il a gardé, écarté, reformulé, et pourquoi. L’enjeu n’est pas la police des usages ; c’est la responsabilité de l’énonciation.

    À Dartmouth, là même où l’expression « intelligence artificielle » fut inventée, nous commençons à intégrer ces outils non comme des raccourcis, mais comme des occasions de #rigueur. Dans certains séminaires d’écriture de première année, les étudiants peuvent demander à un modèle de proposer des contre-arguments ou des interprétations alternatives. Puis le vrai travail commence : annoter ce que l’outil a produit, repérer ce qui est inexact ou inventé, défendre à voix haute les choix retenus et ceux qui ont été écartés. Un étudiant est ainsi arrivé avec un paragraphe élégamment rédigé et une citation assurée. Lorsqu’on lui a demandé d’où venait la source, le silence s’est installé. Il a fallu remonter pas à pas le fil du texte généré, reconnaître que la référence n’existait pas, puis reprendre l’argument en nommant cette fois l’incertitude plutôt qu’en la recouvrant. L’outil avait accéléré la rédaction ; le séminaire a exigé le jugement.

    Le principe du #tutorat

    Paradoxalement, la solution la plus moderne est peut-être l’une des plus anciennes : le principe du tutorat. Il ne s’agit pas d’un artifice institutionnel hérité d’Oxford ou de Cambridge, mais d’une forme pédagogique dont la logique philosophique est beaucoup plus ancienne. La #disputatio médiévale, l’#entretien_socratique, la soutenance de thèse – toutes ces pratiques partent d’une même intuition : la pensée véritable se manifeste et se vérifie dans le #dialogue, lorsqu’un esprit doit répondre à la question qu’un autre esprit lui pose.

    Ce que le tutorat met à l’épreuve n’est pas la mémoire, ni même la qualité du texte préalablement rédigé. C’est la capacité de l’étudiant à habiter son propre #argument : à en suivre les implications lorsqu’elles sont contestées, à reconnaître les points où il avait escamoté la difficulté, à reformuler en temps réel lorsqu’une objection oblige à préciser. Cette épreuve ne peut être simulée. Non parce que la machine manquerait d’intelligence, mais parce que l’acte dont il s’agit est, par sa nature même, celui d’une personne qui répond de ce qu’elle a dit.

    Un étudiant écrit, puis s’assoit face à un enseignant ou à un chercheur et soutient son #argumentation dans une #conversation. Il devient alors difficile de se cacher derrière l’élégance de surface. Une machine peut fournir un texte ; elle ne peut ni répondre de ce qu’elle affirme, ni porter la responsabilité d’une idée. Ce n’est pas un archaïsme pédagogique. C’est peut-être, dans l’âge des machines à réponses, la forme la plus contemporaine de l’exigence universitaire.

    Généraliser ce principe ne suppose pas de copier la forme sociale du tutorat anglais. Il s’agit d’en adopter la logique : des séminaires qui culminent dans une #défense_orale ; des laboratoires où l’étudiant doit expliquer ce qu’un résultat dit et ce qu’il ne dit pas ; une pédagogie de l’écriture qui rend visible le travail de #révision et exige que l’étudiant assume ses #choix. Dans le monde français, les traditions de la dissertation orale, de la khôlle et de la soutenance fournissent des points d’ancrage précieux. Elles ne sont pas à ranger au musée. Elles sont à réactiver.

    L’université et le jugement démocratique

    Les enjeux de cette redéfinition dépassent de beaucoup les murs de l’université. L’IA amplifiera tout à la fois le savoir et le bruit, la productivité et la manipulation, la connaissance et la #désinformation. Dans un tel environnement, la compétence la plus précieuse n’est pas celle de produire rapidement des énoncés vraisemblables – les machines le feront toujours mieux que nous. C’est celle d’évaluer ce que l’on reçoit, de distinguer un argument d’une #rhétorique, de reconnaître les signes d’une fabrication, et de changer d’avis sans humiliation lorsque les preuves l’exigent.

    Aucune #démocratie ne survit à long terme si ses citoyens confondent la fluidité d’un énoncé avec sa vérité. Or la fluidité, désormais, est gratuite. Dans les mois qui viennent, elle sera mise au service aussi bien du commerce que de la propagande, de la science que du charlatanisme, de la délibération publique que de l’influence algorithmique. Les institutions qui forment des esprits capables de résister à cette saturation – qui apprennent à peser, à #douter, à #réviser – jouent donc un rôle civique que l’on ne peut pas sous-traiter. L’université est la première de ces institutions, non par privilège, mais par fonction.

    Cette fonction n’est pas nouvelle. Elle est consubstantielle à l’idée d’#enseignement_supérieur telle qu’elle s’est formée dans la tradition européenne : former des personnes capables de peser des #preuves, d’articuler une #conviction, et d’en porter la #responsabilité_publique. Ce que l’IA met en demeure, ce n’est pas cette tradition ; c’est la dérive qui a, dans trop d’institutions, substitué à la formation du jugement la certification de productions.

    Ce qui se déplace

    L’université n’aura pas à rivaliser avec les machines sur le terrain des réponses. Elle perdrait d’avance, et ce serait une erreur de terrain. Son avenir dépend d’autre chose : sa capacité à redevenir le lieu où l’on apprend non seulement à produire des énoncés plausibles, mais à en répondre. À mesure que les réponses deviennent abondantes, la rareté se déplace. Elle ne réside plus dans l’#information, mais dans la formation d’un esprit capable d’assumer un jugement, de l’exposer à la #contradiction, de le réviser et d’en porter la responsabilité.

    C’est dans ce déplacement que se joue l’avenir de l’institution. Les universités qui persisteront à produire des diplômes au sens administratif – des certificats adossés à des livrables acceptables – trouveront dans l’IA un concurrent imbattable et un révélateur. Celles qui redécouvriront leur tâche propre – former des esprits capables de juger – découvriront que la technologie qui semblait les menacer avait en réalité clarifié leur mission. L’âge de la machine à réponses est peut-être, paradoxalement, celui où l’université retrouve ce pour quoi elle a été faite.

    https://aoc.media/analyse/2026/05/12/luniversite-a-lepreuve-des-machines
    #AI #intelligence_artificielle #à_lire

    –—

    Je retiens notamment :

    D’où l’insuffisance des deux réponses les plus répandues. La première est l’interdiction : détecteurs, surveillance, inflation réglementaire. Elle est vouée à l’épuisement. Ces outils sont déjà trop présents pour être tenus durablement hors des salles de cours, et il serait absurde de former des diplômés condamnés à ignorer la technologie la plus structurante de leur époque. La seconde est la capitulation managériale : réduire l’université à une école d’adaptation où l’on apprend surtout à rédiger de bonnes consignes et à exploiter plus vite les outils. L’étudiant devient alors un opérateur. Dans les deux cas, on présuppose que la mission de l’université consiste avant tout à produire des réponses. C’est précisément ce que l’IA nous oblige à réexaminer.

    La bonne réponse est plus exigeante. Elle consiste moins à inventer une mission nouvelle qu’à rendre à l’université sa tâche propre : former le jugement en mettant les esprits à l’épreuve. Cela suppose davantage d’écriture en présence, davantage de défense orale des arguments, davantage de séminaires organisés autour de questions réelles plutôt que de réponses attendues. Une conversation de dix minutes suffit souvent à distinguer une idée comprise d’une idée seulement produite. Si l’étudiant utilise l’IA, qu’il le dise, qu’il en montre les traces, qu’il explique ce qu’il a gardé, écarté, reformulé, et pourquoi. L’enjeu n’est pas la police des usages ; c’est la responsabilité de l’énonciation.

  • A Lyrical Cruise in Tunis

    Urban scholars spend at least a decade thinking about the cities they research from the time they identify a research problem to the time they publish their manuscript. But we rarely find published those initial thoughts that are as much about misunderstanding as about comprehending the cities we turn into research projects. This essay is based on field notes from my first summer of pre-dissertation fieldwork in Tunisia, May to July 2014. I use pseudonyms to protect the identity of my interlocutors. The current version is loyal to my mis/understandings of Tunis then. I have not added new information to the body of the text though I continue to live in and research the city.

    https://www.jadaliyya.com/Details/34396/A-Lyrical-Cruise-in-Tunis

    #Tunisia #Tunis #field_notes #dissertation #PhD #city

  • Un gros problème méthodologique d’exposition d’un cours de philosophie

    J’ai de sérieuses difficultés avec la manière dont je dois présenter de nombreuses partie de cours de philosophie.
    Une partie de la philosophie, doit se présenter comme quelque chose proche de l’Histoire : ce que d’anciens auteurs on dit.
    Cependant ce n’est pas seulement de l’histoire, ce sont des Idées, et des Idées que l’on lie a des questions contemporaines, sur laquelle éventuellement la science dit autre chose (et c’est bien souvent le cas).
    Mon côté sceptique me fait inévitablement rappeler a chaque fois les aspects faux de ces idées la. Ce qui au pire crée un questionnement chez l’élève du type : mais si c’est faux pourquoi on nous l’a appris ? Ce a quoi je ne peux pas dire grand chose, si ce n’est tout ceci sont « des propositions », vous n’avez pas a être d’accord avec, juste a les connaître, et justement elle vous permettrons éventuellement par opposition de valoriser votre avis différent.

    Seulement voila. Parfois, c’est « full of bullshit »... Par ex. La thématique de l’inconscient. C’est censé débordé de psychanalyse et de Freud. Alors oui, je passe mon temps a montrer les lettres, que la science a montrer que ceci est faux etc.
    Mais les élèves doivent quand même retenir certains aspects qui vont être « bien considéré » : tient vous avez su ré-expliquer le complexe d’oedipe. C’est bien, vous l’avez bien rendu, on comprend bien... Mais leur réfutation, ou critique éventuelle, ne sera pas apprécié a leur même valeur, puisqu’il n’y a pas d’auteurs philosophique qui tiennent l’idée inverse... Enfin, si dans ce cas il y a Popper, mais il parle de la psychanalyse en général, pas du complexe d’oedipe et de toute façon, il présente une critique, mais pas vraiment un autre point de vue positif.

    Ce qui fait que je rencontre a minima 2 problèmes en suivant « le guide de la réfutation ». Celui-ci explique comment faire de bonne réfutation vis a vis de ce que retiendra le cerveau, les présenter etc.
    Il dit notamment :
    1.Que le mythe que l’on veux dénoncer doit prendre peu de place. Hors, si ils doivent bien présenter la psychanalyse dans leur dissertation, il faut que ça prenne une certaine place dans le cours... D’ailleurs si il ne parle pas de la psychanalyse de quoi parlerons t’il sur un sujet comme l’inconscient. Bien sur je leur est présenté l’avis des dernières recherches en psy cogn, mais je ne m’attends pas a voir des élèves de terminale me citer une étude et en faire matière a disserte...
    2.Qu’il faut proposer au mythe une autre idée qui puisse s’y substitué et être aussi facile a retenir dans les principes.
    Même problème tout ceci est très contemporain. Comment faire ? Dois je leur faire aussi en même temps qu’un cours de philo, un cours de physique ou de psychologie etc. Selon le sujet. D’ailleurs, est-il même possible que j’en sois capable ?

    Si vous avez des idées...