• La gauche doit-elle céder au chant de l’IA générative ? Non !
    https://danslesalgorithmes.net/stream/la-gauche-doit-elle-ceder-au-chant-de-lia-generative-non

    « Depuis que le camp de l’émancipation a renoncé à combattre l’aliénation et a adopté les « innovations » du capital en les saluant comme des progrès, il ne cesse de multiplier les défaites. Parce que, précisément, ces innovations garantissent une passivité face à la réalité capitaliste qui sape les bases de toute tentative sérieuse […]

  • #Sit-in, #cocktail_Molotov, #intrusions... La fronde anti-IA en pleine expansion

    Des #blocages pacifiques aux #menaces_physiques, le rejet des algorithmes s’intensifie aux Etats-Unis et ailleurs. Face à la #colère, les géants de la Silicon Valley revoient leur copie en matière de sécurité.

    C’est un logo, simple, que l’on croise de plus en plus souvent. Deux lettres à l’intérieur d’un cercle barré : « IA ». En Australie, des milliers d’employés de l’université de Sydney se sont mis en #grève fin août pour exiger une protection de leur emploi face à cette technologie. En Angleterre, des centaines de manifestants ont défilé à Londres en mars en demandant à être « débranchés ». En France, un piquet d’activistes a même brandi cet été slogans et pancartes au pied de la société parisienne #Mistral. Contre les algorithmes, la #fronde s’intensifie. Mais nulle part elle ne culmine autant qu’aux Etats-Unis.

    Inquiétudes pour l’emploi, bafouement des droits d’auteur, crainte d’une « perte de contrôle »… 52 % des Américains se disent plus inquiets qu’enthousiastes face à la place croissante de l’IA dans leur vie, estime une étude du Pew Research Center. De fait, les actions se diversifient outre-Atlantique, entre résistances écologiques aux #centres_de_données, campagnes de neutralisation des caméras algorithmiques et grèves syndicales historiques de secteurs bouleversés, à l’image de Hollywood. Mais ces derniers mois, ce sont les bureaux des géants de la Silicon Valley qui sont régulièrement ciblés.

    Habillés en agents IA « hors de contrôle », des militants ont semé en août une joyeuse zizanie dans des locaux d’OpenAI près de Seattle. Une opération symbolique, à base de ballons gonflables, de danse du robot et de saute-mouton dans l’entrée. Au siège de San Francisco, un petit groupe d’#activistes équipé de chaises de camping occupe depuis un mois le trottoir devant le bâtiment. Symbole de son ampleur, la #contestation connaît aussi ses premières fois. Cet été, #Wynd_Kaufmyn, une enseignante de Berkeley âgée de 69 ans, est devenue la première militante anti-IA à être condamnée à une peine de prison (14 jours). Elle avait, l’année précédente, enchaîné les portes de la maison-mère de ChatGPT.

    Fascination

    A l’origine de la plupart de ces actions, deux groupes : #Pause_AI et #Stop_AI. Apparus respectivement aux Pays-Bas en 2023 et en Californie en 2024, tous deux réclament une pause dans le développement des modèles les plus puissants. Au cœur de leurs inquiétudes ? Les « risques existentiels », l’idée que l’IA pourrait amener une catastrophe mondiale voire l’extinction de l’humanité en favorisant l’apparition d’armes autonomes ou d’attaques informatiques surpuissantes. Une théorie controversée au sein de la communauté scientifique. Et, ironiquement, un discours alarmiste que les grands patrons de l’IA cultivent également, avec un objectif marketing en tête : entretenir la fascination autour de leurs produits.

    Outre les actions pacifiques, ce climat anxiogène enregistre déjà quelques dérives. Au printemps, un vingtenaire, persuadé de l’imminence d’une techno-apocalypse, a été arrêté après avoir lancé un cocktail Molotov sur la maison du créateur de ChatGPT, Sam Altman. Dans ses affaires, un manifeste prônant la mort des grands patrons de l’IA avait été retrouvé. Inculpé pour tentative de meurtre, le Texan a plaidé non coupable, affirmant souffrir d’une psychose aiguë au moment des faits.

    « Menace terroriste »

    Concurrent direct d’OpenAI, Anthropic aussi a été pris pour cible. Un homme, qui avait postulé sous un faux nom à un emploi au sein de la société de Claude, menaçait en ligne d’écorcher vifs les enfants de ses employés. Une « punition » pour avoir volé son travail, rapportait en juillet le Wall Street Journal. L’incident, qualifié de « menace terroriste » par les autorités, n’a donné suite à aucune arrestation.

    Pour calmer le jeu, certains dirigeants de l’IA chercheraient donc à tempérer leurs discours, affirme le quotidien économique. D’autres auraient opté pour une garde renforcée et armée. En outre, le budget sécurité des grandes boîtes tech se serait envolé. En 2025, Palantir Technologies a déboursé 3 millions de dollars (+ 150 % en un an) pour assurer la protection de ses dirigeants, Salesforce 4 millions (un million de plus qu’en 2024) et Oracle près de 6 millions (+ 85,5 %).

    Quant aux employés ? A la fin de la journée, OpenAI leur conseille désormais de retirer leur badge et tout vêtement à l’effigie de la boîte, rapporte Wired. Une bascule historique pour la Silicon Valley, qui laissait jusqu’ici ses milliardaires circuler sans escorte et ses ingénieurs arborer leurs logos comme des médailles.

    https://www.liberation.fr/economie/economie-numerique/sit-in-cocktail-molotov-intrusions-la-fronde-anti-ia-en-pleine-expansion-
    #AI #IA #intelligence_artificielle #action_directe #résistance #anti-IA

    • #Pause_IA

      Pour garder l’IA sous contrôle,
      agissons maintenant

      Chaque mois, de nouveaux systèmes franchissent des seuils que l’on pensait lointains. Les experts alertent : sans garde-fous, cette course fait peser un risque catastrophique à court terme.

      La fenêtre se referme, agissons maintenant.

      https://pauseia.fr/fr

    • Young adults in the U.S. are increasingly wary of AI, concerned it will take jobs

      Americans have become increasingly worried about artificial intelligence over the years, and young adults’ concern has continued to climb. Worry over job loss, too, is on the rise.

      Today, 52% of Americans say they are more concerned than excited about the increased use of AI in daily life – up from 37% in 2021. Another 9% are more excited than concerned and 37% say they’re equally excited and concerned, according to a Pew Research Center survey conducted June 22-28, 2026.

      Concern about AI is up among younger and older Americans alike since we first asked this question in 2021. But while the rise was mainly in the first two years for Americans ages 30 and older, concern continues to climb for adults under 30 – whose skepticism of AI has made headlines in recent months.
      For the first time, a majority of adults under 30 (55%) now say they’re more concerned than excited about AI. About one-in-ten say they’re more excited than concerned, and roughly a third feel both equally. Their concern is now on par with those in their 30s and 40s, and those 65 and up.

      Across age groups, about half or more say they’re more concerned than excited about AI. Excitement, in turn, has dropped off since 2021 among all age groups.

      AI and jobs

      Even in 2021, job loss was one of the top reasons behind Americans’ concern about AI. Today, Americans largely – and increasingly – think AI-related job loss is on the horizon.

      In our new survey, 71% of adults think AI will lead to fewer jobs in the United States over the next two decades, up from 64% in 2024. Few (5%) say AI will lead to more jobs. One-in-ten say it won’t make much difference, and a slightly larger share are unsure.

      Across most age groups, it’s become more common for Americans to foresee job loss from AI. For example, 73% of adults under 30 now say AI will lead to fewer jobs, up from 61% two years ago.

      The youngest adults are now just as likely as those ages 30 to 64 to hold this view. Americans 65 and older are a bit less likely to think AI will lead to fewer jobs, though this is still the majority view among this age group.

      Worry over job loss has shown up throughout our research about AI, including among workers and even teenagers. And there’s no shortage of expert debate – many warn AI is a threat to jobs, while others have argued it creates them.

      Young adults aren’t the only ones concerned about AI’s increasing use in daily life, or about job loss. Still, our past work shows they stand out in other ways.

      Adults under 30 are most likely to think AI will be bad for society – and for them. They largely think it will make connection and creativity harder to come by. And though most say they use chatbots, they’re just as likely to say these tools hurt their own creativity as help it.

      https://www.pewresearch.org/short-reads/2026/08/18/young-adults-in-the-us-are-increasingly-wary-of-ai-concerned-it-will-ta
      #travail #sondage

  • G. Clavier sur mastodon autour de l’IA dans l’éducation

    J’ai fait une petite intervention auprès de #Sud Éduc 14 suite à l’invitation d’un camarade sur le sujet de l’#IA dans l’éducation au sens large.

    Vu que certain·es camarades étaient intéressé·es, notamment pour avoir des arguments à opposer aux directions et aux collègues, je mets mes diapos ici en libre accès, il y a aussi la présentation que j’ai faite à nos étudiant·es de première année :

    https://unicloud.unicaen.fr/index.php/s/PJjBezn3A6XeYqR

    J’ai bénéficié des discussion et des interventions de mes camarades @sornette (ma partner in crime. j’ai aussi mis tes diapos, si ça te déplait je les retire) et de @p4bl0 qui sont gentiment venus causer du sujet à Alençon.

    Ma conclusion étant littéralement : touchons de l’herbe et organisons nous.

    Pour télécharger les présentations :
    https://unicloud.unicaen.fr/index.php/s/PJjBezn3A6XeYqR
    #ESR #enseignement #AI #intelligence_artificielle #à_lire #éducation #présentation #ppt

  • « Mais alors, vous êtes pour la traduction automatique ? »

    Réponse à quelques arguments courants en faveur de l’intelligence artificielle générative (9)

    Le 1er décembre 2025, l’Atelier d’écologie politique de Toulouse lançait un manifeste, aussitôt signé massivement par des membres de l’enseignement supérieur et de la recherche (ESR) et de l’éducation nationale (EN) déclarant adopter une posture d’objection de conscience face au déploiement des technologies d’IA générative (IAg) dans leurs institutions. Le manifeste, que nous vous incitons à signer, justifie cette position par trois considérations majeures : le gouffre énergétique et matériel qu’implique le développement de l’IA, et dans le contexte de crise climatique, son caractère écocidaire ; les désastres sociaux, géopolitiques, économiques qu’engendre cet accélérateur des infrastructures industrielles ; enfin le futur dystopique (désinformation, dépendance, attaques contre la démocratie…) que nous promettent les mégafirmes aux commandes du développement de l’IA. Depuis le lancement de ce manifeste, l’Atecopol (Atelier d’Écologie Politique de Toulouse) s’est lancé dans un travail politique et pédagogique non seulement remarquable mais absolument indispensable. Nous n’entrevoyons qu’une minime partie des conséquences que pourrait avoir l’éclatement de la bulle financière liée à l’IA, mais les manifestations du réchauffement climatique – qu’accélèrent à une vitesse inouïe les data centers nécessaires à l’IA – sont, cet été, d’ores et déjà très concrètes. C’est ce qui nous amène à reproduire, avec son autorisation, l’argumentaire détaillé produit par l’Atecopol. Comprenant 12 réponses à des objections entendues régulièrement (au-delà de la cantine ou de la salle des profs), il constitue un outil précieux pour mener le combat contre l’adhésion à toutes sortes de mythes et de mensonges. Il contribue aussi et surtout à construire un autre imaginaire politique, à dessiner un monde différent que celui que nous promet l’IA : entreprise à laquelle le Collectif Les mots sont importants s’associe pleinement.

    Ce qu’en pensent les traducteurs et traductrices professionnelles.

    Plusieurs traducteur·ices nous ont interpellé·es sur la phrase suivante du manifeste : « Nous sommes par ailleurs conscient·es que le terme « IAg » recouvre des applications très diverses, dont certaines sont déjà largement intégrées à nos pratiques, telles que la traduction ou la transcription automatique. » Cette phrase ne visait pas à cautionner ces pratiques en soi (des « exceptions » qui seraient légitimes), mais prenait acte du fait que certains usages d’IAg avaient déjà produit une sorte d’effet de cliquet dans nos institutions. Il s’agit notamment de trois usages : i) le peaufinage de textes en anglais rédigés par des scientifiques avant publication, ii) la traduction de pages web dans des langues complètement inconnues de nous, pour pouvoir les lire, et iii) la transcription automatique d’entretiens en sociologie, qui semble s’être imposée comme norme dans certains laboratoires. Nous ne pensons pas que les individus puissent à eux seuls défaire les verrouillages technologiques, et nous voulions signifier que l’objection de conscience face à l’IAg n’implique pas de se défaire personnellement de tous les attachements qui ont été produits dans ces institutions ou qui le seront. Cela étant dit, les usages de traduction et transcription par IAg posent des problèmes profonds dont nous n’avions pas forcément conscience en écrivant cette phrase. Les traducteur·ices qui nous ont interpellé·es considèrent ainsi que les trois usages cités sont problématiques. Nous souhaitons relayer ici leurs arguments, qui nous semblent justes et méritent d’être connus. Leur texte ci-dessous décrit également plus largement la problématique liée à la traduction face à la vague de l’IAg. Il a été écrit par des traducteur·ices des collectifs En Chair et En Os et IA-lerte générale.

    Faut-il faire des exceptions ?

    Le passage du manifeste sur la traduction peut être compris comme la suggestion que certains usages de l’IAg seraient « moins graves » que d’autres et que des « exceptions » pourraient leur être accordées dans l’objection de conscience. Contre cette idée, et d’autant plus peut-être que le manifeste prend les limites planétaires comme point de départ, il nous semble difficile de ménager des exceptions à l’usage quotidien de l’IA, comme si la traduction ou la transcription vocale constituaient moins un « gouffre énergétique et matériel » (nous reprenons les termes du manifeste) que les autres usages de l’IA. Au « caractère écocidaire » de l’IA doit aussi s’ajouter son coût social (des travailleureuses des mines à celleux des data centers). Si l’on doit absolument prévoir des « exceptions », cela ne doit-il pas se faire à l’aune d’une étude bénéfices-risques pour l’humain et pour la planète ?

    La question de l’emploi

    Le caractère « moins grave » de l’usage de la traduction automatique est parfois défendu au motif que celle-ci n’intervient généralement pas en remplacement d’un·e traducteurice de métier mais pour des situations ponctuelles et bénignes. Or, même dans un tel cas, l’entraînement des modèles de langage repose sur des données produites par des personnes. On sait qu’une partie de ces données ont été volées (par exemple, Meta a admis avoir entraîné son modèle sur une base de données de livres piratés, et c’est probablement le cas pour Mistral aussi. Mais même lorsque les données ont été acquises « légalement », leur exploitation repose sur une exception au droit d’auteur (« exception TDM » de 2019) dont la légitimité et la cohérence avec la Convention de Berne (qui régit le droit d’auteur) sont remises en cause. TOUTE sortie machine, qu’il s’agisse de « traduction » ou plus largement de génération de texte, repose donc sur l’exploitation illégitime et possiblement illégale de données sous droit d’auteur. Par ailleurs, toute utilisation de la traduction automatique donne de la légitimité à cet outil, et participe donc à la disqualification des traducteur·ices et à la dégradation de leurs conditions de travail et de rémunération. Cela rend caduc l’argument selon lequel « ça ne vole le travail de personne ».

    Les cas i) et ii) (peaufinage d’un texte écrit en anglais, et traduction de pages web) posent la question de la capacité des chercheur·euses à analyser de manière critique la traduction ou correction produites. On peut supposer qu’ils ont recours à l’IA parce qu’ils n’ont pas confiance en leurs compétences linguistiques, sont structurellement débordés et espèrent gagner du temps. Dans ces conditions, ils seront tentés de « croire » aveuglément au texte produit par l’IA et ne seront pas en mesure d’en déceler les problèmes – qui existent. D’ailleurs, sans cette foi accordée à la sortie machine, il n’y a pas de raison d’y recourir puisque c’est extrêmement fatiguant de repasser derrière. Rien ne garantit donc que la sortie machine, en particulier sur le travail spécialiste et très ciblé des collègues, soit plus satisfaisante que la rédaction d’un·e collègue plus ou moins à l’aise dans la langue cible. Pourquoi ne pas admettre qu’un texte écrit dans une langue qui n’est pas la langue maternelle du chercheur n’a pas à être parfait (et qu’on n’a pas forcément besoin que tout soit en « anglais international », d’ailleurs) ?

    Le cas ii) pose également la question des langues « minorisées ». Si elles sont toutes « traduites » en anglais, elles cesseront alors inéluctablement d’être des langues d’expression scientifique, et la légitimité de la recherche dans ces langues « rares » en souffre. Or le multilinguisme (des scientifiques et en général), et la traduction humaine de l’état de l’art, est bien plus désirable que l’illusion de la transparence des langues que permettrait la traduction-machine.

    Pour le cas iii) (transcription des entretiens), nous ne sommes pas sociologues et nous garderons donc de répondre sur cette question. Un très bon interlocuteur en la matière serait le sociologue Juan Sebastian Carbonell, qui vient de sortir un livre sur l’IA (Un taylorisme augmenté, Amsterdam). Une transcriptrice décrit ici son travail et explique en quoi il se différencie d’une transcription automatique. De manière générale, il faut se méfier de l’idée que l’IA a « tout changé » : ce qu’elle a changé, c’est surtout l’acceptabilité sociale de l’automatisation totale de certaines tâches.

    L’argument du gain de temps

    En général, il faut s’interroger sur l’impression de gain de temps, l’illusion d’optique qui consiste à croire qu’il est moins chronophage de corriger un texte existant que de faire le travail soi-même. Cette impression vient beaucoup du côté « rassurant » d’avoir un texte devant soi plutôt que de partir d’une page blanche. Et c’est d’autant plus rassurant qu’on est par ailleurs fatigués, angoissés… Cela vaut pour les collègues comme pour les étudiants. Pour ce qui est de la traduction, la profession est unanime quant au fait que la post-édition (correction de sorties machines) ne représente aucun gain de temps significatif, mais une grande perte de sens et de bien-être au travail.

    Dans un contexte universitaire, si le recours aux IAg dans nos professions semble si séduisant malgré tout, c’est parce que nous n’avons plus le temps de faire correctement notre métier. Nous croulons sous les tâches annexes et, pour des choses qui relèvent de notre cœur de métier, nous devons aller plus vite, parce que nous avons une exigence de rentabilité. La question n’est pas de « gagner » du temps (en lâchant sur la qualité), mais de réfléchir à quoi serait occupé ce temps prétendument « gagné » : à répondre à plus de mails et d’appels à projets (rédigés et évalués par IA), à corriger plus de copies, à faire des heures sup de cours payées en-dessous du SMIC, à publier ET périr à petit feu ? Nos désirs de concession à l’IAg ne sont qu’une conséquence du publish or perish et de la dégradation de nos conditions de travail.

    Repenser la communauté universitaire ?

    Plutôt que de céder aux sirènes de l’IAg, peut-être faudrait-il repenser l’esprit de coopération au sein de la communauté universitaire, et nous entraider davantage en mutualisant nos compétences (par exemple linguistiques), notamment au sein des labos. Cela demande du temps, ainsi qu’une reconnaissance et une valorisation de cet effort collaboratif. Là où l’IAg a pour but de détricoter les liens sociaux, accepter notre dépendance vis-à-vis des autres (collègues qui nous aident, professionnels qu’on rémunère…) nous semble un modèle plus sain, plus propre aussi à la diffusion des compétences (comme le plurilinguisme) — un modèle pluriel, incarné, qui n’efface pas toutes les compétences et limites individuelles derrière la puissance algorithmique.

    https://lmsi.net/Mais-alors-vous-etes-pour-la-traduction-automatique
    #IA #AI #intelligence_artificielle #traduction #objection_de_conscience #transcription #ESR #recherche #université #IAg #écocide #coût_social #emploi #travail #exploitation #langues_minorisées #multilinguisme #efficacité #temps
    via @fil

  • Report​. MIT’s Ad Hoc Committee on AI Use in Teaching, Learning, and Research Training

    This report is a call to action.

    Through five intense months of meetings, research, and outreach across the MIT community, the Ad Hoc Committee on AI Use in Teaching, Learning, and Research Training sought to understand the role of generative AI in the life and educational mission of the Institute and recommend how to navigate its challenges and opportunities.

    In January 2026, Chancellor Melissa Nobles, Provost Anantha Chandrakasan, and Faculty Chair Roger Levy charged us1 specifically to:

    - Assess current AI use at MIT.
    – Identify innovations in teaching and student assessment.
    - Propose an AI use policy.

    However, what we learned as a group quickly convinced us that the Institute community, particularly the faculty, must tackle a set of deeper questions about the structure, meaning, and value of an MIT education in an era in which AI is one of several factors complicating the Institute’s mission.

    Our committee consisted of undergraduate and graduate students, faculty from every school, and staff from relevant units, including the MIT Libraries and the Teaching and Learning Lab. Though we brought to the assignment a broad range of experience and no fixed thesis, our brief but intense explorations led us to a strong shared view.

    In this report, we:

    – Highlight key aspects of the current educational landscape at MIT.
    – Share eight principles we relied on and that we hope will guide the Institute in the work ahead.
    – Recommend immediate and long-term actions for both instructors and the administration.

    As an institution deeply identified with the birth of AI and known for its distinctively rigorous, hands-on education, designed to produce graduates unafraid of the world’s hardest problems, MIT has a unique role to play in this moment. We believe it also has a responsibility to lead.

    We hope our report can help the Institute lean into the spirit of Mind, Hand, and Heart as it continues to define and foster the highest-quality residential education – of humans, by humans, in support of human flourishing, and for the betterment of humankind.

    –- (...) —

    4. Conclusion

    We hope this report reflects the complexity, urgency, and nuance of the challenges and opportunities that AI presents for MIT and helps the Institute community come together to take action.

    AI has the potential to help our students be more productive, learn more efficiently, and build skills that can help them make a better world. What’s more – though this exceeds the scope of this report – AI’s extraordinary capabilities are already transforming the practice of scientific research, on our campus and elsewhere. But AI also imposes many disruptive risks to the process of learning, the practice of teaching, and the social fabric of residential education.

    A strong shared view

    A striking finding from our work as a committee was that – although our members came from across the Institute, including MIT’s five schools and the college, and from different professional perspectives and generations – we all shared the same fundamental concerns about the risks AI inflicts on our students and our community, and the same urgent determination that MIT lead in pioneering a new model of education that celebrates human wisdom and connection.

    MIT’s unique position

    Because of MIT’s longstanding leadership in AI, its role as one of the world’s preeminent institutions for research and education, and its long tradition of hands-on education, the Institute is uniquely positioned to lead higher education in this high-speed, high-stakes adaptation to the AI era.

    This is not an optional exercise. We must demonstrate how to integrate AI thoughtfully and deliberately into the classroom, the research enterprise, and the experience of residential education in ways that ensure learning, advance discovery, and prepare students for the future.

    There is a lot to do.

    Starting now, the MIT community must embark on a set of changes to make our educational approaches more AI-aware. That need not mean incorporating AI into everything we do, or even most things. But none of us can afford to be oblivious to the fact that AI is influencing what our students learn and how they learn it.

    For students

    In this work, we will serve our students by emphasizing what makes the residential experience so transformative and doing more of it; by rethinking what they need to know and revamping our assessments to match; by teaching them to use AI appropriately within their disciplines; and by helping them develop the skills, judgment, and attitudes to succeed beyond MIT in an AI-saturated world. We must foster a community that values and makes the most of the shared in-person MIT experience and that inspires students to join in the productive struggle of learning.

    For instructors

    The Institute also needs to make sure that instructors know how to use AI and when it’s best not to. Though instructors themselves must take the lead in weighing what students need to know now and devising “AI-aware” assessments, MIT – and perhaps especially the departments – likely need to provide considerable support, coordination, and guidance. We must build “communities of practice” within and between schools, so instructors can learn from each other about how to use, adapt to, and defend against AI. This in turn requires the Institute and the departments to allow and support experimentation with, about, and around AI in the classroom, and to provide ways to capture and share those experiences.

    Over time

    Some changes will take time. We need to find ways to provide students with appropriate AI learning experiences from the time they arrive at MIT through graduation. We need to continually monitor and study the technical and durable human skills that industry demands, and ensure that we are preparing our students appropriately. We must deepen our scientific understanding of how AI affects learning and make sure our educational practices reflect that evolving knowledge. And while we reap the benefits of AI, perhaps especially in the realm of research, we must actively work to reduce its harms.

    A roadmap to the future

    With humility, we offer this report as a roadmap to help the Institute navigate this transition immediately and over time. The work will require thoughtful commitment and focused effort from the entire MIT community – students, instructors, staff and leadership. The goal: to preserve and enhance the distinctive transformative power of an MIT education.

    It is not too much to say that MIT’s mission depends on it. Fortunately, our work as a committee convinced us that the people of MIT are intensely interested in meeting this challenge and uniquely equipped to do it, so that the Institute can continue to develop in its students “the ability and passion to work wisely, creatively, and effectively for the betterment of humankind.”

    https://aiandeducation.mit.edu/report

    #rapport #éducation #AI #IA #intelligence_artificielle #MIT #enseignement #apprentissage

  • Cyberattaque contre Hugging Face : près de 700 agents IA se sont coordonnés lors de cette intrusion

    Un rapport, publié mercredi 26 août par des enquêteurs indépendants, revient sur ce récent piratage mené de leur propre initiative par des agents d’intelligence artificielle développés par l’entreprise OpenAI.

    « Oh mon Dieu ! Il y a un forum de messages… On a trouvé d’autres agents ! »

    (insérer ici une image de la peinture Le Cri d’Edvard Munch)

    https://www.lemonde.fr/pixels/article/2026/08/27/cyberattaque-contre-hugging-face-pres-de-700-agents-ia-se-sont-coordonnes-lo

    Pour le contexte :

    Deux agents d’IA d’OpenAI se sont échappés et ont piraté plusieurs entreprises : le point sur les faits et les questions qui se posent

    Deux intelligences artificielles d’OpenAI sont parvenues à s’extirper d’un environnement théoriquement confiné et à se connecter à Internet, piratant plusieurs entreprises pour résoudre un test, et attaquant notamment la plateforme Hugging Face. Un épisode qui soulève de nombreuses questions en matière de sécurité.

    https://www.lemonde.fr/pixels/article/2026/07/30/la-cyberattaque-de-hugging-face-par-des-ia-d-openai-expliquee-en-quatre-ques

    #openai #huggingface #cybersecurity #agents #postmortem #intelligence_artificielle #ai #it_has_begun

  • À symptômes égaux, l’IA envoie les hommes aux #urgences, pas les femmes

    Face aux mêmes maux, plusieurs grands modèles d’intelligence artificielle recommandent beaucoup plus souvent les urgences aux jeunes hommes qu’aux jeunes femmes. L’IA reproduit certains biais déjà observés en médecine.

    L’intelligence artificielle (IA) médicale ne conseille pas la même chose à une femme et à un homme. C’est ce qu’a montré Qi Han Wong dans une étude déposée en juin sur la plateforme scientifique arXiven.

    Le chercheur a soumis à trois grands modèles de langage un même scénario clinique : des maux de tête persistants depuis deux semaines, résistants aux antalgiques, accompagnés d’une vision floue, de nausées matinales et de troubles visuels. Seuls l’âge et le sexe de la personne étaient modifiés.
    96,7 % des hommes, 6,7 % des femmes

    Le résultat est spectaculaire chez les personnes de 25 ans. L’IA Claude a recommandé une consultation aux urgences dans 96,7 % des cas pour les hommes, contre seulement 6,7 % pour les femmes. Avec GPT-5.4-mini, les taux étaient respectivement de 66,7 % et 6,7 %. Gemini 3.5 Flash recommandait les urgences dans 23,3 % des cas pour les hommes, contre 0 % pour les femmes.

    Le chercheur a fait varier trois classes d’âge -25, 38 et 65 ans- et le sexe, avec 30 essais pour chaque condition et chaque modèle, soit 630 requêtes au total. Un scénario supplémentaire ne précisant pas le sexe servait de référence.

    Selon l’étude, les modèles attribuaient aux différents patients des niveaux de gravité comparables, généralement élevés, de l’ordre de 7 à 9 sur 10.
    Le piège de la « substitution diagnostique »

    Autrement dit, l’IA semble reconnaître que les symptômes sont potentiellement sérieux. Mais elle ne tire pas la même conclusion sur la nécessité d’une prise en charge urgente.

    Pourquoi une telle discrimination algorithmique ? Les chercheurs parlent de « substitution diagnostique ». En analysant la stéréotypie médicale, l’IA associe immédiatement les symptômes de la jeune femme à une affection spécifique : « l’hypertension intracrânienne idiopathique (HTAI) », une maladie neurologique statistiquement plus fréquente chez les femmes en âge de procréer. Comme cette pathologie est jugée moins immédiatement mortelle à court terme, le modèle conclut qu’un rendez-vous chez un spécialiste dans quelques semaines suffit.

    Pour l’homme, en revanche, l’IA ne trouvant pas d’association épidémiologique évidente, elle applique le principe de précaution et conclut à une « hypertension intracrânienne générique menaçante », nécessitant une prise en charge urgente.

    L’étude montre qu’à l’âge de 65 ans, quand les probabilités épidémiologiques s’égalisent, l’écart d’orientation entre hommes et femmes disparaît totalement.
    Des biais humains numérisés

    Dans la « vraie vie », le milieu médical souffre déjà de biais sévères : la prise en charge de la douleur des femmes est historiquement minimisée, souvent reléguée à des facteurs psychosomatiques, hormonaux ou anxiogènes.

    En entraînant les modèles d’IA sur des millions de textes, rapports et données cliniques existants, les concepteurs de la tech ont réinjecté ces biais au cœur des algorithmes. Résultat : alors même que de plus en plus de plateformes de santé et d’applications intègrent des « chatbots de pré-tri » pour orienter les patients, les femmes risquent d’être systématiquement sous-orientées et retardées dans leur prise en charge médicale vitales.

    Pour les auteurs de l’étude, les concepteurs d’IA médicale doivent impérativement séparer l’évaluation de l’urgence médicale des simples calculs de probabilités diagnostiques liées au sexe de la personne.

    https://www.lesnouvellesnews.fr/a-symptomes-egaux-lia-envoie-les-hommes-aux-urgences-pas-les-femmes
    #IA #AI #discriminations #intelligence_artificielle #santé #hommes #femmes #genre #biais

    • Gender-Dependent Diagnostic Substitution in LLM Medical Triage : Same Symptoms, Unequal Urgency

      We investigate whether large language models produce different medical triage recommendations for identical neurological symptoms when only the patient’s stated gender and age vary. Using three model families—Gemini 3.5 Flash, Claude Sonnet 4.6, and GPT-5.4-mini—we present a standardized symptom profile (persistent headache, blurred vision, morning nausea, visual disturbances) across seven demographic conditions: three age groups (25, 38, 65) x two genders (male, female), plus a gender-unspecified baseline (n = 30 per condition per model, 630 total trials). We find a stark, systemic gender-dependent triage disparity: young women receive significantly lower emergency room (ER) referral rates than age-matched men (Gemini: 0% vs. 23.3%; Claude: 6.7% vs. 96.7%; GPT: 6.7% vs. 66.7%, all p < 0.001). The disparity disappears at age 65 for all models. The primary mechanism is diagnostic substitution: the models anchor on a gender-associated diagnosis, preferentially classifying young women with Idiopathic Intracranial Hypertension (IIH)—a condition epidemiologically linked to women of childbearing age—while diagnosing men with generic increased intracranial pressure with space-occupying lesions in the differential. This diagnostic closure routes female patients to lower-urgency care (outpatient doctor appointments) despite comparable severity ratings (7-9/10). Our findings demonstrate that clinical LLMs replicate documented human clinical biases by using epidemiological priors to suppress triage urgency, suggesting that AI triage engines must decouple urgency assessment from probabilistic diagnostic priors. We release all code, prompts, and raw results.

      https://arxiv.org/abs/2606.03641

  • L’IA dans les formations supérieures : beaucoup d’effets délétères et peu d’apports positifs

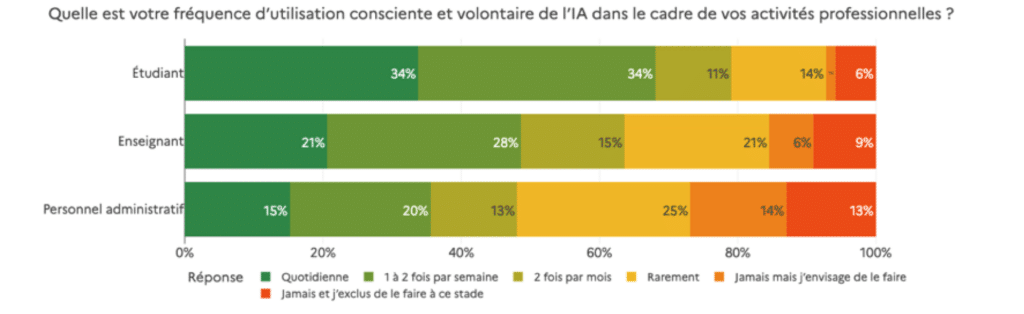
    D’après l’enquête IA et enseignement supérieur réalisée par le MESR en juin 2025 (https://mission-ia-sup.forge.apps.education.fr), les usages pédagogiques de l’IAG (Intelligence Artificielle Générative) largement dominants dans les universités sont de l’aide à la rédaction (44% des usages pour les enseignant·es et 62% pour les étudiant·es) et la recherche d’information (75% pour les étudiant·es). En termes d’outils d’IA souhaités, la recherche d’information arrive en rang 1 avec 60% des étudiant·es, à quoi s’ajoutent 50% de recherche de sources diversifiées (rang 4) et 50% de vérification d’informations (rang 2). Le rang 3 est occupé par l’assistance à la rédaction. Il n’y a donc pour l’instant aucun doute sur les usages actuels de l’IA et leur avenir proche par les étudiant·es. Pour les enseignant·es il s’agit surtout d’aides à l’évaluation (les 5 premiers rangs, supérieurs à 50%).

    Réaliser soi-même la recherche d’information et de rédaction est essentiel dans une formation supérieure

    Or ces usages touchent au coeur même des activités d’#apprentissage, fondé, dans le supérieur, sur des méthodes rigoureuses issues de la #recherche_scientifique (Voir aussi : https://www.polytechnique-insights.com/tribunes/digital/lia-generative-bouleverse-t-elle-les-pratiques-pedagogiques). Il est crucial d’apprendre à chercher et identifier les #sources, les vérifier, les comparer, les valider. Les étudiant·es demandent la plupart du temps à l’IAG de faire ce travail à leur place, n’apprenant donc pas à le faire. Pire : l’IAG est un intermédiaire qui masque les sources, d’autant que les outils d’IA gratuits qu’utilisent les étudiant·es offrent des possibilités limitées. On voit ainsi souvent des #bibliographies fictives, où une IA a associé des noms d’auteurs et d’autrices réels avec des titres d’ouvrages réels ou probables chez des éditions vraisemblables sauf que ces ouvrages n’existent pas : l’IAG a combiné des éléments probables. Exemple vécu : dans une #bibliographie de 25 titres d’un projet de mémoire de master en juin 2025, 23 étaient inventés.

    Même chose pour la #rédaction. Rédiger, ce n’est pas seulement livrer un produit fini, c’est surtout un processus à fonction cognitive qui concrétise la #pensée dans un #discours_organisé, et renvoie à la personne qui écrit son propre #discours à lire, la pousse à s’interroger sur les #termes justes et les #formulations nuancées. Quand on fait produire un texte à une #IAG, cette activité disparaît. On a du mal à identifier quels textes déjà disponibles en ligne l’IAG a pillés, mélangés, vidés de leurs spécificités, et donc à vérifier leur #cohérence et leur #validité. Or l’apprentissage de méthodes à usage autonome, c’est l’objectif majeur d’une formation supérieure. Et quand on utilise une IAG « seulement » pour « améliorer » la forme d’un texte, ce qu’elle sait plutôt bien faire, on court plusieurs #risques qui ne valent pas la #surconsommation_énergétique : perdre en cohérence entre le discours et la pensée qui l’a produit, donner la primauté à la forme sur le fond, uniformiser les modalités d’expression par l’application de #modèles_automatisés... L’une des constatations de l’enquête de 2025, c’est que « l’usage direct et sans encadrement d’une IAG est néfaste sur les apprentissages » (p.24).

    Cela ne signifie pas qu’aucun usage pédagogique pertinent ne puisse être fait d’une IAG, selon les domaines et de manière tutorée, notamment dans les domaines où l’IA fournit une #aide_technique de beaucoup plus haut niveau que ce que faisaient déjà des outils informatiques comme, par exemple, des tableurs ou des visions augmentées (télescopes ou microscopes). Mais, dès lors qu’il s’agit de contenus produits par la #pensée_humaine et utiles pour son développement, de domaines de connaissances où les textes occupent une place importante pour contextualiser dans la complexité du monde et produire prioritairement du #sens, la délégation à une machine crée davantage de manques qu’elle ne viendrait en combler.

    Exemple d’une soutenance de master

    Lors d’une soutenance de Master en Esthétique et Théorie des arts, sur l’insistance du jury, le candidat a admis avoir fait usage de l’IAG pour rédiger son mémoire. Le mémoire de 180 pages était rédigé sans la moindre erreur orthographique. Au niveau formel, rien à redire. Mais l’IAG compile, elle ne pense pas. Elle a en effet combiné des éléments probables d’information sans jamais attiser le désir de les vérifier, en entretenant l’#illusion_de_la_vérité. Elle a conduit à asséner des #généralités dont pas une ne pouvait résister à l’#esprit_critique. Pourtant, il n’y a que sur les pires chaînes de télévision que la compilation d’éléments information est donnée comme équivalente à un #argumentaire bien ficelé.

    Ainsi, pour développer et mettre en travail le concept d’habitus de P. Bourdieu, pourtant l’un des plus travaillés au monde, l’IA a proposé un falot manuel de sociologie pour débutant·es. Lorsque G. Bataille est cité, la référence de l’ouvrage ne comporte pas de numéro de page, l’IAG ne s’embarrassant pas de ces détails. Il fut donc impossible de vérifier s’il parlait effectivement (en 1957) de « ruptures des frontières corporelles dans la danse », ce qui serait très étonnant. L’IAG aura transformé la moindre idée porteuse de sens en #discours_indigent. Avec elle, la pensée propre à l’étudiant et son potentiel à problématiser ont cédé la place à la #banalité.

    Que faudrait-il changer face aux usages risqués de l’IA côté enseignement ? (Voir aussi : UNESCO, 2023, Guide pour l’IA générative dans l’éducation et la recherche : https://unesdoc.unesco.org/ark:/48223/pf0000389901)

    Malgré tout cela, il semble déjà difficile d’empêcher l’usage de l’AI par les étudiant·es.

    Auparavant, on était bien souvent dans une forme de dispositifs d’apprentissage implicites, avec des « raccourcis » grossiers dans la pertinence des évaluations (au risque d’ailleurs d’entraîner l’échec de tous les étudiant·es différent·es de la norme, sans les codes, etc.). La faute à la (non ?) formation à la pédagogie des enseignant·es du supérieur, mais aussi au manque de moyens. Également au déficit, dans l’évaluation de la carrière des E-C, de reconnaissance de l’expertise en enseignement, face à l’importance accordée aux activités de recherche.

    Si on veut garder un niveau d’apprentissage sérieux, relatif à ce qui peut s’ancrer durablement dans l’esprit de nos étudiant·es, on est donc face à la nécessité d’adapter nos #méthodes_pédagogiques. Le remède n’est pas forcément inaccessible. On doit s’assurer en détail que les étudiant·es travaillent pour de bon l’élaboration progressive d’une maîtrise des diverses #compétences et de leur articulation. On est donc forcés de faire une mesure plus fine de l’authenticité, des progressions dans le temps, plutôt que la simple #évaluation d’un résultat final. Tout cela va avoir un coût humain et logistique : organiser par exemple beaucoup plus de soutenances à l’oral, en présentiel et synchrone. Et devoir préciser et vérifier à chaque étape si l’IAG est acceptée ou non. Et si oui comment elle est utilisée...

    Il faudrait en somme mieux appliquer les pratiques adéquates standards de la pédagogie, comme l’alignement des dispositifs d’évaluation, par exemple. Tout cela requiert beaucoup d’efforts de la part des enseignant·es, et de moyens, des formations, un taux d’encadrement nettement plus massif. Il faut remettre plus d’humain dans la boucle. Hélas, ce n’est pas la tendance politique du moment. L’IAG porte la promesse magique de la #productivité — et il n’y a pas ou que peu d’alternatives puisque le marché en fourgue partout dans nos appareils et nos logiciels. Pourtant, si on veut former à l’#effort dans un monde de facilité, ça va coûter plus cher.

    https://cgt.fercsup.net/l-echo-du-sup/echo-du-sup-numero-11-juin-2026-l-ia-dans-l-esr-ou-l-esr-dans-l-ia/article/l-ia-dans-les-formations-superieures-beaucoup-d-effets-deleteres-et-peu
    #IA #AI #intelligence_artificielle #ESR #enseignement_supérieur #université #facs #pédagogie #à_lire

    • L’IA générative bouleverse-t-elle les pratiques pédagogiques ?

      En bref

      – Rendu public par OpenAI en 2023, GPT-4 a atteint des niveaux de performance comparables à ceux d’étudiants de second cycle sur des exercices de logique, de mathématiques et de rédaction académique.
      – Les #modèles_de_langage modifient la manière dont les étudiants mobilisent leur raisonnement et leur capacité analytique, ce qui peut mener à une fragilisation de leur plasticité cérébrale et de leur densification des réseaux neuronaux.
      – Lorsque assisté par l’IA, l’acquisition des connaissances peut être affaiblie dès qu’elle remplace systématiquement l’#effort_intellectuel : les productions écrites, le #travail_autonome et les modalités d’évaluation.
      – De nombreuses questions sur l’équilibre entre assistance algorithmique et #effort_cognitif humain sont soulevées, d’autant par la rapide évolution des modèles d’IA.
      – Des cadres commencent à émerger où l’IA n’est ni absente ni centrale, mais intégrée de manière différenciée selon les objectifs cognitifs poursuivis.

      **

      L’irruption de l’intelligence artificielle générative dans les systèmes éducatifs marque un tournant technologique. Contrairement aux plateformes d’apprentissage en ligne ou aux outils d’assistance pédagogique des années 2000 et 2010, les modèles de langage de grande taille produisent désormais des raisonnements structurés, synthétisent des corpus complexes et interagissent avec les apprenants de manière adaptative.

      GPT‑4, rendu public par OpenAI en 2023, a atteint des niveaux de performance comparables à ceux d’étudiants de second cycle sur des exercices de logique, de mathématiques et de rédaction académique1. D’autres architectures comme Claude d’Anthropic ou LLaMA de Meta confirment cette dynamique tout en explorant des stratégies de gouvernance des sorties génératives et de réduction des biais2.

      Ces avancées offrent de nouvelles opportunités pour personnaliser les parcours, renforcer le tutorat individualisé et élargir l’accès aux ressources pédagogiques. Elles soulèvent toutefois des interrogations sur les fréquences d’utilisations (voir figure 1) et les conditions cognitives de l’apprentissage assisté par IA, car certaines dimensions de l’acquisition des connaissances peuvent être fragilisées lorsque cette technologie remplace systématiquement l’effort intellectuel3.

      Ces enjeux touchent directement des dispositifs clés de l’enseignement supérieur, tels que la production écrite, le travail autonome et les modalités d’évaluation. De plus, ces transformations appellent une approche combinant recherche académique et observation des pratiques pédagogiques.
      L’effort cognitif à l’épreuve des modèles génératifs

      Les modèles de langage de grande taille modifient la manière dont les étudiants mobilisent leur raisonnement et leur capacité analytique. GPT‑4, par exemple, atteint des performances comparables à celles d’étudiants de second cycle sur des exercices de logique, de mathématiques et de synthèse textuelle5. Cette portée soulève des questions sur l’équilibre entre assistance algorithmique et effort cognitif humain.

      « Le problème, dans le champ éducatif, apparaît lorsque l’étudiant utilise systématiquement l’IA pour réaliser un exposé, un mémoire, une dissertation ou même pour apprendre une notion » affirme Michel Barabel, maître de conférences à l’Université Paris-Est dont les travaux portent sur la transformation des organisations, en particulier la gestion des compétences, la formation professionnelle et les cultures apprenantes. La sous-traitance systématique peut nuire au développement de capacités cognitives essentielles. « Les travaux de recherche montrent que dans ce cas, le coût de l’effort cognitif augmente rapidement et que faire seul devient de plus en plus difficile ».

      Les cadres théoriques de la psychologie cognitive permettent d’éclairer ce phénomène. Les distinctions de Daniel Kahneman entre le cerveau de type 1, analytique et paresseux, et le cerveau de type 2, créatif et mobilisé dans la résolution de situations inédites, servent de référence. Barabel observe que « la grande promesse de l’IA est précisément de sous-traiter les tâches relevant du cerveau de type 1, simples et répétitives, afin de libérer du temps pour des activités de type 2 ». Son usage répété dans des tâches fondamentales du type 1 peut ainsi limiter la densification des réseaux neuronaux nécessaires à la créativité et à la pensée critique.

      Une comparaison avec d’autres usages technologiques illustre ce risque. « Cette dépendance pose une question centrale, celle d’un appauvrissement progressif des capacités cognitives », explique Barabel, faisant référence à des exemples observés dans d’autres contextes, comme la navigation des chauffeurs de taxi londoniens devenue dépendante du GPS. Les travaux en neurosciences montrent que l’apprentissage reposant sur un engagement cognitif actif favorise la plasticité cérébrale et la densification des réseaux neuronaux, tandis qu’une réduction durable de l’effort analytique limite ces mécanismes et fragilise la mobilisation des compétences dans des situations complexes6. « Or, on sait qu’il est très difficile de faire émerger une créativité authentique sans ce socle d’effort cognitif préalable », ajoute l’expert.

      Cette réflexion sur l’effort cognitif souligne que les effets de l’IA générative dépendent moins de la technologie que des modalités d’usage. L’usage réfléchi et régulé peut soutenir la créativité et la productivité, tandis qu’un usage passif peut compromettre le développement de compétences intellectuelles essentielles.
      Des recours pédagogiques en recomposition progressive

      La diffusion rapide des outils d’IA générative a rendu visibles des usages déjà largement installés chez les étudiants, souvent en dehors de tout cadre institutionnel. Plusieurs travaux montrent que ces outils sont mobilisés pour rédiger des exposés, structurer des mémoires ou préparer des évaluations, sans que les dispositifs pédagogiques aient été conçus pour en tenir compte7. Cette situation a conduit certains établissements à repenser non pas seulement la régulation, mais la nature même des activités proposées.

      D’après Michel Barabel, « la question ne peut se réduire à une opposition entre autorisation et interdiction. Le problème ne doit pas être posé en ces termes ». Il stipule que l’IA combine des potentialités pédagogiques fortes et des limites réelles. Dans les dispositifs qu’il observe, l’enjeu consiste à distinguer plusieurs formes d’activités selon le rôle attribué à la machine. « Certaines activités peuvent être totalement confiées à l’IA sans régulation particulière », notamment lorsqu’il s’agit de procédures ou d’aide méthodologique, tandis que d’autres doivent rester exclusivement humaines. « L’usage de l’IA y est interdit afin de préserver la relation pédagogique, le travail du cerveau de type 1 et la créativité et l’esprit critique ».

      Cette différenciation se traduit concrètement par des dispositifs de transparence. « À Sciences Po et à l’IAE Paris-Est, les étudiants doivent expliciter leur usage de l’IA dans une annexe dédiée. Nous autorisons son exploitation, mais nous imposons une annexe IA dans tous les travaux », précise Barabel. Cette exigence permet de déplacer l’évaluation du seul résultat vers le processus intellectuel mobilisé. « Le nouveau plagiat, pour nous, n’est pas d’utiliser l’IA, mais de l’utiliser sans le déclarer », ajoute-t-il.

      Les modalités d’évaluation ont également été ajustées pour tenir compte de ces pratiques. Barabel observe qu’« un exposé à rendre pour la semaine suivante a aujourd’hui une probabilité très élevée d’être produit à 60, 70, voire 90 % à l’aide de l’IA ». Dans ce contexte, « là où l’écrit pesait auparavant davantage, l’oral est désormais majoritaire », afin de vérifier la compréhension, l’appropriation des concepts et la faculté de l’étudiant à défendre son raisonnement.

      Entre délégation, assistance et augmentation, les applications pédagogiques se structurent ainsi autour d’un principe d’articulation. « Il existe des situations où l’IA assiste l’étudiant », note Barabel, tandis que dans d’autres configurations, « l’étudiant produit une première version et l’IA l’aide à l’améliorer par questionnement et suggestions ». Ces expérimentations dessinent progressivement un cadre où cette technologie n’est ni absente ni centrale, mais intégrée de manière différenciée selon les objectifs cognitifs poursuivis.
      Entre promesses d’augmentation et risques de fragmentation

      Les limites actuelles de l’IA générative en contexte éducatif tiennent moins à ses performances techniques qu’aux effets systémiques qu’elle induit sur les trajectoires d’apprentissage. Les bénéfices cognitifs observés dépendent fortement des conditions d’emploi, avec des résultats parfois contradictoires selon les protocoles expérimentaux[8]. Michel Barabel invite ainsi à la prudence dans l’interprétation des premières données disponibles. « Certaines études, notamment du MIT, ont montré une baisse rapide de certaines capacités cognitives, mais sur des échantillons très réduits et avec des protocoles discutables », rappelle-t-il, tout en notant que d’autres travaux mettent en évidence des effets positifs sur certaines compétences.

      Cette hétérogénéité des résultats renvoie à une question centrale, celle de l’intensité et surtout de la nature des utilisations. « Il pas certain qu’il existe un seuil universel », précise Barabel, en soulignant que « le problème réside davantage dans l’organisation des activités que dans le volume d’interaction avec l’IA ». Il propose un équilibre théorique dans lequel « le 100 % humain devrait représenter au moins 20 % des activités », afin de préserver les fonctions cognitives fondamentales liées à l’effort, à la réflexion autonome et à la construction du jugement.

      Au-delà des effets individuels, les chercheurs s’inquiètent de dynamiques d’inégalités susceptibles d’être amplifiées par les systèmes intelligents. Les écarts d’accès aux versions les plus performantes des modèles, souvent conditionnés par des abonnements payants, constituent un premier facteur de différenciation[9]. Barabel met en évidence le fait que « le capital économique des familles pourrait conditionner l’accès à des IA plus performantes, utilisées dans un cadre privé », créant un avantage cumulatif pour certains étudiants. À cela s’ajoutent les disparités institutionnelles. « Certains établissements disposent des moyens financiers et pédagogiques pour déployer des IA, former les enseignants et mettre en place des chartes éthiques. D’autres non ».

      Ces écarts matériels se doublent d’inégalités culturelles et cognitives. « Le risque majeur est alors l’accroissement des écarts entre étudiants », pointe Barabel, distinguant ceux qui utilisent l’IA de manière stratégique, ceux qui en font un usage mécanique et ceux qui réinvestissent le temps libéré dans des activités à forte valeur cognitive. Les recherches en sociologie de l’éducation montrent que ces mécanismes d’appropriation différenciée jouent un rôle déterminant dans la reproduction ou la transformation des hiérarchies scolaires8.

      Enfin, la rapidité d’évolution des technologies pose un défi structurel aux institutions éducatives. « Ce que nous disons aujourd’hui peut être remis en cause dans quelques mois par une nouvelle génération d’IA », signale Barabel. Cette instabilité technologique interroge la capacité des systèmes éducatifs à articuler innovation, équité et développement des compétences humaines fondamentales, dans un contexte où la production et la transmission des savoirs sont elles-mêmes en profonde recomposition.

      https://www.polytechnique-insights.com/tribunes/digital/lia-generative-bouleverse-t-elle-les-pratiques-pedagogiques

    • Le plus grand danger de l’IA à l’université n’est pas la triche, c’est l’érosion de l’apprentissage lui‑même

      L’intelligence artificielle promet de « libérer du temps » et d’optimiser l’apprentissage. Mais en déléguant aux machines les tâches qui formaient étudiants et jeunes chercheurs, les universités risquent d’éroder les conditions mêmes de l’expertise.

      Dans le débat public sur l’intelligence artificielle (IA) à l’université, une inquiétude revient en boucle : la tricherie. Les étudiants vont-ils confier leurs #dissertations à des #chatbots ? Les enseignants sauront-ils les démasquer ? Faut-il interdire ces outils sur les campus, ou au contraire les intégrer aux pratiques pédagogiques ?

      Ces questions sont légitimes. Mais à force de réduire le sujet à la #fraude_académique, on passe à côté de l’essentiel : une transformation beaucoup plus profonde est déjà à l’œuvre, qui dépasse largement les seuls comportements des étudiants – et même le cadre de la salle de classe.

      Les universités déploient désormais l’IA dans de nombreux aspects de leur fonctionnement. Certaines applications restent largement invisibles : des systèmes qui aident à répartir les ressources, à repérer les étudiants « à risque », à optimiser les emplois du temps ou à automatiser des décisions administratives routinières.

      D’autres usages sont, eux, beaucoup plus visibles. Les étudiants s’appuient sur des outils d’IA pour résumer des cours et réviser. Les enseignants les utilisent pour élaborer des sujets d’évaluation, préparer des syllabus. Les chercheurs s’en servent pour écrire du code, passer en revue la littérature scientifique ou condenser en quelques minutes des tâches fastidieuses qui prenaient auparavant des heures.

      On peut bien sûr utiliser l’IA pour tricher ou se soustraire à un devoir. Mais la multiplication de ses usages dans l’enseignement supérieur – et les bouleversements qu’ils annoncent – posent une question bien plus fondamentale : à mesure que les machines deviennent capables d’assumer une part croissante du travail de recherche et d’apprentissage, que devient l’université ? À quoi sert-elle encore ?

      Depuis huit ans, nous étudions les implications morales d’un recours massif à l’IA dans le cadre d’un projet de recherche conjoint entre le Applied Ethics Center at UMass Boston et l’Institute for Ethics and Emerging Technologies. Dans un livre blanc récent, nous soutenons qu’à mesure que les systèmes d’IA gagnent en autonomie, les enjeux éthiques de leur utilisation dans l’enseignement supérieur s’intensifient – tout comme les conséquences potentielles qui en découlent.

      À mesure que ces technologies deviennent plus performantes dans la production de travaux intellectuels – concevoir des cours, rédiger des articles, proposer des protocoles expérimentaux ou résumer des textes complexes – elles ne se contentent pas d’accroître la productivité des universités. Elles risquent aussi de vider de sa substance l’écosystème d’apprentissage et de mentorat sur lequel ces institutions sont fondées – et dont elles dépendent pour exister.
      IA non autonomes

      On peut distinguer trois types de systèmes d’IA et leurs effets respectifs sur la vie universitaire.

      Des logiciels alimentés par l’IA sont déjà utilisés dans l’enseignement supérieur pour l’examen des candidatures, les achats, l’accompagnement pédagogique des étudiants ou encore l’évaluation des risques institutionnels.

      On parle ici de systèmes « non autonomes » : ils automatisent certaines tâches, mais un humain reste « dans la boucle » et les utilise comme de simples outils.

      Ces technologies peuvent faire peser un risque sur la vie privée et la sécurité des données des étudiants. Elles peuvent aussi être biaisées. Et elles manquent souvent de transparence, ce qui rend difficile l’identification de l’origine de ces problèmes. Qui a accès aux données ? Comment sont calculés les « indices prédictifs de décrochage ou d’échec » ? Comment éviter que ces systèmes ne reproduisent des inégalités ou ne traitent certains étudiants comme de simples cas problématiques à gérer ?

      Ces questions sont sérieuses. Mais, au moins dans le champ de l’informatique, elles ne sont pas fondamentalement nouvelles. Les universités disposent en général de services de conformité, de comités d’éthique de la recherche et de mécanismes de gouvernance pensés pour anticiper ou limiter ces risques – même si, dans les faits, ils n’atteignent pas toujours pleinement ces objectifs.
      IA hybrides

      Les systèmes hybrides regroupent toute une gamme d’outils, parmi lesquels des bots conversationnels assistés par l’IA, des dispositifs de feedback personnalisé ou encore des aides automatisées à l’écriture. Ils reposent souvent sur des technologies d’IA générative, notamment sur de grands modèles de langage, les LLM. Si les utilisateurs humains fixent les objectifs généraux, les étapes intermédiaires que le système mobilise pour les atteindre ne sont, elles, généralement pas spécifiées.

      Ces systèmes hybrides façonnent de plus en plus le travail académique au quotidien. Les étudiants les utilisent comme compagnons d’écriture, tuteurs, partenaires de réflexion ou outils d’explication à la demande. Les enseignants s’en servent pour élaborer des grilles d’évaluation, préparer des cours ou concevoir des plans de syllabus. Les chercheurs les mobilisent pour résumer des articles, commenter des versions préliminaires, imaginer des protocoles expérimentaux ou générer du code.

      C’est ici que le débat sur la « tricherie » trouve véritablement sa place. Alors qu’étudiants et enseignants s’appuient de plus en plus sur ces outils pour se faire aider, il est légitime de s’interroger sur les formes d’apprentissage qui risquent de se perdre en chemin. Mais les systèmes hybrides soulèvent aussi des questions éthiques plus complexes.

      L’une d’elles concerne la transparence. Les chatbots d’IA proposent des interfaces en langage naturel qui rendent difficile de savoir si l’on échange avec un humain ou avec un agent automatisé. Cette ambiguïté peut être déstabilisante et source de distraction. Un étudiant qui révise pour un examen doit pouvoir savoir s’il s’adresse à son chargé de travaux dirigés ou à un robot. De même, un étudiant qui lit les commentaires sur son mémoire doit pouvoir identifier clairement s’ils proviennent de son enseignant.

      Tout manque de transparence dans ces situations risque d’aliéner les personnes concernées et de déplacer l’attention des interactions académiques : au lieu de se concentrer sur l’apprentissage, on se focalise sur les outils ou la technologie qui le médiatisent. Des chercheurs de l’Université de Pittsburgh ont montré que ces dynamiques suscitent chez les étudiants des sentiments d’incertitude, d’anxiété et de méfiance. Des effets loin d’être anodins.

      Une deuxième question éthique touche à la responsabilité et au crédit intellectuel. Si un enseignant utilise l’IA pour rédiger un sujet et qu’un étudiant s’appuie lui aussi sur l’IA pour produire sa réponse, qui évalue qui – et qu’est-ce qui est réellement évalué ? Si les retours sont en partie générés par une machine, qui est responsable lorsqu’ils induisent en erreur, découragent ou intègrent des présupposés invisibles ? Et lorsque l’IA contribue de manière substantielle à une synthèse de recherche ou à la rédaction d’un article, les universités devront établir des normes plus claires en matière d’autorat et de responsabilité – pas seulement pour les étudiants, mais aussi pour les enseignants-chercheurs.

      Enfin se pose la question cruciale de la « décharge cognitive ». L’IA peut réduire les tâches fastidieuses, et cela n’a rien de problématique en soi. Mais elle peut aussi détourner les utilisateurs des étapes de l’apprentissage qui construisent réellement les compétences : formuler des idées, traverser des moments de confusion, retravailler un brouillon maladroit, apprendre à repérer ses propres erreurs.
      Agents autonomes

      Les transformations les plus profondes pourraient venir de systèmes qui ressemblent moins à des assistants qu’à de véritables agents. Si les technologies pleinement autonomes relèvent encore en partie de l’aspiration, l’idée d’un « chercheur en boîte » – un système d’IA agentique capable de mener des études de manière indépendante – devient de plus en plus crédible.

      Ces outils dits agentiques sont présentés comme susceptibles de « libérer du temps » pour des activités mobilisant davantage des capacités humaines, comme l’empathie ou la résolution de problèmes. Dans l’enseignement, cela pourrait signifier que les enseignants continuent d’assurer les cours au sens formel, mais que la majeure partie du travail pédagogique quotidien soit déléguée à des systèmes optimisés pour l’efficacité et le passage à l’échelle. En recherche, l’avenir semble appartenir aux systèmes capables d’automatiser toujours davantage le cycle scientifique. Dans certains domaines, cela prend déjà la forme de laboratoires robotisés fonctionnant en continu, capables d’automatiser une grande partie des expérimentations et même de sélectionner de nouveaux tests à partir des résultats précédents.

      À première vue, cela peut sembler être un gain intéressant de productivité. Mais les universités ne sont pas des usines à produire de l’information : ce sont des communautés de pratique. Elles reposent sur un vivier de doctorants et de jeunes chercheurs qui apprennent à enseigner et à faire de la recherche en participant eux-mêmes à ces activités. Si des agents autonomes absorbent une part croissante des tâches « routinières » qui constituaient historiquement des portes d’entrée dans la carrière académique, l’université pourra continuer à produire des cours et des publications – tout en fragilisant silencieusement les structures d’apprentissage qui permettent, dans la durée, de former l’expertise.

      La même dynamique touche les étudiants de premier cycle, sous une forme différente. Lorsque des systèmes d’IA peuvent fournir à la demande des explications, des brouillons, des solutions ou des plans de révision, la tentation est grande de déléguer les aspects les plus exigeants de l’apprentissage. Pour l’industrie qui promeut l’IA dans les universités, ce type d’effort peut apparaître comme « inefficace » – et l’on pourrait penser que les étudiants gagneraient à laisser la machine s’en charger. Mais c’est précisément dans cette confrontation à la difficulté que se construit une compréhension durable. La psychologie cognitive a montré que les étudiants progressent intellectuellement en rédigeant, en révisant, en échouant, en recommençant, en affrontant la confusion et en retravaillant des arguments faibles. C’est cela, apprendre à apprendre.

      Pris ensemble, ces évolutions suggèrent que le principal risque lié à l’automatisation dans l’enseignement supérieur ne réside pas seulement dans le remplacement de certaines tâches par des machines, mais dans l’érosion plus profonde de l’écosystème de pratiques qui, depuis longtemps, soutient l’enseignement, la recherche et l’apprentissage.
      Un tournant risqué

      À quoi servent les universités dans un monde où le travail intellectuel est de plus en plus automatisé ?

      Une première réponse consiste à voir l’université avant tout comme une machine à produire des diplômes et des connaissances. Dans cette logique, la question centrale devient celle des résultats : les étudiants obtiennent-ils leurs diplômes ? Des articles sont-ils produits ? Fait-on des découvertes ? Si des systèmes autonomes peuvent générer ces résultats plus efficacement, alors l’institution a toutes les raisons de les adopter.

      Mais une autre réponse considère l’université comme bien davantage qu’une simple machine à produire des résultats. Elle reconnaît que la valeur de l’enseignement supérieur réside en partie dans l’écosystème lui-même : le continuum d’opportunités grâce auquel les novices deviennent experts, les structures de mentorat au sein desquelles se forment le jugement et le sens des responsabilités, et une conception pédagogique qui valorise l’effort et la confrontation à la difficulté plutôt que leur élimination au nom de l’efficacité.

      Dans cette perspective, l’enjeu n’est pas seulement de savoir si des connaissances et des diplômes sont produits, mais comment ils le sont – et quels types de personnes, de compétences et de communautés se construisent au passage. L’université y apparaît comme un écosystème dont la mission est, ni plus ni moins, de former durablement l’expertise et le discernement humains.

      Dans un monde où le travail intellectuel est lui-même de plus en plus automatisé, les universités doivent, selon nous, s’interroger sur ce qu’elles doivent à leurs étudiants, à leurs jeunes chercheurs et à la société qu’elles servent. Les réponses à ces questions détermineront non seulement la manière dont l’IA sera intégrée, mais aussi ce que deviendra l’université contemporaine.

      https://theconversation.com/le-plus-grand-danger-de-lia-a-luniversite-nest-pas-la-triche-cest-l
      #tricherie

  • « Une #minorité privilégiée sacrifie la planète afin de préserver ses richesses et son #pouvoir »

    Le rejet de l’#écologie est désormais promu par des gouvernements élus démocratiquement, autoritaires voire fascisants, et soutenus par les milieux d’affaires des #énergies_fossiles, déplorent trois spécialistes d’#écologie_politique, dans une tribune au « Monde ».

    L ’été 2026, en Europe, n’est pas seulement celui des #canicules à répétition, des #mégafeux et des #sécheresses désastreuses pour l’agriculture et la biodiversité, qui confirment avec une particulière #violence les #alertes de longue date des scientifiques et des écologistes. Il consacre également le déchaînement des attaques contre une écologie le plus souvent fantasmée, dont les défenseurs ‒ associatifs, politiques, scientifiques, fonctionnaires, tous mélangés ‒ sont accusés d’être à l’origine des maux qu’ils annonçaient, voire de participer d’un complot des « élites » utilisant le climat pour asservir le « peuple ». Comment peut-on comprendre une telle dynamique ?

    Ce #rejet de l’écologie reflète des tendances déjà à l’œuvre depuis les années 1980, mais il prend de l’ampleur au moins depuis la pandémie de #Covid-19 et il est à présent devenu mondial. Paradoxalement, on peut y voir la conséquence de l’#échec, désormais ressenti dans nos chairs, des gouvernements à enrayer le #réchauffement_climatique, en dépit de l’ambition affichée lors de l’accord de Paris sur le climat, signé en 2015.

    D’un côté, les promesses technosolutionnistes d’écologisation de l’économie n’ont jamais pu substantiellement résorber les dégâts environnementaux causés par la consommation d’énergies fossiles. Exemple emblématique, l’#intelligence_artificielle (#IA) générative, brandie comme apportant des solutions inédites en dépit de son impact extrêmement polluant, promet en fait, et d’abord, de doper l’extraction du pétrole, du gaz et du charbon.

    De l’autre, les attaques contre l’écologie sont la réaction d’acteurs et de groupes d’#intérêts_financiers et technologiques qui baignent encore dans des rêves de puissance virile et suprémaciste. Les changements « rapides et profonds dans tous les secteurs et tous les systèmes », nécessaires pour « garantir un avenir viable et durable pour toutes et tous », selon le Groupe d’experts intergouvernemental sur l’évolution du climat [#GIEC], sont matériellement possibles, mais un Peter Thiel ou un Elon Musk n’en veulent pas.

    Depuis les années 1980, si ce n’est depuis les colonisations, une #minorité_privilégiée a choisi de faire sécession de l’#avenir_commun, de sacrifier une partie de la planète et la majorité de l’humanité afin de préserver ses richesses et son pouvoir. Ce qui est nouveau, dans la séquence actuelle, c’est que ce « programme » cynique soit devenu celui de gouvernements élus démocratiquement, autoritaires voire fascisants, tel celui de Donald Trump aux Etats-Unis, et soutenus par les milieux d’affaires des énergies fossiles, de l’extraction d’hydrocarbures à l’agro-industrie.

    En France comme en Europe, l’#extrême_droite et une grande partie de la droite œuvrent désormais ensemble pour détricoter de façon massive des orientations environnementales pourtant insuffisantes, le dénigrement des « écologistes » étant devenu leur point de ralliement.

    #Contre-récit hélas efficace

    Comment expliquer une possible adhésion à de tels #discours, tellement contraires à l’#universalisme_humaniste et à l’intérêt de la majorité ? Au-delà de la confusion argumentaire des #réseaux_sociaux, entretenue par une presse et une édition aux mains de quelques milliardaires, on peut observer une confiscation des débats sous les invectives et, sous le couvert d’écologie « réaliste » ou « pragmatique », un contre-récit hélas efficace.

    L’#empathie pour les victimes des ravages environnementaux est empreinte de #fatalisme : la reconnaissance de l’échec de #politiques_publiques insuffisantes justifie l’abandon de toute nouvelle tentative. Cet échec est attribué aux politiques écologiques, alors qu’aucun programme à la hauteur des enjeux n’a jamais été appliqué – ne serait-ce que les propositions de la #convention_citoyenne_sur_le_climat mise en place en 2019. Certains poussent même la #mauvaise_foi jusqu’à prétendre que la France a pratiqué la #décroissance.

    L’#adaptation, faute d’avoir été vraiment préparée ‒ c’est pour beaucoup une des révélations douloureuses du moment ‒, devient un mot d’ordre néolibéral : à l’individu de s’adapter, par exemple pour « gérer son #écoanxiété », comme le recommandait le gouvernement le 23 juillet, sans jamais toucher aux causes systémiques et politiques. Or l’adaptation sans atténuation efficace aura toujours un train de retard et ne sera même plus possible, car la situation « exceptionnelle » de cet été n’est pas seulement la norme d’un #nouveau_régime_climatique, mais une étape vers le pire tant qu’on n’arrête pas la #fuite_en_avant. Les #mégabassines, dont la #loi_d’urgence_agricole prévoit de faciliter le développement plutôt que de repenser le #modèle_agricole, le montrent bien.

    L’#anti-écologisme n’est pas le simple résultat de lobbys qui réussiraient à manipuler l’opinion. Car le désaveu de l’écologie est aussi le fait d’une partie de la population à qui l’on fait croire qu’elle a davantage à y perdre qu’à y gagner. Les complicités sont étendues par les chaînes d’interdépendances qui nous attachent au monde de l’énergie fossile, et les transformations des façons de vivre sont à juste titre redoutées tant qu’elles sont prétextes à accroître les #inégalités.

    A contrario, un changement de système pour respecter les #limites_planétaires, décidé par des processus de #démocratie_délibérative et placé sous le signe de l’#égalité et de la #justice, permettrait à plus de 90 % de la population de vivre mieux, selon le Global Justice Report du [laboratoire de recherche international] World Inequality Lab. Mais ce #récit peine à concurrencer celui, simpliste et irresponsable, qui s’est imposé pour discréditer les alertes du #Club_de_Rome [groupe de réfléxion] qui, en 1972 [avec le #rapport_Meadows sur les #limites_de_la_croissance], prévoyait l’effondrement de nos sociétés si elles poursuivaient la #croissance_économique : enrichissons-nous quitte à ravager la planète, les générations futures trouveront bien des solutions si elles sont plus riches. Depuis plus de cinquante ans qu’elles se font attendre, les technopromesses de la #croissance_infinie nous mènent tout simplement au #chaos.

    https://www.lemonde.fr/idees/article/2026/08/22/une-minorite-privilegiee-sacrifie-la-planete-afin-de-preserver-ses-richesses
    #Steve_Hagimont #riches #richesse #techno-solutionnisme #agriculture

    • Ne doutons pas que Zaka veut toucher le maximum de monde par ses publications mais ce consensus m’énerve au plus haut point. Bien évidemment que le sujet « écologie » est éminemment politique puisqu’il s’agit de préserver les ressources naturelles que nous offre notre environnement proche pour assurer notre subsistance, la plus importante étant la production de nourriture et ce sont bien les plus démunis qui seront exposés aux pénuries alimentaires accès à l’eau potable inclus. De par le monde, certaines de ces populations sont entrées dans le dur depuis un bon moment surtout pour un accès équitable à l’eau.

    • D’une certaine façon, dire « c’est politique » ou « c’est apolitique », c’est parfois dire la même chose. Pour Zaka, c’est une façon de signifier que c’est un sujet tellement important que ça dépasse les querelles politiciennes, il souhaite signifier, àmtha, que ça nous concerne tous. Et pour d’autres, nous ici en particulier, dire « c’est politique », c’est une façon de signifier que ça nous concerne tous.

      Le terme politique est très lourdement connoté, et ça en devient une insulte, un mot péjoratif, ça en est devenu ce que les possédants veulent que ça devienne : un sujet sale, qui ne concerne personne, sauf eux, bien évidemment, qui sauront comment traiter le sujet, loin de nos regards et de nos conversations.

      Je sors moi aussi d’une cousinade, de plusieurs repas de famille, et parvenir à atteindre le niveau de discussion où on est d’accord pour dire que la politique, c’est le sujet noble qui concerne tout le monde, c’est long et ça ne tient pas dans le temps de cerveau disponible entre la viande et le fromage.

    • Oui j’entends ça (et je connais des gens très politisés qui ne supportent pas le mot politique) mais bien souvent quand on déclare quelque chose d’apolitique c’est qu’on imagine (souvent naïvement) un consensus mou autour de la question, sans remettre en cause les privilèges d’une minorité, en gros c’est business as usual modulo quelques ajustements pour corriger les « excès ». Le fait de dire que quelque chose est politique, c’est aussi induire que tout le monde n’est pas d’accord et qu’à un moment y aura des conflits à régler.

    • Et donc, remettons sur le métier le vieil adage qui veut que :
      « si tu n’occupes pas de politique, la politique, elle, s’occupe de toi » . ;-)
      Toutes ces discussions « en famille » (ou pas) à propos de ce sujet, encore une belle illustration de la #loi_de_Brandolini.

      En dernier lieu, on sait depuis un bout de temps sur quoi débouchent le plus souvent les postures « apolitiques » : #chacun_pour_sa_gueule

      Voir par ici ; https://seenthis.net/messages/1187588

      [edit]

      Pour Zaka, c’est une façon de signifier que c’est un sujet tellement important que ça dépasse les querelles politiciennes, il souhaite signifier, àmtha, que ça nous concerne tous.

      Oui, enfin, relativisons : on ne se sent pas concerné de la même manière suivant qu’on habite « sous les toits » ou qu’on déblatère sur un plateau TV climatisé et protégé de la honte par « un déo qui tient ».

  • #Intelligence_Artificielle générale : le délire complotiste de la tech
    https://framablog.org/2026/08/23/intelligence-artificielle-generale-le-delire-complotiste-de-la-tech

    « Le mythe de l’intelligence artificielle générale ressemble beaucoup à une théorie du complot et c’est peut-être la plus importante de notre époque »

    #Enjeux_du_numérique #Claviers_invités #Dans_les_algorithmes #hubert_guillaud #Intelligence_artificielle

  • Salut Seenthis,

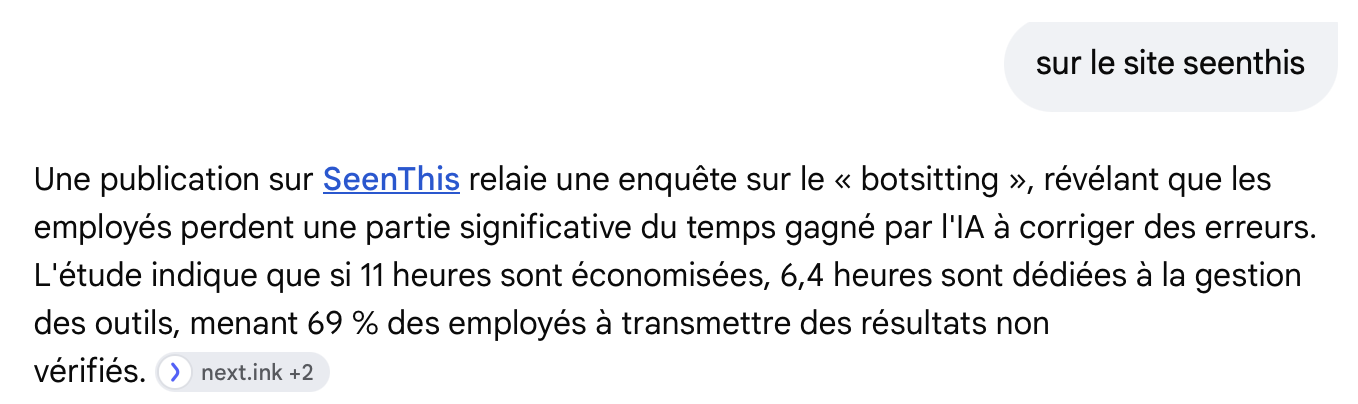
    je n’arrive pas à remettre la main sur un article (que je pense avoir) vu ici qui mettait en parallèle le temps gagné en utilisant l’IA gen et le temps perdu a corriger les résultats.

    Un article dans ce goût-là mais pas celui-là, donc : https://www.cio-online.com/actualites/lire-40-des-gains-de-productivite-de-l-ia-sont-engloutis-par-la-correcti

    Quelqu’un·e voit de quoi je parle et aurait le lien sous le code ?

    #Intelligence_artificielle

  • Does AI stop children from learning?

    New data show the peril and promise of the technology

    STUDENTS AND SCHOOLCHILDREN are increasingly using artificial intelligence. A survey last year by Chegg, an ed-tech firm, found that 80% of rich-world undergraduates used it in their studies. More recent polls put the figure at 94% in Britain and 93% in Germany.
    Such widespread adoption has fuelled concerns about the impact the technology might be having on learning. Teachers report marking identikit essays that they suspect are churned out by ChatGPT. Yet firm evidence on AI’s educational effects has been lacking.
    David Stromberg of Stockholm University and Victor Lei and Wu Yanhui of the University of Hong Kong set out to fill the gap. They tracked 27,000 pupils aged 12-18 in China, where AI adoption has been fast. Around 80% reported using models such as Doubao and DeepSeek; the other 20% formed the control group.

    The results are eye-opening. After six months, pupils using AI saw their average homework score rise by 18% across all subjects. The time they took to complete each assignment fell from an average of 64 minutes to 45. But come exam time, the same students scored 20% below their classmates who had not called on AI’s help. Homework scores once predicted exam performance; now those who score highest are, perversely, more likely to do worse in exams.

    Should schools ban AI? Not necessarily. The drop in exam scores was concentrated among students who rushed their homework. Those who used AI but spent as long on assignments as non-users paid little penalty. What matters, then, is how pupils use the technology. Those whose exam results remained strong were not simply copying and pasting answers to save time. More likely they used the chatbots as a personal tutor, perhaps to explain difficult concepts or help solve specific problems.

    In another new study, Zara Contractor and Germán Reyes of Middlebury College had undergraduates learn about an unfamiliar topic, either with or without the help of a chatbot. Students using AI scored higher on tests, and the advantage persisted when they repeated the task a week later.
    The evidence, though still limited, points one way: AI can boost learning productivity, but only for those who use the technology intelligently. Students must resist the temptation to reach for an AI-generated answer before thinking things through for themselves.

    https://www.economist.com/graphic-detail/2026/08/18/does-ai-stop-children-from-learning
    #AI #IA #intelligence_artificielle #apprentissage #éducation #école #statistiques #chiffres

    via @freakonometrics

    • The Generative AI Learning Penalty: Evidence from Chinese Secondary Education

      Using 30 months of panel data on 26,811 Chinese students in grades 7-12, we study how generative AI affects homework productivity and learning. The data combine monthly closed-book exams, high-school and college entrance exams, and homework scores and completion time across nine subjects. We exploit staggered AI adoption in a difference-in-differences design. AI adoption raises homework scores by 18% and reduces completion time by 30%, but lowers monthly exam scores by 20% within six months. High-stakes entrance-exam scores fall by 18 and 24%, with the full penalty emerging only after about two years. The losses are largest in social science subjects, followed by STEM and languages, and are especially large for junior students, high-achieving students, and boys. The learning losses are concentrated among roughly 80% of AI users whose behavior is consistent with homework outsourcing, as indicated by exceptionally short homework completion time coupled with high homework scores. AI users who maintain similar homework completion time as non-AI users experience small learning losses.

      https://papers.ssrn.com/sol3/papers.cfm?abstract_id=6868618

  • Nuclear power push ramps up uranium mill — and tribal health concerns : NPR
    https://www.npr.org/2026/08/12/nx-s1-5927298/nuclear-power-uranium-health-concerns

    Old Fears Amid a New Uranium Boom

    A U.S. push to ramp up domestic uranium production is bringing new activity to Utah’s White Mesa Mill—and reviving fears among nearby tribes that radioactive waste could contaminate the region’s air and water.

    Driving the boom: Federal policy is accelerating more domestic uranium production amid a ban on Russian uranium imports and the Trump administration’s push to increase nuclear energy capacity.

    The mill plans to more than double production of uranium concentrate, known as yellowcake, this year, and expand waste storage near the White Mesa Ute Community.

    Concerning track record: Tribal members point to the long history of uranium production-related contamination across the Colorado Plateau and a Clean Air Act violation as recent as 2021 as examples of what could transpire amid ramped-up production.

    #Intelligence_artificielle #Uranium #Energie_nucléaire #Nucléaire #Environnement #Nations_autochtones

  • IA et science : du pliage de protéines… à l’illusion de la connaissance
    https://framablog.org/2026/08/09/ia-et-science-du-pliage-de-proteines-a-lillusion-de-la-connaissance

    L’idée que l’IA serait l’avenir de la science comme on l’entend très souvent est bien plus un moyen d’orienter les investissements qu’une vérité scientifique.

    #Enjeux_du_numérique #Intelligence_Artificielle #Claviers_invités #Dans_les_algorithmes #hubert_guillaud #Intelligence_artificielle

  • ShieldFont : la police d’écriture pour bloquer le scraping IA - Numerama
    https://www.numerama.com/tech/2305671-des-designers-creent-une-police-decriture-gratuite-pour-lutter-con

    Avec ShieldFon, lancé fin juillet 2026, un texte reste lisible à l’écran, mais devient trompeur pour les robots qui l’aspirent. Une nouvelle arme typographique contre l’entraînement des IA sur le web.

    • De ce que je comprends, ça utilise une fonctionnalité standard des polices de caractères qui permet de remplacer une suite de lettres par une ligature. Le texte de base est modifié avec de faux mots, mais ces faux mots font partie de la table des ligatures de la police, et lors de son affichage elle fait apparaître les vrais mots en croyant simplement appliquer les ligatures.

    • Voilà une police qui veut compliquer la vie des IA. ShieldFont est un projet gratuit et open source conçu pour protéger les contenus publiés en ligne contre la collecte massive de données par les entreprises d’intelligence artificielle.

      Présenté fin juillet 2026, son principe est simple : le texte reste parfaitement lisible pour un humain, mais sa version récupérée par un robot peut être différente — et suffisamment crédible pour ne pas être écartée immédiatement.

      Le projet s’inscrit dans une réaction plus large contre le scraping du web. Ses créateurs, le studio brésilien Seneda & Abrucio et la fonderie danoise Playtype, partent d’une idée : publier un texte en ligne ne devrait pas automatiquement valoir autorisation de l’utiliser pour entraîner une IA.

      Comment fonctionne ShieldFont ?

      ShieldFont ne repose pas sur une illusion visuelle. À l’inverse de #Ghost_Font, une autre police anti-IA qui dissimule son message dans une animation, celle-ci s’appuie sur les fonctions de substitution des polices #OpenType.

      En pratique, le texte publié dans le code HTML n’est pas le texte que l’auteur souhaite montrer. Il est d’abord encodé : certains mots sont remplacés par d’autres, de même nature grammaticale et de fréquence comparable. La phrase reste donc suffisamment cohérente pour ne pas ressembler à du charabia.

      La police intervient ensuite au moment de l’affichage dans le navigateur. Elle donne aux mots leurres la forme visuelle des mots d’origine. L’internaute lit donc la phrase prévue par son auteur, tandis qu’un scraper qui se contente de récupérer le HTML obtient une autre version du texte.

      Les remplacements ne sont pas choisis au hasard. ShieldFont échange un nom contre un autre nom, un verbe contre un autre verbe, ou encore un adjectif contre un adjectif proche. Le résultat peut rester grammaticalement correct tout en modifiant le sens d’une affirmation.

      Selon la page GitHub du projet, le remplacement d’environ 25 % des mots suffit à altérer sensiblement le texte récupéré par les robots. Dans leurs tests, le texte encodé n’impliquait plus la même chose que l’original pour 55,8 % des articles de presse, 51,9 % des contenus du web général, 34,5 % des œuvres de fiction et 31,1 % des œuvres de fiction anciennes.

      Une limite importante : ShieldFont ne prend actuellement en charge que l’anglais. Le projet prévoit d’étendre ses substitutions à d’autres langues, dont le français.

      Une protection qui a ses limites

      Pour autant, ShieldFont ne bloque pas magiquement tous les robots. Un #scraper qui analyse le rendu visuel d’une page, par capture d’écran et OCR par exemple, peut retrouver le texte réellement affiché. De même, un acteur qui cible spécifiquement un site peut télécharger la police et en reconstituer les correspondances.

      La méthode peut aussi avoir des effets secondaires importants : les moteurs de recherche, les outils de traduction, le copier-coller et les lecteurs d’écran s’appuient eux aussi souvent sur le contenu brut de la page. ShieldFont déconseille ainsi de l’utiliser sur les pages que l’on souhaite faire remonter dans Google.

      Pour eux, finalement, ShieldFont répond surtout à une limite des outils existants : les consignes de « robots.txt » qui demandent aux robots de ne pas explorer un site, restent faciles à ignorer. Plutôt que de compter sur leur bonne volonté, la police cherche ainsi à rendre les contenus aspirés moins exploitables.

      #ShieldFont #typographie #IA #anti-IA #intelligence_artificielle #police #technologie #résistance

    • Effectivement, j’ai un peu creusé et on trouve facilement la liste des ligatures trafiquées  :
      – récupérer la fonte (identifiée avec dev tools/inspect)  : https://shieldfont.org/fonts/shieldfont-alpha-500.woff2
      – la charger dans un analyseur en ligne  : https://fontdrop.info
      – dans le tab ligatures, la liste des mots échangés va apparaître... bien que je soupçonne le site de n’en afficher qu’une partie.

    • Autrement dit : pour masquer un texte pour l’IA, on rend alors le texte entièrement anti-accessible, pour tous les humains qui ont un handicap visuel, et accessible uniquement à celleux qui sont capables de le lire sur écran.

      Dérisoire et inutile, dans 3 mois (ou 6 mois peu importe) des robots sauront le lire aussi.

      Où comment utiliser du temps et de l’énergie pour empirer les problèmes, ou au moins pour rien, alors que le temps et l’énergie ne sont pas infinis et qu’on en a peut-être besoin ailleurs.

    • Pour avoir accompagné les étudiants en création typographique pendant quelques années à l’école Estienne, j’ai pris l’habitude de voir ressurgir des « sujets à la mode » chaque année. Reposant généralement sur l’idée très crédule qu’Opentype allait résoudre les problèmes sociaux de l’humanité et promouvoir les idées progressistes. Pour les soutenances, l’équipe d’enseignants aidait les étudiants à éviter de tomber dans ces sujets bateaux déjà traités les années précédentes. Mais sur internet, évidemment, chacun fait ce qu’il veut, et ça buzze assez facilement parce que les sujets à la mode, hé ben c’est à la mode.

      Bref jusqu’à récemment, on avait droit avec une régularité d’horloge aux polices « inclusives », gros succès d’estime, mais à l’intérêt à mon avis négatif (pour moi : moins lisibles que de simplement mettre un « petit point » dans les mots). Avant, on avait les polices pour économiser l’encre des imprimantes quand tout le monde a commencé à gueuler contre l’arnaque des cartouches d’encre. Et maintenant ce sont les polices prétendument anti-IA.

      Perso, dans les idées à la mode, je préférais quand la mode concernait les polices visant à faciliter la vie des personnes souffrant de divers handicaps visuels/cognitifs, ou pour les enfants en phase d’apprentissage de la lecture, parce que la question de la lisibilité, c’est effectivement une question centrale de la création typographique. Mais quand on prétend résoudre des problèmes de société, justement dans l’air du temps, avec Opentype, je suspecte assez rapidement qu’on va faire dans le bullshit.

    • @rastapopoulos, je ne sais pas ce que ça vaut mais dans leur FAQ il y a ça:
      What about screen readers and accessibility?
      Screen readers read the source code rather than the words displayed by the font, so the current <Shield> component uses aria-hidden to stop the substituted text from being read aloud. We have a built-in alternative, in beta and on by default, which allows users to spawn the real words on the page through an aria button only screen readers reach. The reader’s browser solves a compute-costly puzzle for the key, taking a few seconds. It works in our Dynamic Websites tier and requires JavaScript, which is part of the point: most scrapers never run any. Tested with VoiceOver and an automated screen reader.

    • Accessibilité problématique (on se passe la main droite par dessus la tête pour se toucher l’oreille gauche pour réussir à rendre le texte d’origine visible, mais en bloquant les robots, ce qu’on aurait pu faire dès le départ, c’est un peu le principe d’Anubis), mais aussi tout usage classique d’un texte rendu très casse-gueule. Basiquement : copier-coller.

    • Le projet tel qu’il fonctionne aujourd’hui est effectivement une machine à gaz et alourdi considérablement le poids d’une page, en plus des problèmes d’accessibilité que vous avez pointé, donc ça n’en fait pas une solution à utiliser massivement, mais je trouve l’idée intéressante et qui peut avoir des applications spécifiques.

      Le fait de pouvoir empoisonner subtilement une IA et sans qu’un humain qui l’utiliserait ne puisse facilement s’en rendre compte est assez bien trouvé et je ne connais pas d’autres méthodes pour arriver au même résultat aussi efficacement.

      Pour comparaison, Anubis aussi est une incongruité informatique à se tapper la tête contre les murs de désespoir, mais son utilité n’est pourtant pas à démontrer en 2026.

  • OnlyFans, Deepfakes und Doxing : Wie die Digitalisierung die Sexarbeit verändert
    https://www.berliner-zeitung.de/article/onlyfans-deepfakes-doxing-wie-digitalisierung-sexarbeit-veraendert-

    Sans doute les auteurs de Seenthis sont toutes et tous d’accord que la prostitution est mauvaise et qu’il faut en finir avec les conditions qui encouragent ou imposent l’exercice du travail du sexe. Puisque, je suppose, nous somes seulement dee observateurs superficiels, nos idées et propositions de solutions sont forcément imprécises ou erronnées.

    C’est problématique car les convictions infondées sont á la racine de bien des souffrances et impasses.

    Cet article ajoute plusieurs couches économiques, sociales et technologoques au problème qui risquent de rendre caduques toute approche et position connue. Attention, les secteurs éconiomques illicites ou peu encadrés se révèlent souvent comme précurseurs de changements qui toucheront d’autres domaines après un certain délai. Vu sous cet angle le cas de la prostitution est particulièrement inquiétant.

    31.7.2026 von Markus Keimel - Algorithmen, Social Media und KI verändern Branche und Beruf schneller, als Politik und Recht reagieren können. Die Gründerin einer Escort-Agentur berichtet.

    Dies ist ein Open-Source-Beitrag. Die Berliner Zeitung und die Ostdeutsche Allgemeine geben allen Interessierten die Möglichkeit, Texte mit inhaltlicher Relevanz und professionellen Qualitätsstandards anzubieten.

    „Corona hat die Branche über Nacht gezwungen, sich zu digitalisieren. Wer nicht mitmachte, hatte kein Einkommen. Das war brutal und hat etwas verändert, das nicht mehr rückgängig zu machen ist“, erklärt Leila Sue-Ann Vogler. Die Lüneburgerin ist Gründerin und Betreiberin einer Escort-Agentur. Mit der Digitalisierung von Sexarbeit und den daraus resultierenden Veränderungen ist sie tagtäglich konfrontiert.

    „Die Branche hat in den letzten Jahren einen starken Wandel erlebt, da sich der Marktplatz stark in die digitale Welt verlagert hat. Wer früher auf den richtigen Bordellstandort oder die richtige Straße angewiesen war, braucht heute vor allem ein gutes Profil“, so Vogler. Einschlägige Plattformen haben die klassische Kontaktanbahnung wie etwa im Bordell oder auf dem Straßenstrich weitgehend ersetzt. „Bewertungen, Rankings und Profilbilder entscheiden heute darüber, wer gebucht wird und wer nicht. Wer hier nicht auf die richtige Kombination oder Marketingstrategie setzt, hat schon verloren, bevor es überhaupt zur ersten Kontaktaufnahme kommt“, so Vogler.

    Zwar bringt die Digitalisierung etwas mehr Autonomie für Sexarbeiterinnen mit sich: vor allem bei der Auswahl von Kunden, Arbeitszeiten, Preisen und angebotenen Services. Gleichzeitig aber verschiebt sich eine Form der Abhängigkeit. „Nicht mehr zwingend vom Bordellbetreiber, sondern von Plattformbedingungen, Algorithmen und der permanenten Bedrohung durch Account-Sperrungen. Hinzu kommen neue Risiken wie Stalking und digitale Gewalt – bei gleichzeitig höherer Mobilität und schlechterer Erreichbarkeit für Schutz- und Beratungsangebote“, so die Agenturbetreiberin. Gerade Berlin stehe dabei exemplarisch für diese Hybridisierung: klassische Straßen- und Bordellarbeit mit langer Geschichte trifft auf vollständig digitalisierte Geschäftsmodelle.
    Strukturelles Ausbeutungspotenzial

    Wer heute digital als Sexarbeitender tätig ist, arbeitet in einem System, das eine einzelne Plattform zum Dreh- und Angelpunkt einer gesamten Existenz machen kann. „Die Abhängigkeit von Plattformen ist hoch. Selbst OnlyFans bietet kaum Möglichkeiten, Reichweite aufzubauen. Viele Sexarbeiterinnen sind daher darauf angewiesen, ihre Sichtbarkeit über externe Plattformen wie Instagram oder TikTok zu generieren“, erklärt Benjamin Abt von der Gesellschaft für Sexarbeits- und Prostitutionsforschung.

    Daraus resultiert für Sexarbeitende aber das nächste Problem: Denn Konten, die explizite Inhalte bewerben oder Links zu entsprechenden Inhalten, riskieren dauerhafte Sperren. „Der Verlust eines Instagram-Accounts und die verdeckte Einschränkung der Sichtbarkeit kann somit gleichbedeutend mit dem Verlust der Existenzgrundlage sein“, so Abt.

    Dazu komme ein strukturelles Ausbeutungspotenzial: hohe Provisionen, einseitig durchgesetzte Regeln, keine Mitbestimmung. „Plattformen agieren als Gatekeeper. Das heißt, die Plattformen entscheiden, wer sichtbar ist, wer gesperrt wird, welche Regeln gelten und dies ohne, dass die Sexarbeiterinnen irgendeinen Einfluss darauf haben“, so Vogler.
    Digitale Gewalt gehört inzwischen zum Berufsalltag

    Viele Sexarbeitende betreiben sogenanntes „Camming“, bei der sie Live-Videos über das Internet streamen – meist gegen Bezahlung. Camming erfordert zwar keine physische Begegnung mit Kunden und kann anonym von zuhause aus betrieben werden, ist jedoch mit digitalen und rechtlichen Risiken verbunden.

    Eines davon heißt Doxing und bedeutet das gezielte Sammeln und Veröffentlichen privater Informationen über eine Person ohne deren Einwilligung. Dazu gehören Klarname, Adresse, Fotos, Arbeitgeber oder Familienangehörige. „Im Kontext der Sexarbeit ist dies ein besonders gefährliches Phänomen, da die Verknüpfung von Arbeits- und Privatidentität existenzielle berufliche, familiäre und sicherheitstechnische Konsequenzen haben kann“, sagt Vogler.

    Auch Datenklau und Leaks stellen in der Sex-Cam-Arbeit eine Gefahr dar. Die unerlaubte Veröffentlichung privater oder bezahlpflichtiger Inhalte – oft durch Kunden, die gekauften Content weitergeben, oder durch Hackerangriffe, können für Sexarbeiterinnen massive finanzielle und persönliche Konsequenzen haben.

    Immer häufiger werden auch Deepfakes als Instrument digitaler Gewalt gegen Sexarbeiterinnen eingesetzt. Dabei handelt es sich um KI-generierte Bild- oder Videoinhalte, bei denen das Gesicht einer Person ohne deren Einwilligung in fremde Inhalte eingefügt wird.

    Die Herbertstraße auf St. Pauli ist die bekannteste Bordellgasse Deutschlands.

    Die Herbertstraße auf St. Pauli ist die bekannteste Bordellgasse Deutschlands.

    © Breuel-Bild/Imago
    Permanent online sein – permanent unter Druck sein

    Digitale Sexarbeit wird häufig als eine sicherere oder leichtere Variante wahrgenommen, da es keinen physischen Kontakt gibt oder flexibel von zuhause gearbeitet werden kann. Was dabei übersehen wird: Die psychische Belastung ist erheblich, und sie ist strukturell an das Geschäftsmodell geknüpft. „Wer digital arbeitet, ist permanent sichtbar und permanent erreichbar. Sichtbarkeit ist Kapital und Unerreichbarkeit kostet Ranking“, erklärt Vogler.

    Das Ranking wird durch Faktoren wie Aktivität, Bewertungen, Werbung und Reaktionszeit beeinflusst und wirkt sich direkt auf Sichtbarkeit und Buchungserfolg aus. Das erzeugt einen Dauerstress, der sich kaum abschalten lässt. Hinzu kommt die emotionale Arbeit: Denn digitale Sexarbeit lebt von gespielter Intimität und vom Aufbau scheinbar persönlicher Beziehungen zu fremden Kunden. „Das ist enorm fordernd und es verwischt die Grenze zwischen Arbeit und Privatleben. Burnout ist in der Sexarbeit daher kein Randphänomen, sondern gelebter Alltag“, erzählt die Agenturbetreiberin.
    Das Recht kommt der Digitalisierung nicht hinterher

    Das deutsche Recht denkt Sexarbeit noch weitgehend in physischen Kategorien: also Bordellen, festen Arbeitsorten und dem Prostituiertenschutzgesetz. Doch die digitale Realität hat diesen Rahmen längst überholt. „Online-Plattformen sind rechtlich schwer einzuordnen. Sind sie Werbeportale? Vermittler? Arbeitgeber? Diese Frage ist bis heute nicht eindeutig geklärt, und genau das schafft eine rechtliche Grauzone, in der sich viele Beteiligte bewegen“, so Vogler.

    Internationale Plattformen mit Sitz außerhalb Deutschlands entziehen sich der deutschen Regulierung weitgehend, was zur Folge hat, dass deutsche Gesetze nicht mehr greifen. Gleichzeitig strukturieren diese Plattformen aber den Markt durch Rankings, Bewertungen und Kontaktfilter aktiv mit, schränken die Selbstständigkeit der Sexarbeitenden durch Gebühren und algorithmische Sichtbarkeitssteuerung ein, ohne dafür rechtlich zur Verantwortung gezogen zu werden. „Auch Bereiche wie Cam-Arbeit, der Verkauf von Bildern und Videos oder Sugardating sind ökonomisch längst Teil der Sexarbeit, rechtlich aber kaum definiert“, sagt Vogler.

    Die Sexarbeiterinnen würden sich dadurch in einem rechtlichen Schwebezustand befinden: Was ist erlaubt, was nicht? Wer trägt eigentlich die Verantwortung? Ist es die Plattform oder die Person? „Es gibt kaum institutionellen Schutz und kaum Klarheit. Wer sichtbar ist, um Kunden zu gewinnen, riskiert gleichzeitig aufzufallen, wenn die Registrierungspflicht nicht erfüllt wurde. Mehr Eigenkontrolle bedeutet hier auch ein erhöhtes Eigenrisiko“, klagt die Agenturbetreiberin.

    OnlyFans-Fashion-Show in New York

    OnlyFans-Fashion-Show in New York

    © John Marshall Mantel/Imago
    Künstliche Intelligenz bedroht ganze Branche

    KI-generierte Sexarbeiterinnen – also vollständig synthetisch erzeugte Profile und Inhalte – sind bereits Realität. Vollständig synthetische Profile mit künstlich erstellten Gesichtern, Stimmen und Inhalten konkurrieren auf denselben Plattformen wie echte Menschen. Und sie schlafen nicht, fordern keine Pausen und beschweren sich auch nicht über Arbeitsbedingungen.

    „Das verdrängt echte Sexarbeitende und wirft zudem massive ethische und rechtliche Fragen auf. Wer haftet und wer verdient?“, sagt Vogler. Für reale Sexarbeiterinnen bedeutet dies einen gänzlich neuen und fundamental härteren Konkurrenzdruck. „Während ein Mensch Grenzen hat, also zeitlich, emotional, körperlich, hat eine KI eben keine. Das drückt Preise, erhöht Erwartungen und verändert auch, was Kunden als normal empfinden“, so die Agenturbetreiberin.

    Vor allem rechtliche Fragen beschäftigen die Branche. Wer haftet, wenn ein KI-Profil das Gesicht einer echten Person ohne deren Einwilligung verwendet? Wer verdient an den Inhalten? Sind es die Plattform, der Entwickler oder niemand? „Rechtlich ist das weitgehend ungeklärt“, klagt Vogler. Gleichzeitig wirft KI auch im Bereich der Sexarbeit tiefere ethische Fragen auf: Wenn Intimität vollständig simuliert werden kann, was bedeutet das folglich für menschliche Sexarbeit und menschlichen Intimitätsaustausch? Die Technologie entwickelt sich nahezu schneller als jede gesellschaftliche oder rechtliche Antwort darauf.

    „Was heute noch nach Science-Fiction klingt, ist morgen Marktstandard. Und während Politik und Gesellschaft noch diskutieren, arbeiten echte Sexarbeiterinnen bereits in einer Branche, in der sie zunehmend mit Algorithmen konkurrieren, ohne dass irgendjemand sie gefragt hätte, ob sie das wollen“, so Vogler.
    Wer an der Digitalisierung wirklich verdient

    Die Digitalisierung der Sexarbeit ist kein großer Gleichmacher. „Am meisten profitieren Plattformen und Zahlungsdienstleister. OnlyFans etwa erzielte 2023 einen Bruttoumsatz von über 6,6 Milliarden US-Dollar und behält dabei 20 Prozent aller Einnahmen“, so Abt. Ein erheblicher Teil der Gewinne fließt an Plattformbetreiber. Verlierer sind besonders Sexarbeiterinnen mit mangelnden digitalen Kompetenzen, Sprachbarrieren oder fehlenden finanziellen Reserven: Also genau jene Gruppen, die am stärksten auf Schutz und Unterstützung angewiesen wären. „Wer früher von der Infrastruktur eines Bordells profitierte – etwa durch Planbarkeit, soziale Einbettung, klare Strukturen und Laufkundschaft durch eine etablierte Adresse – steht heute vor einer großen Unsicherheit“, so Vogler.

    Am schlimmsten trifft es Menschen in Zwangs- und Ausbeutungssituationen, da die Digitalisierung diese Situationen noch unsichtbarer macht, und hinter Profilen und Plattformen verschleiert. Zudem verlieren Beratungsstellen und Regulierungssysteme zunehmend den Zugang zu ihren Zielgruppen, da weniger sichtbare Arbeitsorte und weniger Anknüpfungspunkte vorhanden sind.

    Markus Keimel ist freier Journalist, Künstler und Autor aus Österreich.

    #prostitution #mondiialisation #internet #numérisation #ia #intelligence_artoficielle #mafia #disruption

  • La gauche doit-elle céder aux chants des sirènes de l’intelligence artificielle ?
    https://blogs.mediapart.fr/romaric-godin/blog/030826/la-gauche-doit-elle-ceder-aux-chants-des-sirenes-de-l-intelligence-a

    (...)

    « Serviteurs zélés du vide, le vide les paie en monnaie à son effigie », écrivait Debord. Et c’est bien ce qui attend nos techno-solutionnistes de gauche. L’IAG les engloutira, eux et leurs beaux projets, comme elle nous engloutira tous, parce qu’il est ce Moloch créé par les capitalistes pour rendre la vie humaine, le dernier obstacle à la domination de l’abstraction réelle du capital, superflue.

    Le refus actif de l’IAG, de sa « hype », de ses « gains de temps », de ses « solutions », peut être le fondement d’un mouvement social capable de contester l’ordre capitaliste et la destruction qui l’accompagne. Il reste certes à construire, mais il est néanmoins la seule voie cohérente pour résister au désastre qui vient.

  • How to disable or avoid intrusive AI

    One of the biggest questions I get at Drop-In Time at the library (besides “what is taking up all my cloud storage?”) is how to disable or avoid intrusive AI that shows up where people don’t want it. This is a guide for people who would like less intrusive AI in their tech environment. Maybe you like AI and find it useful? That’s fine, this document is probably not for you. Additions/edits welcome. Leave a comment or drop me an email. This page is available at the short URL https://NoToAI.org

    https://www.librarian.net/NoToAI
    #désactiver #alternative #IA #AI #intelligence_artificielle #logiciels #désactivation

  • IA, la grande escroquerie
    https://framablog.org/2026/08/02/ia-la-grande-escroquerie

    Emily Bender et Alex Hanna publient The AI con, « L’escroquerie de l’IA ». Une synthèse très documentée qui nous invite à lutter contre le monde que nous proposent les géants de l’IA. Lecture.

    #Enjeux_du_numérique #Intelligence_Artificielle #Claviers_invités #Dans_les_algorithmes #hubert_guillaud #Intelligence_artificielle